Конспекты Python

Основы Python и ООП
по материалам proproprogs.ru

112 уроков · 27 практик · 2 части

Часть I. Основы Python

Глава 1

Переменные, числа и ввод-вывод

Урок 1 · Часть I. Основы Python

Первое знакомство с Python. Установка на компьютер

Источник: python3-pervoe-znakomstvo-s-python-ustanovka-na-kompyuter

Здравствуйте, дорогие друзья! Рад, что вы начинаете изучать один из самых моих любимых языков программирования Python. Его еще называют Питон. Почему именно Питон? Это нужно спросить у Гвидо ван Россума – главного идеолога и первоначального разработчика этого языка.

Иллюстрация к уроку

Задуман он был еще в 1980-x, а первая версия вышла в 1991 году. Конечно, с тех пор он претерпел множество улучшений, особенно в версии

Python 3.0

выпущенной в декабре 2008 года. Отличия оказались настолько значительными, что программы предыдущих версий 2.x далеко не всегда можно запустить в интерпретаторе Python 3.x. Однако, сейчас это уже не проблема, так как с 2008 года прошло много времени и все важные программы были адаптированы к версии 3. Именно эту последнюю, современную версию языка Python мы с вами и будем изучать.

Язык оказался настолько удачным, что он стал широко применяться при разработке алгоритмов искусственного интеллекта, в частности, в нейронных сетях. При разработке серверной части сайтов, используя известные фреймворки Django и Flask. Например, на нем разработаны сайты Youtube, Instagram, поиск от Google, DropBox и многие другие

Иллюстрация к уроку

Также он используется в многочисленных научных проектах, где требуются сложные математические вычисления или реализация алгоритмов обработки данных, в том числе и больших данных – Big Data. В последнее время Python стали применять также и для создания игр, обычно мобильных. А если вы еще школьник, то этот язык ввели в ОГЭ и ЕГЭ по информатике, а также в олимпиадное программирование.

Но, все же, почему этот язык приобрел такую широкую популярность и завоевал любовь программистов по всему миру? Считается, что все благодаря его простым, понятным, явным конструкциям, хорошо читаемому тексту программ, богатой библиотеке модулей для программирования самых разных задач и возможность использования языка практически на всех платформах: Windows, Linux, Mac OS, Android, iOS и др. Хотя, на самом деле понять, почему один проект «выстреливает», а большинство уходят в небытие, еще никому не удалось. Но Питон – это яркая история успеха, правда, не лишенный и своих недостатков. Главные из них – более медленная скорость работы программ и больший объем используемой памяти, по сравнению, например, с аналогичным кодом, написанном на языке С++. Но, все же, Python позволяет заметно быстрее реализовывать сложные алгоритмы и этим качеством он затмевает большинство современных языков программирования. А скорость работы критического фрагмента кода можно увеличить, если реализовать его на том же С++, а затем, вызывать из Python-программы. Например, так делается при проектировании и обучении нейронных сетей. Благодаря этому получаем удобство программирования и высокую скорость исполнения.

Установка языка Python

Давайте теперь выполним установку интерпретатора этого языка на свое устройство. У меня – это стационарный компьютер с ОС Windows 10. Если я нажму клавиши Win + Pause, то появится окно с подробной информацией о системе. В частности, здесь написано название ОС и ее разрядность x64. Конечно, у вас может быть любое другое устройство и ОС – это не существенно, в любом случае, нам нужно перейти на официальный сайт языка Python:

https://www.python.org

Затем, выбрать вкладку «Downloads» и здесь появится список различных ОС. Вам нужно найти свою ОС и перейти. Так как у меня Windows, то я выбираю этот пункт и появляется страница с выбором различных версий языка. Конечно же, следует взять последнюю стабильную для Python 3. На момент записи видео – это версия 3.9.5. Я скачаю 64-bit версию установщика:

Download Windows installer (64-bit)

так как у меня ОС Windows 64-разрядная (обычно, именно такая и установлена на домашнем компьютере). И запущу его. Появится окно, в котором обязательно следует отметить галочкой опцию «Add Python to PATH». Она позволит в дальнейшем запускать интерпретатор языка без указания полного пути к нему:

Иллюстрация к уроку

Затем, выбираем режим установки «Customize installation». Здесь все опции должны быть отмечены галочками:

Иллюстрация к уроку

Нажимаем «Next» и в следующем окне я рекомендую путь, который прописан по умолчанию, изменить на другой. А именно, убрать все промежуточные подкаталоги и установить интерпретатор в корень выбранного диска:

Иллюстрация к уроку

У меня получился путь «C:\Python39». Здесь дополнительно указана версия языка 3.9. Это также рекомендуется делать, так как разных версий на одном устройстве может быть несколько и чтобы переключаться между ними, они должны находиться в разных директориях.

После этого, нажимаем на кнопку «Install» и программа устанавливается в указанный каталог.

Осталось проверить работоспособность языка Python. Во-первых, мы можем открыть окно выполнения команд в ОС Windows (Win+R) и в появившемся окне набрать «cmd»:

Иллюстрация к уроку

Далее, в консольном командном окне набираем «python» и должны увидеть текущую версию интерпретатора этого языка:

Иллюстрация к уроку

Если вы работаете под Linux или Mac OS, то следует набрать команду «python3».

Но писать и исполнять команды самого языка лучше через среду IDLE, которая устанавливается вместе с интерпретатором. Для ее запуска достаточно нажать на кнопку «Пуск» и выбрать оболочку IDLE. Появится окно, в котором можно в интерактивном режиме выполнять любые команды языка. Например, математические

2+4
3*5
8/6

Мы о них еще подробно будем говорить. Здесь я просто привожу пример и показываю, как выполняются простейшие команды языка Python.

На этом мы с вами завершим наше первое занятие. В качестве самостоятельного задания вам нужно установить интерпретатор языка на свое устройство (желательно, чтобы оно имело полноценную клавиатуру и манипулятор «мышь»). И попробуйте выполнить в среде IDLE те же самые команды, что я привел в этом видео. До встречи на следующем занятии!

Урок 2 · Часть I. Основы Python

Варианты исполнения команд. Переходим в PyCharm

Источник: python3-varianty-ispolneniya-komand-perehodim-v-pycharm

Здравствуйте, дорогие друзья! Мы продолжаем курс по Python. На этом занятии вы узнаете о двух вариантах исполнения команд: интерактивном и файловом, а также затронем функцию print() для отображения данных в консоли Питона.

Я, надеюсь, вы все успешно установили интерпретатор языка на свое устройство и смогли повторить команды из прошлого занятия в среде IDLE. Так вот, это, как раз интерактивный режим их выполнения, когда каждая конструкция языка отрабатывает сразу же после нажатия на кнопку Enter.

Преимущество такого подхода – мгновенное получение требуемого результата. Это бывает полезно при отладке программы, чтобы, например, быстренько посмотреть значения текущих данных и сделать для себя некоторые выводы.

Недостаток интерактивного режима – потеря ранее записанных команд. Например, если перезапустить IDLE, то все ранее написанное пропадает, не сохраняется. Поэтому писать полноценные программы в таком режиме не получится.

Для этого следует использовать другой, файловый режим исполнения команд. В оболочке IDLE это делается так. Выбираем меню File, затем, New File и у нас появляется второе окно. Здесь можно написать сразу несколько команд:

2+3
8/3
5*6

Сохранить их в файл и, затем, выполнить программу (F5). Результат должен отображаться в командном окне IDLE. Но мы ничего не видим. Почему? Дело в том, при файловом режиме команды выполняются строчка за строчкой, то есть, последовательно, сверху-вниз, но результаты автоматически не отображаются, как это происходит в интерактивном режиме. Можно подумать, что это плохо. Возможно, мы хотели увидеть результат действия наших арифметических операций? Однако, это разумное поведение интерпретатора. Часто целью программ является не вывод всех промежуточных результатов, а только требуемого конечного значения. Но как его вывести? Для этого в языке Python существует специальная функция print(). Если все наши арифметические операции записать в виде:

print(2+3)
print(8/3)
print(5*6)

то в консоли увидим три строчки, три вывода. В интерактивном режиме, кстати, она работает абсолютно также – выводит некоторое сообщение в консоль. На данный момент, просто запомните, то, что находится внутри круглых скобок функции print(), та информация и выводится. Причем, эту функцию можно записать и с пустыми скобками:

print()

Тогда просто отобразится пустая строка. Также можно просто указать число:

print(5)
print(5.6)

или строку:

print("hello")

Пока это просто демонстрация возможностей функции print(). Подробнее мы о ней еще поговорим. А до тех пор будем использовать в таком простом виде.

Форматирование текста программ

Давайте вернемся к нашей программе. Как я уже говорил, конструкции выполняются последовательно сверху вниз. Причем, все они должны иметь единый нулевой начальный отступ от левого края. Если добавить перед print() хотя бы один пробел, то возникнет ошибка форматирования текста программы. Питон очень требователен к формату записи текста программы. И первое, что здесь нужно запомнить, - все начальные конструкции языка должны записываться без отступов слева и каждый print следует начинать с новой строчки. Это правила руководства PEP 8 по рекомендациям оформления текста программы на Python:

https://www.python.org/dev/peps/pep-0008/

Как видите, это достаточно объемный документ. Я буду стараться придерживаться его указаний и делать оформление программ в соответствии с ним, чтобы вы также приучались к правильному стилю оформления.

На данный момент достаточно запомнить, что все начальные конструкции языка записываются без отступов слева и каждая с новой строки. Конечно, для ясности и лучшей читаемости текста, можно добавлять пустые строки, например, так:

print(2+3)
print(8/3)
 
print(5*6)

Давайте еще раз подведем итог:

  • программа исполняется последовательно сверху-вниз;
  • текст программы следует оформлять в соответствии с PEP 8;
  • начальные отступы слева у команд должны отсутствовать, а каждая команда записана с новой строки.

Интегрированная среда PyCharm

В заключение этого занятия я хочу познакомить вас с интегрированной средой программирования PyCharm, разработанной специальной для написания программ на Python. Она намного удобнее IDLE, с которой вы уже немного знакомы, поэтому все дальнейшие действия я буду выполнять в PyCharm.

Я рекомендую вам также ее установить, хотя это не обязательное действие, так как все программы курса можно будет выполнять и в IDLE. Но, как говорится: лучше один день потерять, чтобы потом за пять минут долететь. Поэтому, лучше затратить немного времени на установку PyCharm, чтобы потом стало проще и приятнее писать программы на Python.

Вначале нам нужно перейти на официальный сайт программы:

https://www.jetbrains.com/pycharm/

и скачать бесплатную версию «Community». Для решения большинства задач ее будет вполне достаточно. Затем, скачиваем приложение для установки PyCharm. Запускаем его, нажимаем «Next», выбираем каталог размещения программы, отмечаем, что хотим создать ярлык на рабочем столе и привязать расширение py к данной среде, нажимаем «Next» и, затем, «Install».

После установки программа предложит запустить PyCharm. Запускаем. Появляется окно для импортирования настроек из предыдущей версии (если она была). Я этот шаг пропущу «Do not import settings». В следующем окне мы выбираем тему оформления. Я выберу темную. Вы можете выбрать другую – это дело вкуса. Далее, нажимаем на кнопку «Skip Remaining and Set Defaults» пропустить все напоминания и сделать дальнейшие установки по умолчанию.

Здесь при первом запуске необходимо создать новый проект. Нажимаем «Create New Project». В поле «Location» указывается расположение проекта и его имя. Пусть проект называется «stepik». Раскрываем вкладку «Project interpreter» интерпретатор проекта, здесь укажем существующий интерпретатор. Если его в списке нет, то нажмите вот на это троеточие и в новом окне выберите «System Interpreter». В этом списке отображаются все интерпретаторы, установленные на компьютере. Но я оставлю тот, что был найден по умолчанию. Нажимаем кнопку «Create» и создаем проект. Перед нами откроется окно PyCharm. Слева отображается структура проекта. Пока он не содержит ни одного файла с текстом программы. Создадим его. Нажимаем правую кнопку мыши, выбираем «New» -> «Python File». Вводим имя файла, например, ex1 и этот файл автоматически добавляется в наш проект. Здесь мы будем писать тексты программ, например, так:

print("Hello World!")

Далее, для запуска можно выбрать в меню «Run» -> «Run ex1», программа начнет выполняться и внизу появится результат ее работы. Однако, удобнее пользоваться «горячими клавишами» для выполнения типовых команд. В частности для запуска проекта можно нажать комбинацию клавиш:

  • при первом запуске: Ctrl+Shift+F10
  • при повторных запусках: Shift+F10

Пока этого функционала нам будет вполне достаточно. По мере работы с PyCharm, вы будете знакомиться с его возможностями и совсем скоро, сами не заметите, как станете с ним одним целым.

На этом мы с вами завершим наше второе занятие. В качестве самостоятельного задания установите среду PyCharm и попробуйте выполнить простую программу из этого урока. До встречи на следующем занятии!

Урок 3 · Часть I. Основы Python

Переменные, оператор присваивания, функции type и id

Источник: python3-peremennye-operator-prisvaivaniya-funkcii-type-i-id

На данный момент, мы с вами установили сам язык и научились запускать программы в средах IDLE и PyCharm. Пришла пора сделать первый шаг непосредственно в программирование. Вначале, давайте попробуем понять, что вообще могут делать компьютерные программы? В самой основе, совсем немного:

  • хранить данные;
  • выполнять арифметические операции;
  • проверять логические условия (операторы ветвления);
  • реализовывать циклы.

Фактически, на комбинации этих блоков и выстраивается логика всех программ. Мы с вами последовательно познакомимся с каждым из них. Начнем с самого первого – способа представления и хранения данных в Python.

Переменные и оператор присваивания

Как же данные представляются в Python? Условно, это можно представить так. Есть некое хранилище (мы его будем называть объектом) и в нем могут располагаться или числа, или строки, или, какие-либо другие типы данных. Причем в объекте может быть что-то одно: или число, или строка. Одновременно и число и строка находиться в одном хранилище не могут.

Иллюстрация к уроку

Таких хранилищ в программе может быть огромное количество. И как нам тогда обратиться к нужному и взять оттуда данные? Все просто. Для этого у нас должна быть ссылка на объект и мы обращаемся к хранилищу по имени этой ссылки. Такие ссылки называются переменными.

Иллюстрация к уроку

Как нам создать объект с некоторым содержимым и ссылкой на него? Тоже очень просто. Достаточно придумать имя переменной и через оператор присваивания связать ее с нужным объектом, например, так:

a = 7

В результате, интерпретатор языка Python создаст ссылку с именем a и объектом с целым числом 7. Мы в этом можем легко убедиться, если выведем содержимое объекта по этой ссылке (по переменной a):

print(a)

Еще раз обратите внимание на оператор присваивания. В программировании он связывает операнд слева с операндом справа:

операнд слева = операнд справа

Например, строчка:

var_a = "Панда"

Иллюстрация к уроку

создает переменную с именем var_a, которая ссылается на объект со строкой «Панда». И, смотрите, здесь именно создается переменная var_a, так как до этого она не существовала. К несуществующим переменным мы обращаться не можем. Например, строчка:

print(x)

приведет к ошибке, так как переменную с именем x мы нигде не создавали. Но если переменная уже была создана и мы снова присваиваем ей какое-либо значение:

a = 6.8

Иллюстрация к уроку

то она второй раз уже не создается. Но как будет работать эта строчка? Здесь создается новый объект со значением 6.8 и на него инициализируется уже существующая переменная. Если на прежний объект 7 нет других ссылок, то он автоматически удаляется из памяти устройства. При этом переменная a начинает ссылаться на другой тип данных – вещественное число (до этого было целочисленное значение). То есть, тип переменной определяется в момент присваивания ей того или иного значения. В программировании это называется динамической типизацией. В противовес статической типизации, когда тип переменной указывается в момент ее объявления. Например, так делается в языках C++ или Java

Но, вернемся к оператору присваивания. Давайте посмотрим, что будет, если связать одну переменную с другой:

b = a

Иллюстрация к уроку

Теперь обе переменные будут ссылаться на один и тот же объект. То есть, копирования данных (создание нового объекта) не происходит, копируется лишь ссылка на объект. И это важный момент, который хорошо следует запомнить и понимать! В языке Python переменные не хранят значения, а лишь ссылаются на них. Как раз, благодаря этому можно одной и той же переменной присваивать самые разные типы данных:

b = "Hello"
b = 0
b = -8.4

Это очень удобно при программировании. Но при этом всегда следует помнить, что переменная – это всего лишь ссылка на данные, а не сами данные.

Иногда, в программах можно встретить вариант каскадного присваивания :

a = b = c = 0

Иллюстрация к уроку

В результате выполнения такой команды, все три переменные будут ссылаться на один и тот же объект со значением 0.

Если же мы хотим, чтобы каждая переменная ссылалась на свой отдельный объект, то можно воспользоваться множественным присваиванием :

a, b = 1, 2

Иллюстрация к уроку

Здесь переменная a будет ссылаться на 1, а b – на 2. Используя такую команду, можно легко и просто выполнить операцию обмена значениями между двумя переменными:

a, b = b, a

Функция type()

Так как в программе переменные могут иметь самые разные типы данных, то как можно узнать текущий тип, на который они ссылаются? Для этого в Python имеется специальная встроенная функция type(), возвращающая тип данных, связанный с указанной переменной:

print(type(a))

В консоли увидим целочисленный тип данных (int). Давайте объявим еще две переменные:

x = 5.8
s = "Hello"

И выведем для них типы:

print(type(x), type(s))

Увидим float и str. Здесь у вас может возникнуть вопрос, а какие типы данных вообще существуют в Python? Конечно, я бы мог здесь привести список всех типов, но на данном этапе – это избыточная, справочная информация. По мере прохождения курса, мы с вами познакомимся со всеми встроенными типами и постепенно у вас сложится общее представление. Это будет гораздо эффективнее, чем отображение больших и умных таблиц, которые, все равно, не воспринимаются и быстро забываются.

Правильные имена переменных

Последнее, о чем я хочу вам рассказать на этом занятии – как правильно выбирать имена переменных. Есть несколько простых правил:

  1. Имена следует брать существительными (отвечают на вопросы: кто, что).
  2. Имена должны быть осмысленными и отражать суть данных.
  3. Допустимые символы в именах: первый символ – любая буква латинского алфавита a-z, A-Z и символ подчеркивания _. В качестве второго и последующих символов еще цифры 0-9.

Например:

msg = "Сообщение"
count = 0

Причем, обратите внимание, переменные:

arg = 0
Arg = 0

Это две разные переменные, так как малая буква ‘a’ и большая ‘A’ – разные символы, а значит, имена тоже разные. Также нельзя использовать ключевые слова языка Python в качестве имен, например, писать:

True = 5

Полный их список можно посмотреть с помощью вызова в консоли функции:

help()

а, затем, набрать:

keywords

Также не следует использовать имена стандартных функций в качестве переменных. Например, если переопределить имя функции:

print = 5

то оно теперь будет ссылаться не на функцию для печати значений, а на числовой объект 5. И если, затем, попытаться вызвать функцию:

print(6)

то возникнет ошибка, так как мы, фактически, пытаемся выполнить объект, содержащий число 5. Но Python делать этого не умеет (по крайней мере, по умолчанию). Поэтому имена функций стандартной библиотеки языка Python не следует использовать в качестве имен переменных.

Но как нам узнать, является ли какое-либо имя встроенной функцией? Очень просто. Все зарезервированные имена, будь то функции или ключевые слова, автоматически подсвечиваются интегрированными средами и так подсказывают нам, что это имя уже имеет свою функциональность и его лучше не трогать. Со временем, вы запомните все наиболее употребительные имена языка Python и будете знать, какие имена лучше не использовать для собственных переменных.

На этом мы завершим наше очередное занятие. Надеюсь, вы теперь понимаете, что из себя представляют переменные в языке Python, как они связываются с данными и как работает оператор присваивания. Для закрепления этого материала обязательно выполните практические задания и переходите к следующему уроку!

Урок 4 · Часть I. Основы Python

Числовые типы, арифметические операции

Источник: python3-chislovye-tipy-arifmeticheskie-operacii

На этом занятии мы поподробнее поговорим о представлении чисел и арифметических операциях над ними.

В Питоне имеются три базовых типа для представления чисел:

  • int – для целочисленных значений;
  • float – для вещественных;
  • complex – для комплексных.

Мы затронем первые два: int и float. Первый целочисленный тип представляет собой, следующие числа:

0, 1, 2, 100, 6697959484, -1, -2, -7567658

Python поддерживает работу с очень большими числами, поэтому у вас, скорее всего не возникнет проблем с выходом за пределы диапазона.

Вещественные числа, то есть, дробные записываются через точку, например, так:

6.8, -5.567, 345.546, -65467.99

Здесь также довольно широкий диапазон значений, достаточный для большинства практических задач.

Основные арифметические операции

Пока такого понимания чисел будет вполне достаточно. Следующим шагом, нам с вами нужно научиться делать арифметические операции над ними. Что это за операции? Базовыми из них являются, следующие:

Оператор Описание Приоритет
+ сложение 2
- вычитание 2
* умножение 3
/, // деление 3
% остаток деления 3
** возведение в степень 4

Давайте, я поясню их работу на конкретных примерах. Перейдем в консоль языка Python, чтобы выполнять команды в интерактивном режиме. Так будет удобнее для демонстрации возможностей вычислений. В самом простом варианте мы можем просто сложить два целых числа:

2+3

Получим результат 5. Но этот результат у нас нигде не сохраняется. Чтобы иметь возможность делать какие-либо действия с пятеркой, ее следует сохранить через переменную, например, вот так:

a = 2+3

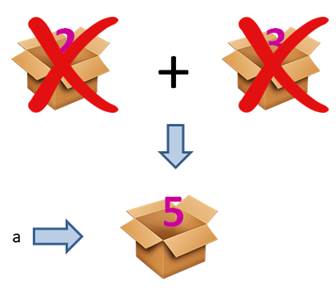
Теперь a ссылается на объект с числом 5. Давайте разберемся, как работает эта строчка. Сначала в Python создаются два объекта со значениями 2 и 3. Оператор сложения берет эти значения, складывает их и формирует третий объект со значением 5. А, затем, через оператор присваивания, этот объект связывается с переменной a. В конце, если на объекты 2 и 3 не ссылаются никакие другие переменные, они автоматически удаляются из памяти сборщиком мусора.

Иллюстрация к уроку

Возможно, вас удивило, что при такой простой операции сложения двух чисел выполняется столько шагов. Но в Python реализовано все именно так. И это справедливо для всех арифметических операций. Мало того, раз операция сложения возвращает объект с результатом, то можно сделать и такое сложение из трех чисел:

b = 2+3+4

И так далее, можно записать сколько угодно операций сложения в цепочку.

Давайте теперь сложим целое число с вещественным:

c = 2 + 3.5

Очевидно, что результат получается тоже вещественным. Отсюда можно сделать вывод, что сложение целого числа с вещественным всегда дает вещественное значение.

А вот при делении двух любых чисел, мы всегда будем получать вещественное число (даже если числа можно разделить нацело):

d1 = 8 / 2
d2 = 3 / 6

Если же нам нужно выполнить деление с округлением к наименьшему целому, то это делается через оператор:

d3 = 7 // 2

На выходе получаем значение 3, так как оно является наименьшим целым по отношению к 3,5. Обратите внимание, что при делении отрицательных чисел:

d3 = -7 // 2

получим уже значение -4, так как оно наименьшее по отношению к -3,5. Вот этот момент следует иметь в виду, применяя данный оператор деления.

Следующий оператор умножения работает очевидным образом:

5 * 6
2 * 4.5

Обратите внимание, в последней операции получим вещественное значение 9.0, а не целое 9, так как при умножении целого на вещественное получается вещественное число.

Давайте теперь предположим, что мы хотим вычислить целый остаток от деления. Что это вообще такое? Например, если делить

10 : 3

то остаток будет равен 1. Почему так? Все просто, число 3 трижды входит в число 10 и остается значение 10 - 3∙3 = 1. Для вычисления этого значения в Python используется оператор:

10 % 3

Если взять:

10 % 4

то получим 2. Я думаю, общий принцип понятен. Здесь есть только один нюанс, при использовании отрицательных чисел. Давайте рассмотрим четыре возможные ситуации:

9 % 5   # значение 4
-9 % 5  # значение 1
9 % -5  # значение -1
-9 % -5 # значение -4

Почему получаются такие значения? Первое, я думаю, понятно. Здесь 5 один раз входит в 9 и остается еще 4. При вычислении -9 % 5 по правилам математики следует взять наименьшее целое, делящееся на 5. Здесь – это значение -10. А, далее, как и прежде, вычисляем разность между наименьшим, кратным 5 и -9:

-9 – (-10) = 1

При вычислении 9 % -5, когда делитель отрицательное число, следует выбирать наибольшее целое, кратное 5. Это значение 10. А, далее, также вычисляется разность:

9 – 10 = -1

В последнем варианте -9 % -5 следует снова выбирать наибольшее целое (так как делитель отрицателен), получаем -5, а затем, вычислить разность:

-9 – (-5) = -4

Как видите, в целом, все просто, только нужно запомнить и знать эти правила. Кстати, они вам в дальнейшем пригодятся на курсе математики.

Последняя арифметическая операция – это возведение в степень. Она работает просто:

2 ** 3  # возведение в куб
36 ** 0.5  # 36 в степени 1/2 (корень квадратный)
2 ** 3 ** 2 # 2^3^2 = 512

В последней строчке сначала 3 возводится в квадрат (получаем 9), а затем, 2 возводится в степень 9, получаем 512. То есть, оператор возведения в степень выполняется справа-налево. Тогда как все остальные арифметические операции – слева-направо.

Приоритеты арифметических операций

Давайте теперь посмотрим, что будет, если выполнить команду:

27 ** 1/3

Получим значение 9. Почему так произошло? Ведь кубический корень из 27 – это 3, а не 9? Все дело в приоритете арифметических операций (проще говоря, в последовательности их выполнения). Приоритет у оператора возведения в степень ** - наибольший. Поэтому здесь сначала 27 возводится в степень 1, а затем, 27 делится на 3. Получаем искомое значение 9.

Если нам нужно изменить порядок вычисления, то есть, приоритеты, то следует использовать круглые скобки:

27 ** (1/3)

Теперь видим значение 3. То есть, по правилам математики, сначала производятся вычисления в круглых скобках, а затем, все остальное в порядке приоритетов.

Приведу еще один пример, чтобы все было понятно:

2 + 3 * 5    # 17
(2 + 3) * 5  # 25

То есть, приоритеты работают так, как нас учили на школьных уроках математики. Я думаю, здесь все должно быть понятно. Также не забывайте, что все арифметические операторы выполняются слева-направо (кроме оператора возведения в степень), поэтому в строчке:

32 / 4 * 2

сначала будет выполнено деление на 4, а затем, результат умножается на 2.

Дополнительные арифметические операторы

В заключение этого занятия рассмотрим некоторые дополнения к арифметическим операторам. Предположим, что у нас имеются переменные:

i = 5
j = 3

И, далее, мы хотим переменную i увеличить на 1, а j – уменьшить на 2. Используя существующие знания, это можно сделать, следующим образом:

i = i + 1
j = j - 2
print(i, j)

Но можно проще, используя операторы:

i += 1
j -= 2

Результат будет прежним, но запись короче. Часто, в таких ситуациях на практике используют именно такие сокращенные операторы.

То же самое можно делать и с умножением, делением:

i *= 3
j /= 4
print(i, j)

и другими арифметическими операторами.

На этом мы завершим наше занятие. Надеюсь, вам были понятны действия с арифметическими операторами. Как всегда, не забывайте проходить практику для закрепления материала и жду вас всех на следующем уроке.

Урок 5 · Часть I. Основы Python

Математические функции и работа с модулем math

Источник: python3-matematicheskie-funkcii-i-rabota-s-modulem-math

На этом занятии речь пойдет о наиболее употребительных математических функциях.

Первая встроенная функция abs() позволяет вычислять модуль чисел (из отрицательных делает положительные):

abs(-5)

То есть, для вызова функции нужно записать ее имя и в круглых скобках указать аргумент. Чтобы сохранить модуль того или иного числа, результат следует присвоить переменной:

a = abs(-5.6)

Если же передать положительное число, то оно просто возвращается данной функцией:

abs(1.5)

Следующая функция min() выбирает минимальное значение среди переданных ей чисел:

min(1, 2, 3, 0, -5, 10)

А, противоположная ей функция max() – ищет максимальное значение:

max(1, 2, 3, 0, -5, 10)

Число аргументов у этих функций может быть произвольным, но не менее одного. То есть, запись вида:

max()

приведет к ошибке, т.к. не указан ни один аргумент.

Следующая функция pow() возводит числа в указанную степень:

pow(6, 2)

Это аналог оператора:

6 ** 2

Или, с дробными значениями:

pow(27, 0.5)
pow(27, 1/3)

Последняя встроенная функция, которую мы рассмотрим – это round() для округления чисел:

round(0.5)
round(0.51)

У этой функции имеется второй необязательный параметр, указывающий точность округления. Если, например, записать:

round(7.8756, 2)

то число округляется с точностью до сотых (два знака после запятой). Если же указать отрицательное значение:

round(7.8756, -1)

то округление происходит до десятков. Или округление до сотен и тысяч:

round(78756, -2)
round(78756, -3)

Следующая возможность при работе с функциями – это вызов одной из другой. Например, запись вида:

max(1, 2, abs(-3), -10)

вернет значение 3, так как вначале вызываются функции в аргументах, а затем, сама функция max. Вложенность можно делать любой глубины, например:

max(1, 2, abs(min(10, 5, -3)), -10)

Модуль math

Некоторые из вас могут заметить, что я привел достаточно ограниченный набор математических функций. Конечно, в Python есть и другие. Чтобы ими воспользоваться, нужно импортировать специальный модуль math:

import math

Пока просто запомните эту команду. Об импорте мы еще будем подробнее говорить. Итак, после ее выполнения у нас появляется дополнительный набор общеупотребительных функций, которые можно просмотреть так:

math.

Я отмечу наиболее используемые, а остальные применяются по аналогии.

Для округления до наибольшего целого:

math.ceil(5.2)
math.ceil(-5.2)

Для наименьшего целого:

math.floor(5.99)
math.floor(-3.3)

Факториал числа:

math.factorial(6)

Отбрасывание дробной части:

math.trunc(5.8)

Это аналог встроенной в Python функции:

int(5.8)

Далее, логарифм по основанию 2, 10 и произвольный:

math.log2(4)
math.log10(100)
math.log(2.7)
math.log(27, 3) # по основанию 3

Вычисление квадратного корня:

math.sqrt(49)

Также имеется полный набор тригонометрических функций, например:

math.sin(3.14/2)
math.cos(0)

Помимо этого есть, следующие константы:

math.pi
math.e

Этих представленных функций нам пока будет вполне достаточно. Для закрепления материала выполните практические задания и жду вас на следующем уроке.

Урок 6 · Часть I. Основы Python

Функции print() и input(). Преобразование строк в числа int() и float()

Источник: python3-funkcii-print-i-input-preobrazovanie-strok-v-chisla-int-i-float

На этом занятии речь пойдет о двух распространенных функциях:

  • print() – вывод данных в консоль;
  • input() – ввод данных из стандартного входного потока (часто клавиатуры).

Функция print()

О функции print() мы с вами уже немного говорили, и вы видели ее использование в самых простых ситуациях, например:

print(1)

или

print(3, 5, 7)

выведет указанные значения через пробел. Также можно выводить отдельные переменные:

a = -6.84
print(a)

результаты арифметических операций:

print(a * 2 + 3)

или функций:

print(abs(a * 2 + 3))

Но у этой функции имеется два необязательных именованных параметра, которые довольно часто используются в практике программирования:

  • sep – разделитель между данными;
  • end – завершающий символ или строка.

Давайте я покажу на примере работу этих параметров. Предположим, мы выводим три переменные:

a = -6.84
b = 7
c = 25.6
print(a, b, c)

Как видите, между ними автоматически добавляется пробел. Но этот символ можно поменять через параметр sep, например, так:

print(a, b, c, sep=" | ")

Соответственно, чтобы параметр sep «сработал», необходимо хотя бы два аргумента в функции print(). Если указать, например, один:

print(a, sep=" | ")

то здесь разделять нечего и он будет проигнорирован. А вот для двух переменных уже появится вертикальная черта:

print(a, b, sep=" | ")

Второй параметр end задает окончание строки вывода и по умолчанию:

end = ‘\n’

переводу на следующую строку. Это такой спецсимвол, о которых мы также еще будем говорить. Так вот, благодаря такому параметру end два последовательных вызова функции print() напечатают текст с новой строки:

print("Hello")
print("World!")

Но если в первой функции print() добавить этот параметр с пробелом:

print("Hello", end=' ')
print("World!")

то увидим в одной строчке оба слова. Разумеется, здесь параметр end с пробелом применяется только к первому print(). У второго он уже берется по умолчанию с переносом строки.

Последнее, что я хочу рассказать о функции print() – это способ вывода форматированной информации в консоль. Давайте предположим, что у нас имеются две переменные (координаты точки) x и y:

x = 5.76
y = -8

И мы хотим вывести их в формате:

«Координаты точки: x = 5.76; y = -8»

Сделать это можно несколькими способами. Первый, самый очевидный, записать все через запятую:

print("Координаты точки: x = ", x, "; y = ", y)

Но, начиная с версии Python 3.6, появилась возможность использовать специальные F-строки. О них мы также еще будем говорить, но здесь я приведу простой пример и вы уже сейчас сможете применять этот механизм в своих программах. Запишем функцию print(), следующим образом:

print(f"Координаты точки: x = {x}; y = {y}")

Смотрите, здесь перед строкой ставится специальный символ f, указывающий, что это будет F-строка. А, в самой строчке внутри фигурных скобок мы можем записывать любые конструкции языка Python. В данном случае, я просто указал переменные x и y. Видите, как это просто, наглядно и удобно. Сейчас практически всегда используются F-строки для форматированного вывода информации.

Функция input()

Вторая функция input() служит для ввода информации, как правило, с клавиатуры. В самом простом варианте ее можно вызвать так:

a = input()

При этом переменная a будет ссылаться на строку:

print(type(a))

И это важный момент: функция input() всегда возвращает строку. На что это может повлиять? Например, мы хотим вычислить модуль введенного числа:

a = input()
b = abs(a)

При вызове функции abs() возникнет ошибка, так как в качестве ее аргумента должно быть число, а не строка. Как решить эту проблему? Очень просто. Если мы знаем, что пользователь должен ввести число, предположим, целое число, то можно воспользоваться функцией:

a = "54"
b = int(a)

Теперь b будет ссылаться на число 54, а не строку. И наша программа примет вид:

a = input()
a = int(a)
b = abs(a)
print(b)

Здесь первые две строчки можно объединить и записать их так:

a = int(input())

Но функция int() преобразовывает только целые числа. Если в строке будет хотя бы один не цифровой символ:

int("64.56")

возникнет ошибка. То есть, в нашей программе пользователь обязательно должен вводить целые числа. А как тогда преобразовывать вещественные значения? Для этого есть другая функция:

float("64.56")

Поэтому, когда на входе ожидаются вещественные данные, то следует использовать именно ее:

a = float(input())
b = abs(a)
print(b)

Давайте напишем программу для вычисления периметра прямоугольника. Пользователь будет вводить два числа (стороны прямоугольника), а мы, затем, вычислим периметр:

a = float(input())
b = float(input())
print("Периметр:", 2 * (a + b))

Как видите, все достаточно просто. Мы вводим первое число, нажимаем Enter и вводим второе число. Вводить два числа через пробел здесь нельзя, иначе получится строка с двумя числами, разделенные пробелом и ее нельзя будет преобразовать функциями int() и float().

Также в этой программе пользователю совершенно непонятно, что нужно вводить. Давайте добавим подсказки. Для этого в функции input() первым аргументом передается строка:

a = float(input("Введите длину прямоугольника: "))
b = float(input("Введите ширину прямоугольника: "))
print("Периметр:", 2 * (a + b))

Теперь стало гораздо понятнее, что нужно вводить.

Забегая вперед отмечу, что в Python можно выстроить конструкцию для ввода значений через пробел. Это делается так:

a, b = map(float, input("Введите две стороны прямоугольника: ").split())

Здесь к каждому введенному значению применяется функция float() для преобразования в вещественные числа. Пока просто запомните эту конструкцию, в дальнейшем она станет понятной, когда мы изучим строки и функцию map().

Или, для ввода целых чисел, она будет принимать вид:

a, b, c = map(int, input("Введите три целых числа: ").split())
print("Периметр треугольника:", a + b + c)

На этом мы завершим с вами очередное занятие. Я надеюсь, вы теперь хорошо понимаете, как использовать функции print() и input(). Как всегда, закрепите этот материал практическими занятиями и переходите к следующему уроку.

Урок 7 · Часть I. Основы Python

Логический тип bool. Операторы сравнения и операторы and, or, not

Источник: python3-logicheskiy-tip-bool-operatory-sravneniya-i-operatory-and-or-not

На этом занятии вы увидите, как в программах можно делать логические выводы на уровне:

  • True – истина;
  • False – ложь.

Предположим, мы бы хотели узнать:

4 > 2

Для этого достаточно записать такое сравнение и Python возвратит результат: либо True, либо False. В данном случае получаем True (истина), так как 4 действительно больше 2. Если же записать:

4 > 7

то получим False, так как 4 меньше 7. То же самое можно делать и с переменными:

a = 5
b = 7.8
a <= b

Мало того, полученный результат, при необходимости, можно сохранить в переменной, например, так:

res = a > b

получим значение False в переменной res.

Давайте теперь посмотрим на тип этой переменной:

type(res)

да, это новый тип bool (булевый тип), с которым мы только что познакомились и он может принимать только два значения: True или False.

Мы можем присвоить эти значения напрямую переменной, например, так:

res = False

И здесь, естественно, возникает вопрос, какие операторы сравнения вообще существуют в Python? Они, следующие:

< сравнение на меньше
> сравнение на больше
<= сравнение меньше или равно
>= сравнение больше или равно
== сравнение на равенство
!= сравнение на неравенство

Приведу несколько примеров их использования:

5 == 7-2

Здесь справа записана арифметическая операция. Так тоже можно делать. Вообще, в качестве операндов могут быть любые конструкции языка Python: переменные, вычисления, функции и т.п.

Следующий пример, сравнения:

8 >= 8
8 > 8

В первом случае получаем True, а во втором – False, так как 8 не больше 8. Также имейте в виду, что оператор >= записывать наоборот => нельзя. Помимо этого знаки:

=, !=, <=, ==

всегда записываются без пробелов. Если поставить пробел, будет ошибка.

Также частой, нет, очень частой ошибкой начинающих программистов – это запись вместо оператора сравнения == оператора присваивания =. Сравните две строчки:

x = 6
x == 6

В первом случае мы присваиваем переменной x число 6, а во втором случае сравниваем переменную x со значением 6. И эти операторы путать нельзя, хотя они и похожи друг на друга.

Еще несколько полезных примеров сравнения. Предположим, мы хотим проверить переменную x на четность. Я напомню, что четные числа – это, например, числа:

2, 4, 6, -8, -10

то есть, числа, кратные 2. Как выполнить такую проверку? Обычно, это делают, следующим образом:

x % 2 == 0

Помните оператор вычисления остатка от деления? Он здесь будет возвращать 0, если двойка укладывается в x без остатка. Это и есть проверка на четность.

Обратную проверку на нечетность, можно записать так:

x % 2 != 0

По аналогии мы можем проверить, кратна ли переменная какому-либо значению, например, трем:

a % 3 == 0

и так можно делать проверки с любыми числами.

Операторы not, and, or и их приоритеты

Давайте теперь поставим более сложную задачу и определим, попадает ли число (значение переменной) в диапазон [-2; 5]? Какие логические умозаключения здесь нужно провести, чтобы ответить на этот вопрос? Для простоты представим, что у нас имеется переменная:

y = 1.85

Очевидно, чтобы она попадала в диапазон [-2; 5], нужно соблюдение двух условий:

y >= -2

и

y <= 5

В Python записать это можно, следующим образом:

y >= -2 and y <= 5

Здесь общее условие будет истинно, если истинно каждое из подусловий.

Противоположный пример, вывод о непопадании в этот же диапазон. Его можно сделать проверками, что:

y < -2

или

y > 5

В Python это записывается так:

y < -2 or y > 5

Оператор or выдает истину, если истинно, хотя бы одно из подусловий. Понимаете разницу между and и or? В and общее условие истинно, если истинны оба подусловия, а в or – хотя бы одно.

Также, если мы используем оператор and, то условие:

y >= -2 and y <= 5

можно записать в краткой форме:

-2 <= y <= 5

Это будет одно и то же. Какой вариант записи использовать, решать только вам, что удобнее, то и пишите в своих программах.

Приведу еще один пример. Допустим, мы хотим проверить x на кратность 2 или 3. Очевидно, это можно записать так:

x % 2 == 0 or x % 3 == 0

Также можно инвертировать это условие, то есть, определить, что x не кратна 2 и не кратна 3. Это можно сделать двумя способами:

x % 2 != 0 and x % 3 != 0

Или, используя оператор not (не):

not (x % 2 == 0 or x % 3 == 0)

Обратите внимание на круглые скобки. У оператора not самый высокий приоритет, то есть, он выполняется в первую очередь (как умножение и деление в математике). Поэтому, для инвертирования всего составного условия его необходимо поместить в круглые скобки. Если бы мы записали все в виде:

not x % 2 == 0 or x % 3 == 0

Это было бы эквивалентно условию:

x % 2 != 0 or x % 3 == 0

то есть, мы инвертировали бы только первое выражение. Поэтому, при определении составных условий очень важно знать приоритеты операторов:

or 1
and 2
not 3

Приведение к типу bool

В заключение этого занятия я хочу отметить встроенную функцию

bool()

которая выполняет преобразование входного аргумента в логический тип: True или False.

Общее правило здесь такое. Пустое – это False (ложь), а не пустое – True (истина). Что значит пустое и не пустое? Покажу это на примерах. Любое не нулевое число – не пустое, то есть, истина:

bool(1)
bool(-10)

А вот 0 – пустое число, дающее False:

bool(0)

Похожим образом и со строками. Пустая строка:

bool("")  # False

а любая не пустая:

bool("a") # True
bool(" ")  # True

Аналогично дело обстоит и с другими типами данных, с которыми мы с вами еще только будем знакомиться.

Итак, из этого занятия вы должны знать операторы сравнения, работу операторов or, and и not, а также уметь пользоваться функцией bool(). Для закрепления этого материала вас ждут практические задания, а я вас буду ждать на следующем занятии.

Практика 1 · Часть I. Основы Python

Переменные, числа и ввод-вывод

Задания для закрепления темы · решений нет

Цели обучения

  • Объявлять переменные и проверять типы через type
  • Использовать арифметические операторы и функции модуля math
  • Читать ввод, преобразовывать в числа и выводить отформатированный результат
  • Строить логические выражения со сравнениями и операторами and/or/not

Задания

Задание 1. Конвертер единиц

Сложность: лёгкое

Напишите скрипт, который читает расстояние в километрах (float) и печатает то же расстояние в метрах и в милях (1 km ≈ 0.621371 miles).

Требования:

  • Используйте input и преобразование через float
  • Выведите две строки: метры и мили
  • Округлите мили до 3 знаков после запятой через round

Пример:

Input:  2.5
Output:
2500.0 m
1.553 miles

Задание 2. Метрики прямоугольника

Сложность: лёгкое

Реализуйте rectangle_metrics(width: float, height: float) -> tuple[float, float], которая возвращает (area, perimeter).

Требования:

  • Площадь = width × height
  • Периметр = 2 × (width + height)
  • Не печатать; вернуть кортеж из двух элементов

Пример:

rectangle_metrics(3, 4)  # (12.0, 14.0)

Задание 3. Круг по радиусу

Сложность: среднее

Реализуйте circle_info(radius: float) -> dict с использованием math.pi. Верните dict с ключами "diameter", "circumference", "area".

Требования:

  • Используйте math.pi (импортируйте math)
  • Значения могут быть float; округление не требуется
  • Выбросьте ValueError, если radius < 0

Пример:

circle_info(1)
# {"diameter": 2.0, "circumference": 6.283..., "area": 3.141...}

Задание 4. Проверка температуры

Сложность: среднее

Реализуйте is_comfortable(celsius: float) -> bool: верните True, если температура в диапазоне [18, 24] включительно.

Требования:

  • Только операторы сравнения (if не обязателен)
  • Объедините границы через and

Пример:

is_comfortable(20)   # True
is_comfortable(17.9) # False

Задание 5. Дискриминант квадратного уравнения

Сложность: среднее

Реализуйте discriminant(a: float, b: float, c: float) -> float для ax^2 + bx + c: D = b^2 - 4ac.

Затем реализуйте has_real_roots(a, b, c) -> bool, которая возвращает, выполняется ли D \ge 0. Считайте a != 0.

Требования:

  • Обе функции должны работать независимо
  • Используйте арифметические операторы; math по желанию

Пример:

discriminant(1, -3, 2)  # 1.0
has_real_roots(1, 0, 1) # False

Задание 6. Мини-касса

Сложность: сложное

Напишите скрипт, который:

  1. Читает цену товара и количество
  2. Читает процент скидки (0–100)
  3. Печатает итоговую сумму к оплате

Формула: total = price quantity (1 - discount/100).

Требования:

  • Преобразуйте ввод через float / int по смыслу
  • Выведите результат, округлённый до 2 знаков после запятой
  • Выведите "invalid" (без суммы), если скидка вне [0, 100] — используйте булеву логику / ветвление, только если уже знаете if; иначе считайте ввод корректным

Подсказки:

  • round(x, 2) или f-строка со спецификатором формата

Глава 2

Строки

Урок 8 · Часть I. Основы Python

Введение в строки. Базовые операции над строками

Источник: python3-vvedenie-v-stroki-bazovye-operacii-nad-strokami

Сегодня мы с вами познакомимся с еще одним типом данных – строками.

Строки в Python задаются очень просто: или в двойных кавычках:

s1 = "Панда"

или в одинарных (апострофах):

s2 = 'Panda'

Всегда, когда задаются строки, не забывайте про кавычки, если их не поставить:

s2 = Panda

то Panda будет восприниматься как переменная и возникнет ошибка.

В Python есть еще один способ определения многострочных строк. Для этого используются тройные кавычки (одинарные или двойные, неважно) и в них прописывается текст, например, так:

text = '''Я Python бы выучил только за то,
что есть популярные курсы.
Много хороших курсов!'''

Если отобразить содержимое этой строки в консоли Питона, то увидим специальный символ ‘\n’:

'Я Python бы выучил только за то,\nчто есть популярные курсы.\nМного хороших курсов!'

Это один символ, отвечающий в тексте за перенос на новую строку и когда функция print() встречает его, то осуществляет такой переход:

print(text)

То есть, просто запомните, что для перехода на новую строку используется спецсимвол, который записывается в виде ‘\n’. Если записать просто ‘n’ – это будет символ латинской буквы n, а при добавлении слеша – превращается в символ переноса строки.

Далее, строка может вообще не содержать ни одного символа:

a = ""

Получаем пустую строку. Но если добавить хотя бы один символ, даже если это будет пробел:

a = " "

то имеем уже не пустую строку, в данном случае содержащей символ пробела.

Базовые операции над строками

Давайте посмотрим, какие базовые операции можно выполнять со строками в Python. Например, мы хотим соединить две строки между собой:

s1 = "Я люблю"
s2 = "язык Python"

Это можно сделать с помощью оператора +, который в случае со строками выполняет их объединение (конкатенацию):

s3 = s1 + s2
print(s3)

Но мы бы хотели добавить пробел между словами. Сделаем это так:

s3 = s1 + " " + s2

С помощью первого оператора + добавляем пробел к первой строке, а затем, вторым оператором + добавляем вторую строку s2.

Но при использовании оператора конкатенации следует быть осторожным – он объединяет строки между собой. Например, команда:

s3 = s1 + 5

приведет к ошибке, так как операнд справа является числом, а не строкой. Если нам все же необходимо соединить строку с числом, то предварительно число нужно преобразовать в строку. Сделать это можно с помощью специальной функции str():

s3 = s1 + str(5)

Функция str() выполняет преобразование в строки разные типы данных, не только числа, например, можно указать булевое значение:

str(True)

а также другие типы данных, о которых мы еще с вами будем говорить.

Следующий оператор *, применительно к строкам, выполняет их дублирование, указанное число раз:

"ха " * 5

Причем, здесь мы должны указывать именно целое число, для вещественных получим ошибку:

"ха " * 5.5

И это понятно, так как продублировать строку 5,5 раз нельзя.

Следующая функция len() возвращает длину строки (число символов в строке):

a = "hello"
len(a)

Для пустой строки получим значение 0:

len("")

И, как видите, этой функции можно передавать или переменную на строку, или непосредственно записывать строки:

len("Python")

Следующий оператор in позволяет проверять наличие подстроки в строке, например:

'ab' in "abracadabra"
'abc' in "abracadabra"

Следующая важная группа операторов – сравнения строк. В самом простом случае, строки можно сравнивать на равенство:

a == "hello"

Но сравнение:

a == "Hello"

вернет False, так как большая буква H и малая h – это два разных символа. Для сравнения на неравенство используем оператор не равно:

a != "hello"
a != "hello "

Также смотрите строка “hello” (без пробела) и строка “hello ” (с пробелом) – это две разные строки и они не равны между собой.

Наконец, строки можно сравнивать на больше и меньше, например, кот больше, чем кит с точки зрения строк:

'кот' > 'кит'

Почему так? Все просто. Здесь используется лексикографический порядок сравнения. Сначала берутся первые символы (они равны), затем переходим ко вторым символам. По алфавиту сначала идет символ ‘и’, а потом – символ ‘о’, поэтому ‘о’ больше, чем ‘и’. Как только встретились не совпадающие символы, сравнение завершается и последующие символы строк игнорируются.

Если взять равные строки:

'кот' > 'кот'

то получим False, так как ни один символ не больше соответствующего другого из второй строки. Но, добавив пробел в первую строку:

'кот ' > 'кот'

получим значение True, так как при всех прочих равных условиях больше считается более длинная строка. Наконец, если у первой строки первую букву сделать заглавной:

'Кот ' > 'кот'

то получим False. Почему? Дело в том, что каждый символ в компьютере связан с определенным числом – кодом, в соответствии с кодовой таблицей. Например, в таблице ASCII мы видим, что сначала идут символы заглавных букв, а затем – прописных. Поэтому коды больших букв меньше соответствующих кодов малых букв.

Конечно, в Python используется немного другая кодировка UTF-8, но в ней этот принцип сохраняется. Мы можем легко посмотреть код любого символа с помощью функции ord():

ord('К')
ord('к')

И, как видите, для буквы ‘К’ код меньше, чем для ‘к’.

Итак, из этого занятия вам нужно запомнить, как задавать обычные и многострочные строки. Что из себя представляет символ переноса строки. Знать базовые операции со строками:

  • + (конкатенация) – соединение строк;
    • (дублирование) – размножение строкового фрагмента;
  • str() – функция для преобразования аргумента в строковое представление;
  • len() – вычисление длины строки;
  • in – оператор для проверки вхождения подстроки в строку;
  • операторы сравнения: == != > <
  • ord() – определение кода символа.

Для закрепления этого материала вас ждут практические задания, а я буду ждать на следующем уроке.

Урок 9 · Часть I. Основы Python

Знакомство с индексами и срезами строк

Источник: python3-znakomstvo-s-indeksami-i-srezami-strok

Как вы уже знаете, в Python строку можно задавать, например, так:

s = "hello python"

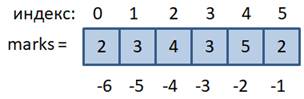
Иллюстрация к уроку

и она представляет собой упорядоченный набор символов. Что значит упорядоченный? Смотрите, каждый символ строки имеет свой уникальный, порядковый номер. Эти номера называются индексами. Первый – 0, второй – 1 и так до конца. Мы можем использовать эти индексы для обращения к отдельному символу строки. Для этого, записывается имя переменной и в квадратных скобках указывается номер символа:

s[0]
s[1]

Но будьте внимательны, если указать несуществующий индекс:

s[12]

то получим ошибку выхода за пределы диапазона. В нашем случае последний индекс равен 11, а мы записали 12. Чтобы взять последний символ нам следовало бы записать:

s[11]

То есть, последний индекс равен длине строки минус один:

len(s) - 1

И, по идее, мы могли бы его так и указать в квадратных скобках:

s[len(s) - 1]

Эта конструкция работает для строк произвольной длины (кроме нулевой, когда символов нет). Но в Python то же самое можно записать проще, используя отрицательные индексы:

s[-1]

То есть, длину строки len(s) можно опускать и записывать отрицательные значения. Получаем способ индексации с конца строки.

Причем индексацию можно выполнять также и непосредственно над строками, например:

"panda"[3]

вернет 4-й символ этой строки. Иногда это тоже может быть полезно.

Срезы

Фактически, когда мы выполняем индексацию, то возвращается новая строка из одного выделенного символа. Но мы можем выделять и сразу несколько символов, используя следующий синтаксис:

строка[start:stop)

Выделенная последовательность символов называется срезом строки.

Например, можно сделать так:

s[1:3]

вернет два символа с индексами 1 и 2. Последнее значение 3 не включается в срез. В срезах можно не указывать последнее значение:

s[4:]

или первое:

s[:5]

или оба:

s[:]

В последнем случае возвращается та же самая строка. Убедиться в этом можно, следующим образом:

a = s[:]
id(a)
id(s)

В срезах также можно использовать отрицательные индексы, например:

s[2:-2]

Но если записать:

s[-2:2]

то получим пустую строку, так как эти индексы не образуют диапазон значений.

Наконец, в срезах дополнительно можно указывать еще и шаг перебора символов, согласно синтаксису:

строка[start:stop:step)

Например:

s[2:10:2]
s[2::3]
s[:5:3]
s[::2]

И использовать отрицательный шаг:

s[::-1]

тогда все символы будут перебираться в обратном порядке, начиная с последнего. Если же указать:

s[::-2]

то будут выбираться символы с конца через один.

Изменение строк

При работе со строками следует иметь в виду, что она относится к неизменяемым типам данных, то есть, существующую строку изменить нельзя. В частности, из-за этого попытка присвоить строке какой-либо символ:

s[0] = 'H'

приведет к ошибке. Чтобы изменить строку, нужно создать новую с другим содержимым:

s2 = 'H' + s[1:]

И так происходит каждый раз, когда нужно изменить что-то в уже существующей строке.

Итак, из этого занятия вы должны хорошо себе представлять:

  • строка – упорядоченный набор символов;
  • как выполняется индексация к отдельным символам строки str[index];
  • как выделять из строк наборы символов – срезы;
  • строка – неизменяемый объект;
  • способ модификации (изменения) строк через индексы и срезы.

Для закрепления этого материала, как всегда пройдите практические задания и переходите к следующему уроку.

Урок 10 · Часть I. Основы Python

Основные методы строк

Источник: python3-osnovnye-metody-strok

На этом занятии мы познакомимся с основными методами для строк. Что такое методы? Смотрите, когда мы объявляем какую-либо строку:

s = "python"

то в памяти устройства автоматически создается объект, содержащий указанные символы. Тип данных этого объекта – строка:

type(s)

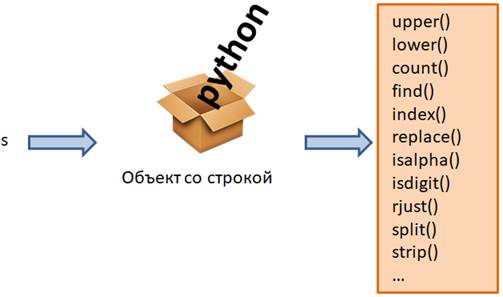
Так вот, каждый такой объект связан с набором стандартных функций по работе со строками. Эти функции и называются методами.

Иллюстрация к уроку

Чтобы вызвать метод для конкретной строки, необходимо указать объект, поставить точку, записать имя метода и в круглых скобках список аргументов, если они необходимы:

объект.метод(аргументы)

Давайте рассмотрим все на конкретных примерах. Итак, у нас есть объект-строка, на который ссылается переменная s. Через эту переменную можно вызывать все методы строк. Чтобы увидеть их полный список, можно записать:

s.

и Pycharm отобразит полный их список. Мы с вами сейчас увидим работу наиболее употребительных из них. Первый метод:

s.upper()

возвращает новую строку (новый объект) со всеми заглавными буквами. При этом сама строка остается без изменений. И это логично, так как строки относятся к неизменяемым типам данных.

Обратите внимание, для вызова этого метода после его имени обязательно нужно поставить круглые скобки. Без них мы получим просто ссылку на объект-функцию:

s.upper

но запущена она не будет. Для запуска необходимы круглые скобки в конце – это оператор для выполнения функций и методов.

Если мы хотим сохранить результат преобразования строки в какой-либо переменной, то это делается так:

res = s.upper()

И теперь res ссылается на строку ‘PYTHON’.

Второй метод:

res.lower()

наоборот, переводит все буквенные символы в нижний регистр и возвращает соответствующую строку.

Следующий метод

String.count(sub[, start[, end]])

возвращает число повторений подстроки sub в строке String. Два необязательных аргумента:

  • start – индекс, с которого начинается поиск;
  • end – индекс, которым заканчивается поиск.

В самом простом случае, мы можем для строки

msg = "abrakadabra"

определить число повторений сочетаний «ra»:

msg.count("ra")

получим значение 2 – именно столько данная подстрока встречается в нашей строке.

Теперь предположим, что мы хотим начинать поиск с буквы k, имеющей индекс 4.

Иллюстрация к уроку

Тогда метод следует записать со значением start=4:

msg.count("ra", 4)

и мы получим значение 1. Далее, укажем третий аргумент – индекс, до которого будет осуществляться поиск. Предположим, что мы хотим дойти до 10-го индекса и записываем:

msg.count("ra", 4, 10)

и получаем значение 0. Почему? Ведь на индексах 9 и 10 как раз идет подстрока «ra»? Но здесь, также как и в срезах, последний индекс исключается из рассмотрения. То есть, мы говорим, что нужно дойти до 10-го, не включая его. А вот если запишем 11:

msg.count("ra", 4, 11)

то последнее включение найдется.

Следующий метод

String.find(sub[, start[, end]])

возвращает индекс первого найденного вхождения подстроки sub в строке String. А аргументы start и end работают также как и в методе count. Например:

msg.find("br")

возвращает 1, т.к. первое вхождение «br» как раз начинается с индекса 1. Поставим теперь значение start=2:

msg.find("br", 2)

и поиск начнется уже со второго индекса. Получим значение 8 – индекс следующего вхождения подстроки «br». Если мы укажем подстроку, которой нет в нашей строке:

msg.find("brr")

то метод find возвращает -1. Третий аргумент end определяет индекс, до которого осуществляется поиск и работает также как и в методе count.

Метод find ищет первое вхождение слева-направо. Если требуется делать поиск в обратном направлении: справа-налево, то для этого используется метод

String.rfind(sub[, start[, end]])

который во всем остальном работает аналогично find. Например:

msg.rfind("br")

возвратит 8 – первое вхождение справа.

Наконец, третий метод, аналогичный find – это:

String.index(sub[, start[, end]])

Он работает абсолютно также как find, но с одним отличием: если указанная подстрока sub не находится в строке String, то метод приводит к ошибке:

msg.index("brr")

тогда как find возвращает -1. Спрашивается: зачем нужен такой ущербный метод index? В действительности такие ошибки можно обрабатывать как исключения и это бывает полезно для сохранения архитектуры программы, когда неожиданные ситуации обрабатываются единым образом в блоке исключений. Но, обо всем этом речь пойдет позже.

Следующий метод

String.replace(old, new, count=-1)

Выполняет замену подстрок old на строку new и возвращает измененную строку. Например, в нашей строке, мы можем заменить все буквы a на o:

msg.replace("a", 'o')

на выходе получим строку «obrokodobro». Или, так:

msg.replace("ab", "AB")

Используя этот метод, можно выполнять удаление заданных фрагментов, например, так:

msg.replace("ab", "")

Третий необязательный аргумент задает максимальное количество замен. Например:

msg.replace("a", 'o', 2)

Заменит только первые две буквы a: «msg.replace(“a”, ‘o’, 2)». При значении -1 количество замен неограниченно.

Следующие методы позволяют определить, из каких символов состоит наша строка. Например, метод

String.isalpha()

возвращает True, если строка целиком состоит из букв и False в противном случае. Посмотрим, как он работает:

msg.isalpha()

вернет True, т.к. наша строка содержит только буквенные символы. А вот для такой строки:

"hello world".isalpha()

мы получим False, т.к. имеется символ пробела.

Похожий метод

String.isdigit()

возвращает True, если строка целиком состоит из цифр и False в противном случае. Например:

"5.6".isdigit()

т.к. имеется символ точки, а вот так:

"56".isdigit()

получим значение True. Такая проверка полезна, например, перед преобразованием строки в целое число. О проверках мы еще будем говорить.

Следующий метод

String.rjust(width[, fillchar = ‘ ‘])

возвращает новую строку с заданным числом символов width и при необходимости слева добавляет символы fillchar:

d="abc"
d.rjust(5)

Получаем строку « abc» с двумя добавленными слева пробелами. А сама исходная строка как бы прижимается к правому краю. Этот метод часто используют для добавления незначащих нулей перед цифрами:

d = "12"
d.rjust(3, '0')

Получим строку «012». Причем вторым аргументом можно писать только один символ. Если записать несколько, то возникнет ошибка:

d.rjust(3, "00")

Если ширина width будет меньше длины строки:

d.rjust(1)

то вернется исходная строка. Аналогично работает метод

String.ljust(width[, fillchar = ‘ ‘])

который возвращает новую строку с заданным числом символов width, но добавляет символы fillchar уже справа:

d.ljust(10, "*")

Следующий метод

String.split(sep=None, maxsplit=-1)

возвращает коллекцию строк, на которые разбивается исходная строка String. Разбивка осуществляется по указанному сепаратору sep. Например:

"Иванов Иван Иванович".split(" ")

Мы здесь разбиваем строку по пробелам. Получаем коллекцию из ФИО. Тот же результат будет и при вызове метода без аргументов, то есть, по умолчанию он разбивает строку по пробелам:

"Иванов Иван Иванович".split()

А теперь предположим, перед нами такая задача: получить список цифр, которые записаны через запятую. Причем, после запятой может быть пробел, а может и не быть. Программу можно реализовать так:

digs = "1, 2,3, 4,5,6"
digs.replace(" ", "").split(",")

мы сначала убираем все пробелы и для полученной строки вызываем split, получаем список цифр.

Обратный метод

String.join(список)

возвращает строку из объединенных элементов списка, между которыми будет разделитель String. Например:

d = digs.replace(" ", "").split(",")
", ".join(d)

получаем строку «1, 2, 3, 4, 5, 6». Или так, изначально была строка:

fio = “Иванов Иван Иванович”

и мы хотим здесь вместо пробелов поставить запятые:

fio2 = ",".join(fio.split())

Теперь fio2 ссылается на строку с запятыми «Иванов,Иван,Иванович».

Следующий метод

String.strip()

удаляет пробелы и переносы строк в начале и конце строки. Например:

"    hello world         \n".strip()

возвращает строку «hello world». Аналогичные методы:

String.rstrip() и String.lstrip()

удаляют пробелы и переносы строк только справа или только слева.

В заключение занятия я приведу список всех рассмотренных методов, которые хорошо было бы запомнить и применять по мере необходимости при работе со строками:

Название Описание
String.upper() Возвращает строку с заглавными буквами
String.lower() Возвращает строку с малыми буквами
String.count(sub[, start[, end]]) Определяет число вхождений подстроки в строке
String.find(sub[, start[, end]]) Возвращает индекс первого найденного вхождения
String.rfind(sub[, start[, end]]) Возвращает индекс первого найденного вхождения при поиске справа
String.index(sub[, start[, end]]) Возвращает индекс первого найденного вхождения
String.replace(old, new, count=-1) Заменяет подстроку old на new
String.isalpha() Определяет: состоит ли строка целиком из буквенных символов
String.isdigit() Определяет: состоит ли строка целиком из цифр
String.rjust(width[, fillchar = ‘ ‘]) Расширяет строку, добавляя символы слева
String.ljust(width[, fillchar = ‘ ‘]) Расширяет строку, добавляя символы справа
String.split(sep=None, maxsplit=-1) Разбивает строку на подстроки
String.join(список) Объединяет коллекцию в строку
String.strip() Удаляет пробелы и переносы строк справа и слева
String.rstrip() Удаляет пробелы и переносы строк справа
String.lstrip() Удаляет пробелы и переносы строк слева

Занятие получилось несколько справочным. Но, что поделать, некоторые возможности языка лучше сразу выучить, чтобы потом не изобретать велосипед и подменять уже существующие методы своими фрагментами программного кода.

Запомнить все это также поможет практика, а я будут вас ждать на следующем занятии.

Урок 11 · Часть I. Основы Python

Спецсимволы, экранирование символов, raw-строки

Источник: python3-specsimvoly-ekranirovanie-simvolov-raw-stroki

Теперь, когда познакомились со строками и их методами, пришло время узнать, какие специальные символы могут содержать строки в Питоне. С одним из них мы уже сталкивались – это символ перевода строки:

‘\n’

Я напомню, например, когда задается многострочная строка:

text = """hello
python"""

то в ней автоматически добавляет этот символ перевода между строками:

'hello\npython'

Причем, это один символ, хотя он и выглядит как два символа: обратный слеш и n. Мы в этом легко можем убедиться, если воспользоваться функцией:

len(text)

Получим значения 12 = 5 + 6 + 1 – как раз число символов в двух строках плюс один символ перевода строки.

Мало того, мы можем его явно прописывать в любой строке, формируя многострочный текст, например, так:

t = "panda needs\npython"

и, выводя эту строку с помощью функции:

print(t)

увидим две строки.

Вообще, в строках языка Python можно прописывать следующие спецсимволы:

Обозначение Описание
\n Перевод строки
\\ Символ обратного слеша
\’ Символ апострофа
" Символ двойной кавычки
\a Звуковой сигнал
\b Эмуляция клавиши BackSpace
\f Перевод формата
\r Возврат каретки
\t Горизонтальная табуляция (размером в 4 пробела)
\v Вертикальная табуляция
\0 Символ Null (не признак конца строки)
\xhh Символ с шестнадцатиричным кодом hh
\ooo Символ с восьмиричным кодом ooo
\N{id} Идентификатор из кодовой таблицы Unicode
\uhhhh 16-битный символ Unicode в шестнадцатиричной форме
\Uhhhhhhhh 32-битный символ Unicode в шестнадцатиричной форме
\другое Не является экранированной последовательностью

Все их запоминать совсем не обязательно, на практике используются, в основном:

\n, \\, \’, ", \t

Значительно реже другие варианты. И, обратите внимание, перед каждым спецсимволом записан символ обратного слеша. Это, своего рода, маркер начала спецсимвола. И если после слеша идет одно из обозначений таблицы, то оно будет восприниматься как некая управляющая последовательность.

Давайте я все это продемонстрирую на примерах. Добавим в строку символ табуляции:

t = "\tpanda needs\npython"

Теперь функция print() интерпретирует его, как особый горизонтальный отступ:

print(t)

Если же мы уберем букву t:

t = "\panda needs\npython"

то при печати увидим просто обратный слеш. В действительности, здесь сработала последняя строчка таблицы: когда не подходит ни одна последовательность, то просто печатается обратный слеш.

Но здесь нужно быть осторожным. Предположим, что мы слово needs хотим заключить в обратные слеши:

t = "panda \needs\ python"

Однако, при печати:

print(t)

первый слеш пропадет, так как он будет восприниматься началом спецпоследовательности символа переноса строки. Поэтому, для добавления символа обратного слеша в строку, следует записывать два обратных слеша подряд:

t = "panda \\needs\\ python"

Тогда в строке они будут автоматически заменены на один символ слеша и при выводе мы это и видим. Это называется экранированием, когда мы символы с двойным назначением записываем, добавляя перед ними обратный слеш. В данном случае получаем двойной слеш.

Часто такие символы следует прописывать при определении путей к файлам. Как мы знаем, в ОС Windows маршруты имеют вид:

D:\Python\Projects\stepik\tex1.py

Здесь фигурируют обратные слеши для разделения каталогов. Чтобы правильно описать такой путь, слеши следует экранировать:

path = "D:\\Python\\Projects\\stepik\\tex1.py"

и при печати:

print(path)

видим, что маршрут определен верно. Если бы слеши не были экранированы, то получили бы неверный путь к файлу:

path = "D:\Python\Projects\stepik\tex1.py"

Вот этот момент следует хорошо запомнить.

Кроме обратного слеша экранировать также следует и кавычки. Например, мы хотим сформировать строку:

s = "Марка вина "Ягодка""

Внутри этой строки имеются кавычки. Но эти же самые кавычки определяют начало и конец строки в Python. Поэтому такая запись приведет к синтаксической ошибке. Чтобы все работало корректно, нужно выполнить экранирование кавычек:

s = "Марка вина \"Ягодка\""

Или, в данном случае, можно было бы использовать одинарные кавычки для определения строки, а внутри нее записать двойные:

s = 'Марка вина "Ягодка"'

Но на практике рекомендуется всегда выполнять экранирование таких символов, чтобы избежать случайных ошибок. Например, в этой строке уже нельзя просто так записать одинарные кавычки:

s = 'Марка вина 'Ягодка''

Снова получим синтаксическую ошибку, их нужно экранировать:

s = 'Марка вина \'Ягодка\''

В завершение этого занятия отмечу, что в Python можно задавать, так называемые, сырые (raw) строки. Это строки, в которых игнорируются спецпоследовательности и все символы воспринимаются буквально так, как записаны. Например, если взять строку с путем к файлу:

path = "D:\\Python\\Projects\\stepik\\tex1.py"

то сейчас, при отображении, мы видим по одному слешу:

print(path)

Но, если определить эту же строку, как сырую, добавив букву r перед ней:

path = r"D:\\Python\\Projects\\stepik\\tex1.py"

то при печати увидим по два слеша, именно так, как прописали. Поэтому, в таких строках можно убрать спецопределения и записывать строку буквально так, как она должна выглядеть:

path = r"D:\Python\Projects\stepik\tex1.py"

На этом мы завершим наше очередное занятие по Python. Из него вы должны хорошо себе представлять, что такое спецсимволы и экранирование символов. Какие основные спецсимволы для строк существуют и как определяются сырые строки.

Урок 12 · Часть I. Основы Python

Форматирование строк: метод format и F-строки

Источник: python3-formatirovanie-strok-metod-format-i-f-stroki

На этом занятии мы подробнее поговорим о способах формирования строк на основе набора различных переменных. Мы уже знаем с вами как создавать строки и соединять их между собой. Предположим, у нас есть две переменные:

age=18; name="Сергей"

и мы формируем такое сообщение:

"Меня зовут "+name+", мне "+str(age)+" и я люблю язык Python."

На выходе получим:

‘Меня зовут Сергей, мне 18 и я люблю язык Python.’

Но это не самый удобный и распространенный способ формирования строк по шаблону. Гораздо удобнее использовать специальный метод строки:

str.format(*args)

который в данном конкретном случае можно использовать так:

"Меня зовут {0}, мне {1} и я люблю язык Python.".format(name, age)

Смотрите, здесь в фигурных скобках мы указываем индекс переменной, значение которой будет подставлено в это место строки. Индекс 0 – первая переменная, указанная в методе format, т.е. name, а индекс 1 – вторая переменная age. То есть, метод формат возвращает новую строку в заданном формате. И чтобы сохранить этот результат в какой-либо переменной, следует записать так:

msg = "Меня зовут {0}, мне {1} и я люблю язык Python.".format(name, age)

Теперь msg ссылается на созданную строку.

Также мы можем одну и ту же переменную указывать несколько раз, например, так:

"Меня зовут {0}, мне {1} и я люблю язык Python. {0}".format(name, age)

Как видите, это удобнее обычной конкатенации строк. Но эту запись можно сделать еще понятнее, используя именованные параметры. Для этого у каждой переменной пропишем ее имя (ключ). Оно придумывается программистом, например:

format(fio=name, old=age)

и, далее, в формате строки указываются уже эти имена:

"Меня зовут {fio}, мне {old} и я люблю язык Python. {fio}".format(fio=name, old=age)

Это уже гораздо нагляднее и понятнее. Глядя на эту строку, мы легко понимаем, что и где будет записано. Конечно, если указать неверное имя, например, так:

"Меня зовут {name}, мне {old} и я люблю язык Python. {fio}".format(fio=name, old=age)

То возникнет ошибка, говорящая, что ключа name не существует. То есть, в фигурных скобках указывается именно ключ, а не переменная. И, кроме того, благодаря использованию ключей, мы можем записывать переменные в методе format в любом порядке. Например, поменяем их местами:

"Меня зовут {fio}, мне {old} и я люблю язык Python. {fio}".format(old=age, fio=name)

На выходе получим то же самое.

Но, начиная с версии Python 3.6, появился новый, гораздо более удобный способ форматирования строк. Это, так называемые, F-строки. Здесь мы рассмотрим лишь основы использования этого подхода, для более глубокого изучения можно обратиться к стандарту PEP8:

https://www.python.org/dev/peps/pep-0498/

Итак, чтобы указать Python воспринимать строку, как F-строку, перед ее литералом ставится символ ‘f’ (именно малая буква). И, теперь, в фигурных скобках можно записывать любые конструкции языка Python, например, имена переменных:

f"Меня зовут {name}, мне {age} и я люблю язык Python."

Видите как это удобно?

Далее, внутри фигурных скобок F-строк можно записывать, например, и арифметические операции и методы строк:

f"Меня зовут {name.upper()}, мне {age*2} и я люблю язык Python."

В результате, получим:

‘Меня зовут СЕРГЕЙ, мне 36 и я люблю язык Python.’

Или даже не прописывать переменные, а использовать обычные числовые операции и вызывать функции:

f"Меня зовут {len(name)}, мне {14*2} и я люблю язык Python."

Как видите, все достаточно просто и наглядно. Теперь, в своих программах вы тоже сможете использовать F-строки, если ваш интерпретатор языка версии 3.6 и выше, либо метод format(), если F-строки не поддерживаются из-за низкой версии. Обычно, сейчас повсеместно применяют F-строки, так как они намного удобнее других способов форматирования строк.

Для закрепления этого материала подготовлено несколько практических заданий и после их выполнения жду всех вас на следующем занятии.

Практика 2 · Часть I. Основы Python

Строки

Задания для закрепления темы · решений нет

Цели обучения

  • Индексировать, нарезать и конкатенировать строки
  • Использовать распространённые методы строк (strip, split, replace, методы регистра)
  • Собирать читаемый вывод через f-строки и escape-последовательности

Задания

Задание 1. Инициалы

Сложность: лёгкое

Реализуйте initials(full_name: str) -> str. Для "Ada Lovelace" верните "A.L." (первая буква каждого слова, разделённого пробелами, в верхнем регистре, через точки, с точкой в конце).

Требования:

  • В лёгком варианте можно считать ровно два слова, либо обработать любое число слов
  • Используйте индексацию / срезы и методы строк

Пример:

initials("ada lovelace")  # "A.L."

Задание 2. Средний фрагмент

Сложность: лёгкое

Реализуйте middle_chunk(s: str, n: int) -> str: верните средние n символов. Если n нечётно, а длина чётна (или наоборот), центрируйте как можно ровнее (округление вниз слева).

Требования:

  • Для извлечения используйте только срезы
  • Если n >= len(s), верните s без изменений
  • Если n <= 0, верните ""

Пример:

middle_chunk("abcdef", 2)  # "cd"
middle_chunk("abcde", 3)   # "bcd"

Задание 3. Нормализация имени пользователя

Сложность: среднее

Реализуйте normalize_username(raw: str) -> str:

  • Уберите пробелы по краям
  • Приведите к нижнему регистру
  • Замените пробелы на _
  • Удалите символы, которые не являются буквами, цифрами или _

Требования:

  • Верните очищенную строку
  • Пустой результат допустим

Пример:

normalize_username("  Alice Wonder! ")  # "alice_wonder"

Подсказки:

  • Собирайте новую строку посимвольно или используйте проверки str.is*

Задание 4. Путь из частей

Сложность: среднее

Реализуйте join_path(*parts: str) -> str, которая объединяет сегменты пути через /, схлопывает повторяющиеся слэши и не добавляет завершающий слэш (кроме случая, когда путь — только "/").

Требования:

  • Не используйте pathlib / os.path — только операции со строками
  • Ведущий / у первой части означает абсолютный путь

Пример:

join_path("home", "user", "docs")     # "home/user/docs"
join_path("/var", "log/", "/app")     # "/var/log/app"

Задание 5. Строка чека

Сложность: среднее

Реализуйте format_receipt_line(name: str, price: float, qty: int) -> str через f-строку:

"{name} x{qty}: ${total:.2f}", где total = price * qty. Обрежьте/дополните name до ширины 12 (выравнивание влево): более длинные имена → первые 12 символов.

Требования:

  • Используйте f-строку (не %-форматирование)
  • Ровно один пробел перед x и после : как в шаблоне

Пример:

format_receipt_line("Coffee", 2.5, 3)  # "Coffee       x3: $7.50"

Задание 6. Отчёт по escape-символам

Сложность: сложное

Реализуйте describe_escapes(s: str) -> str, которая возвращает многострочный отчёт о количестве: \n, \t, \\ и " (символ кавычки).

Формат (точно):

newlines: N
tabs: N
backslashes: N
quotes: N

Требования:

  • Считайте символы в строке (в ней уже реальные переводы строк/табы, а не двухсимвольные последовательности)
  • Для отчёта используйте f-строку или конкатенацию

Пример:

describe_escapes("a\tb\nc\"\\")
# newlines: 1
# tabs: 1
# backslashes: 1
# quotes: 1

Глава 3

Списки

Урок 13 · Часть I. Основы Python

Списки - операторы и функции работы с ними

Источник: python3-spiski-operatory-i-funkcii-raboty-s-nimi

Мы переходим к новой теме – списки в языке Python. Что такое список и зачем он нужен? Представьте, что нам в программе нужно хранить и обрабатывать список городов, или список оценок студента, или список булевых значений, или значения функции и многое другое. Часто, когда нам нужно оперировать набором каких-либо данных, используются списки. И на этом занятии мы начнем с ними знакомиться.

Иллюстрация к уроку

Задать список в программе на Python очень просто, ставятся квадратные скобки и внутри них через запятую перечисляются его элементы:

["Москва", "Тверь", "Вологда"]

Чтобы оперировать списком через переменную, используется оператор присваивания:

marks = [2, 3, 4, 3, 5, 2]

Давайте теперь посмотрим, как эту конструкцию, этот список использовать в программировании? Например, вычислить средний балл по оценкам? Для этого нам надо уметь обращаться к отдельным элементам списка. Как это сделать? Так как список – это упорядоченная коллекция, то все его элементы имеют свой порядковый номер – индекс, начиная с нулевого и заканчивая последним.

Иллюстрация к уроку

Используя эти индексы и синтаксис:

список[индекс]

мы можем обращаться к отдельным элементам. Например:

marks[0]
marks[2]

И для вычисления среднего балла среди шести оценок, получим формулу:

avg = (marks[0] + marks[1] + marks[2] + marks[3] + marks[4] + marks[5]) / 6

Это простейший пример того, как можно хранить и использовать данные списка. Причем индексирование здесь работает так же, как и со строками. Если указать несуществующий индекс:

marks[10]

то получим ошибку. А чтобы обратиться к последнему элементу, можно использовать отрицательный индекс:

marks[-1]

То есть, мы здесь также имеем наборы отрицательных индексов, идущих от конца к началу списка.

Список – изменяемый тип данных

В отличие от строк, списки в Python относятся к изменяемым типам данных. То есть, мы можем изменить ранее хранимое значение. Например, студент пересдал первую двойку на тройку и мы хотим внести это изменение в список marks. Сделать это можно через оператор присваивания:

marks[0] = 3

Все, теперь первое значение равно 3. Как вы помните, со строками такая операция приводила к ошибке, так как строки – это неизменяемый тип. Но со списками мы так делать можем и в этом их кардинальное отличие от строк. Список – динамическая структура данных, который может меняться в процессе работы программы.

Мало того, списку, состоящему из чисел, мы легко можем присвоить любой другой тип данных, например, строку:

marks[1] = "удовл."

Вообще списки могут содержать самые разные типы данных, например:

lst = ["Москва", 1320, 5.8, True, "Тверь", False]

в том числе и другие, вложенные списки:

lst2 = [1, 2.5, [-1, -2, -3], 4]

О вложенных списках мы еще будем говорить.

Если нам нужно создать пустой список, то достаточно записать квадратные скобки без элементов:

a = []

или, воспользовавшись специальной функцией:

b = list()

которая создает новый пустой список. Если же ей в качестве аргумента указать другой список:

a = list([True, False])

то будет создан новый список с тем же самым содержимым. Также мы можем передать ей строку:

list("Python")

тогда получим список, состоящий из отдельных символов этой строки. Вообще на вход функции list() можно передавать любой перебираемый объект, на основе которого формируется новый список. Такие перебираемые объекты еще называются итерируемыми , но мы о них будем говорить на будущих занятиях.

Функции работы со списками

Язык Python содержит несколько удобных встроенных функций для работы со списками:

  • len() – определение числа элементов в списке (длина списка);
  • max() – для нахождения максимального значения;
  • min() – для нахождения минимального значения;
  • sum() – для вычисления суммы;
  • sorted() – для сортировки коллекции.

Для начала воспользуемся уже знакомой нам функцией len для определения длины списка:

len(marks)

Соответственно, для пустого списка:

len([])

она возвращает 0.

Две из них min() и max() нам уже знакомы. Сейчас мы увидим, как их можно применять к спискам. Сформируем список значений температуры по дням города Москвы:

t = [23.5, 25.6, 27.3, 26.0, 30.4, 29.5]

Теперь, чтобы найти максимальное и минимальное значения, достаточно вызвать функции:

max(t)
min(t)

Для подсчета суммы всех значений, запишем функцию sum:

sum(t)

А вычислить среднюю температуру можно следующим образом:

sum(t)/len(t)

Видите, как просто это делается на уровне функций.

Наконец, последняя функция sorted, если ее вызвать с одним аргументом:

sorted(t)

то она возвратит новый список с отсортированными значениями по неубыванию (или, как часто говорят, по возрастанию). И, обратите внимание, эта функция не меняет прежний список t, она именно возвращает новый список с отсортированными значениями. Очевидно, чтобы сохранить результат работы этой функции, следует использовать переменную, например, так:

t_sort = sorted(t)

Если же нам нужно отсортировать список по невозрастанию (убыванию), то дополнительно прописывается параметр:

sorted(t, reverse=True)

Функции min(), max() и sorted() работают не только с числовыми типами, но и вообще с любыми, где допустимы операторы сравнения больше и меньше. Например, создадим список из символов (строк):

s = list("python")

И выполним все те же самые функции:

max(s)
min(s)
sorted(s)

А вот функция sum() приведет к ошибке:

sum(s)

Операторы списков

При работе со списками часто используются следующие операторы:

  • + – соединение двух списков в один;
    • – дублирование списка;
  • in – проверка вхождения элемента в список;
  • del – удаление элемента списка.

Например:

[1, 2, 3] + [4, 5]

Но, вот так:

[1, 2, 3] + 4

работать не будет, так как оператор + соединяет именно списки между собой, просто число или какой-либо другой тип данных записывать нельзя. В данном случае правильно будет так:

[1, 2, 3] + [4]

Или, так:

[1, 2, 3] + [True]

Как видите, добавлять в список можно самые разные типы данных.

Следующий оператор * выполняет дублирование списка указанное число раз:

["Я", "люблю", "Python"] * 3

Этот оператор работает также как и со строками, здесь можно указывать только целое число (или переменную, ссылающуюся на целое значение). Прописывать дробные числа нельзя:

["Я", "люблю", "Python"] * 3.5

На практике можно комбинировать операторы и определять, например, такие конструкции:

["Я"] + ["люблю"] * 3 + ["Python"]

Все достаточно очевидно, гибко, наглядно и просто. Этим и знаменателен этот язык. В нем многое реализуется простыми и понятными методами, в отличие от других языков программирования.

Следующий оператор in позволяет определять вхождение некоторого значения в список. Делается это также просто, например:

lst = ["Москва", 1320, 5.8, True, "Тверь", False]
1320 in lst
120 in lst

Или, можно узнать, является ли элементом списка другой список:

[1, 2] in lst

В данном случае получим False, но если его добавить:

lst = ["Москва", 1320, 5.8, True, "Тверь", False, [1, 2]]

то

[1, 2] in lst

вернет True. И так со всеми типами данных:

"Москва" in lst

Последний оператор del выполняет удаление элемента списка по его индексу, например, так:

del lst[2]

при этом индексы оставшихся элементов по прежнему идут по порядку от 0 и до конца списка.

На этом мы завершим наше первое занятие по спискам. Из него вы должны себе хорошо представлять, как задавать списки с использованием квадратных скобок и функции list(), понимать механизм индексации (обращение к отдельным элементам списка), уметь оперировать функциями len(), max(), min(), sum(), sorted() и использовать операторы +, *, in, del. Все это следует закрепить практическими заданиями, после чего, жду всех вас на следующем уроке.

Урок 14 · Часть I. Основы Python

Срезы списков и сравнение списков

Источник: python3-srezy-spiskov-i-sravnenie-spiskov

Мы продолжаем изучение списков языка Python. Это занятие начнем со срезов. О срезах мы с вами уже говорили, когда рассматривали строки и с их помощью выделяли наборы символов из строк. Со списками все работает аналогично: срезы позволяют выделять наборы элементов. Например, у нас есть список:

lst = ["Москва", "Уфа", "Тверь", "Казань"]

и мы хотим выбрать из него 2-й и 3-й элементы. Это можно сделать, так:

lst[1:3]

Давайте разберемся, как это работает. Синтаксис для срезов имеет вид:

список[start:end]

В данном случае, мы указываем стартовый индекс 1 (второй элемент) и конечный 3 (последний элемент, до которого выделяем срез, не включая его). В итоге, на выходе получаем список из двух элементов:

[‘Уфа’, ‘Тверь’]

То есть, это новый список, состоящий из выделенных элементов. Мы в этом можем легко убедиться. Сохраним через переменную результат среза:

a = lst[1:3]

Затем, изменим его первый элемент:

a[0] = "Воронеж"

и, как видим, это никак не повлияло на исходный список lst.

В срезах можно указывать только начальный индекс:

lst[2:]

тогда все будет выбрано с 3-го элемента и до конца списка. Или только конечный индекс:

lst[:3]

Обратите внимание, последний указанный индекс не включается в срез. Если же не указывать ни первый, ни последний индексы, то получим копию исходного списка:

cities = lst[:]

Здесь создается именно копия списка. Если мы посмотрим на их id:

id(lst)
id(cities)

то они будут разными. Также копию списка, можно сделать с помощью рассмотренной ранее функции list:

c = list(lst)

Какой именно вариант использовать для копирования списка, решает сам программист, в зависимости от удобства. Чаще всего используется синтаксис срезов, т.к. это более короткая запись.

А что будет, если мы один список присвоим другому:

d = lst

будет ли здесь создаваться копия списка? Вспоминая занятие по переменным, мы говорили, что переменные – это ссылки на объекты и оператор присваивания лишь копирует ссылку, но не сам объект. Поэтому переменные d и lst будут ссылаться на один и тот же список, их id:

id(d)
id(lst)

равные. Ну а наиболее сомневающимся предлагаю изменить значение списка через d:

d[0] = "Самара"

и посмотреть на список lst. В нем произойдет такое же изменение.

Далее, так как у списка имеются отрицательные индексы, то они также могут быть использованы при определении срезов. Например, создадим список оценок:

marks = [2, 3, 4, 3, 5, 2]

Иллюстрация к уроку

и запишем следующие срезы:

marks[2:-1]
marks[-3:-1]

Дополнительно в срезах можно указывать шаг перебора элементов, согласно синтаксису:

список[start:stop:step]

Например:

marks[1:5:2]

или без указания границ:

marks[:5:2]
marks[1::2]
marks[::2]

Если шагом является отрицательное число, то перебор элементов осуществляется с конца списка, например:

marks[::-1]
marks[::-2]

Вообще, механизм срезов работает абсолютно также как и со строками, только здесь они применяются к спискам.

Но, учитывая, что списки относятся к изменяемым типам данных, то со срезами можно выполнять одну дополнительную операцию – изменение группы элементов. Например, для списка marks мы хотим 3-ю и 4-ю оценки представить в виде строк. Это можно сделать, следующим образом:

marks[2:4] = ["хорошо", "удовлетв."]

И теперь коллекция содержит данные:

[2, 3, ‘хорошо’, ‘удовлетв.’, 5, 2]

Видите, как легко и просто это можно сделать. Или, другой пример, перебрать все элементы через один и присвоить им 0:

marks[::2] = [0, 0, 0]

Правда, такая конструкция содержит потенциальную ошибку. Если увеличить размер списка:

marks += [3]

и повторить операцию:

marks[::2] = [0, 0, 0]

то получим ошибку, так как число замен здесь уже четыре, а не три. Поэтому, в таких присваиваниях лучше явно указывать границы срезов:

marks[:5:2] = [0, 0, 0]

Также, для группового присваивания можно использовать и такой синтаксис:

marks[2:4] = 10, 20

Сравнение списков

В заключение этого занятия рассмотрим возможности сравнения списков между собой с помощью операторов:

, <, ==, !=

[1, 2, 3] == [1, 2, 3]   # True
[1, 2, 3] != [1, 2, 3]   # False
[1, 2, 3] > [1, 2, 3]    # False

В последнем сравнении получим False, т.к. списки равны, но если записать так:

[10, 2, 3] > [1, 2, 3]  # True

то первый список будет больше второго. Здесь сравнение больше, меньше выполняется по тому же принципу, что и у строк: перебираются последовательно элементы, и если текущий элемент первого списка больше соответствующего элемента второго списка, то первый список больше второго. И аналогично, при сравнении меньше:

[10, 2, 3] < [1, 2, 3]  # False

Все эти сравнения работают с однотипными данными:

[1, 2, "abc"] > [1, 2, "abc"]  # False

сработает корректно, а вот так:

[1, 2, 3] > [1, 2, "abc"]

произойдет ошибка, т.к. число 3 не может быть сравнено со строкой «abc».

На этом завершим очередное занятие. Надеюсь, вы теперь хорошо себе представляете механизм срезов, а также знаете, как выполняется сравнение списков между собой. После закрепления материала практическими заданиями, жду вас всех на следующем уроке.

Урок 15 · Часть I. Основы Python

Основные методы списков

Источник: python3-osnovnye-metody-spiskov

На этом занятии мы свами познакомимся с основными методами, которые есть у списков. Что такое методы вам должно быть уже известно, об этом была речь, когда мы рассматривали методы строк. Кратко напомню, что список – это объект и с этим объектом связаны функции, которые и называются его методами.

Иллюстрация к уроку

Давайте предположим, что у нас имеется список из чисел:

a = [1, -54, 3, 23, 43, -45, 0]

и мы хотим в конец этого списка добавить еще одно значение. Это можно сделать с помощью метода:

a.append(100)

Данный метод append ничего не возвращает, а меняет сам список. Поэтому писать здесь конструкцию вида:

a = a.append(100)

не следует, так как это приведет к потере данных. Этим методы списков отличаются от методов строк, когда мы записывали:

string="Hello"
string = string.upper()

Здесь метод upper возвращает измененную строку, поэтому все работает как и ожидается. А метод append ничего не возвращает, и присваивать значение None переменной a не имеет смысла.

Учитывая, что список может содержать самые разные данные, то в методе append можно прописывать не только число, но, например, строку:

a.append("hello")

тогда в конец списка будет добавлен этот элемент. Или, булевое значение:

a.append(True)

Или еще один список:

a.append([1,2,3])

И так далее. Главное, чтобы было указано одно конкретное значение. Например, вот так работать не будет:

a.append(1,2)

Если нам нужно вставить новый элемент в произвольную позицию, то используется метод:

a.insert(3, -1000)

Здесь мы указываем индекс вставляемого элемента и далее значение самого элемента.

Следующий метод remove удаляет элемент по значению:

a.remove(True)
a.remove('hello')

Он находит первый подходящий элемент и удаляет его, остальные не трогает. Если же указывается несуществующий элемент:

a.remove('hello2')

то возникает ошибка. Еще один метод для удаления

a.pop()

выполняет удаление последнего элемента и при этом, возвращает его значение. В самом списке последний элемент пропадает. То есть, с помощью этого метода можно сохранять удаленный элемент в какой-либо переменной:

end = a.pop()

Также в этом методе можно указывать индекс удаляемого элемента, например:

a.pop(3)

Если нам нужно очистить весь список – удалить все элементы, то можно воспользоваться методом:

a.clear()

Получим пустой список. Следующий метод

a = [1, -54, 3, 23, 43, -45, 0]
c = a.copy()

возвращает копию списка. Это эквивалентно конструкции:

c = list(a)

В этом можно убедиться по разным id этих объектов:

id(c)
id(a)

Следующий метод count позволяет найти число элементов с указанным значением:

c.count(1)
c.count(-45)

Если же нам нужен индекс определенного значения, то для этого используется метод index:

c.index(-45)
c.index(1)

возвратит 0, т.к. берется индекс только первого найденного элемента. Но, мы здесь можем указать стартовое значение для поиска:

c.index(1, 1)

Здесь поиск будет начинаться с индекса 1, то есть, со второго элемента. Или, так:

c.index(23, 1, 5)

Ищем число 23 с 1-го индекса и по 5-й не включая его. Если элемент не находится

c.index(23, 1, 3)

то метод приводит к ошибке. Чтобы этого избежать в своих программах, можно вначале проверить: существует ли такой элемент в нашем срезе:

23 in c[1:3]

и при значении True далее уже определять индекс этого элемента.

Следующий метод

c.reverse()

меняет порядок следования элементов на обратный.

Ну и последний метод

c.sort()

выполняет сортировку элементов списка по возрастанию. Для сортировки по убыванию, следует этот метод записать так:

c.sort(reverse=True)

Причем, этот метод работает и со строками:

lst = ["Москва", "Санкт-Петербург", "Тверь", "Казань"]
lst.sort()

Здесь используется лексикографическое сравнение, о котором мы говорили, когда рассматривали строки.

Отличие метода sort() от ранее рассмотренной функции sorted() в том, что метод меняет сам список, а функция sorted() возвращает новый отсортированный список, не меняя начальный.

Это все основные методы списков, которые вам следует знать и применять в практике программирования:

Метод Описание
append() Добавляет элемент в конец списка
insert() Вставляет элемент в указанное место списка
remove() Удаляет элемент по значению
pop() Удаляет последний элемент, либо элемент с указанным индексом
clear() Очищает список (удаляет все элементы)
copy() Возвращает копию списка
count() Возвращает число элементов с указанным значением
index() Возвращает индекс первого найденного элемента
reverse() Меняет порядок следования элементов на обратный
sort() Сортирует элементы списка

Как всегда, для закрепления материала обязательно пройдите практические задания и переходите к следующему уроку.

Урок 16 · Часть I. Основы Python

Вложенные списки, многомерные списки

Источник: python3-vlozhennye-spiski-mnogomernye-spiski

Это заключительное занятие по спискам языка Python. Сегодня мы с вами узнаем, как формировать вложенные списки и работать с ними. Но сначала, что это такое и зачем они нужны.

Иллюстрация к уроку

Давайте представим, что нам в программе нужно хранить изображение. Для примера я нарисовал его небольшим, всего 5 на 5 пикселей. Каждый цвет представляется своим уникальным числом. Я, условно, обозначил их 1, 7, 6, 11 и 3. Значит, для представления этих данных нам нужен двумерный список 5x5 с соответствующими числовыми значениями. Мы уже знаем, как задавать одномерный список:

line = [1, 7, 6, 11, 3]

Но так он описывает всего лишь одну строку. А нам нужно хранить пять таких строк. Учитывая, что элементом списка может быть другой список, то данное изображение можно задать так:

img = [[1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3]]

Иллюстрация к уроку

Мы здесь внутри первого списка определили пять вложенных и в результате получили двумерный список. Кстати, его можно было бы сформировать и проще, учитывая, что все вложенные списки одинаковы, на основе списка line, следующим образом:

img = [line[:], line[:], line[:], line[:], line[:]]

В итоге получим такой же список с независимыми строками:

[[1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3], [1, 7, 6, 11, 3]]

Вот эта последняя запись нам показывает структуру представления многомерных данных на уровне списков. Первый главный список хранит ссылки на вложенные списки. А вложенные списки уже хранят ссылки на соответствующие числа, представляющие тот или иной цвет. Поэтому, если взять первый элемент главного списка:

img[0]

то мы получим список, представляющий первую строку (или, первый столбец в зависимости от интерпретации программистом этих данных). Главное, что мы получаем доступ к первому вложенному списку. А раз это так, то можно записать еще одни квадратные скобки и из этого вложенного списка взять, допустим, второй элемент:

img[0][1]

Также, можно заменить, например, вторую строку на новую, допустим, такую:

img[1] = [0, 0, 0, 0, 0]

или, то же самое, в более краткой форме:

img[1] = [0] * 5

Что в итоге здесь произошло? Мы сформировали новый объект – список из нулей, связали с ним вторую ссылку главного списка, а прежний список был автоматически удален сборщиком мусора.

Иллюстрация к уроку

Если бы мы хотели изменить значения уже существующего вложенного списка, то следовало бы обратиться к его элементам, например, через механизм срезов:

img[1][:] = [0] * 5

и присвоить его элементам новые числовые значения. Вот так это работает в деталях.

В качестве второго примера мы представим вложенными списками строки известного стихотворения на уровне отдельных слов:

Люблю тебя, Петра творенье,
Люблю твой строгий, стройный вид,
Невы державное теченье,
Береговой ее гранит,

Здесь в каждой строке разное число слов, но для вложенных списков – это не проблема. Они могут иметь разное число элементов:

t = [["Люблю", "тебя", "Петра", "творенье"],
     ["Люблю", "твой", "строгий", "стройный", "вид"],
     ["Невы", "державное", "теченье"],
     ["Береговой", "ее", "гранит"]
     ]

Иллюстрация к уроку

В результате получаем следующую структуру наших данных. Здесь также для доступа к первой строке достаточно указать первый индекс:

t[0]

а к отдельному слову этой строки, второй индекс:

t[0][2]

Если же мы хотим изменить какое-либо слово, то это делается, следующим образом:

t[0][2] = "Питон"

В итоге, первая строка принимает вид:

[‘Люблю’, ‘тебя’, ‘Питон’, ‘творенье’]

Мало того, мы можем добавить новую строку, используя известный метод:

t.append(["Твоих", "оград", "узор", "чугунный"])

Удалять список:

del t[1]

И так далее, то есть, делать с вложенными списками все те же операции, что и с обычными данными.

В заключение покажу пример многомерного списка с разными уровнями глубины:

A = [[[True, False], [1, 2, 3]], ["матрица", "вектор"]]

Смотрите, здесь

A[0]

это двумерный список, а

A[1]

одномерный вложенный список. Соответственно, для третьего уровня вложенности можем использовать три индекса для доступа к отдельному элементу, например:

A[0][1][0]

Здесь мы берем первый элемент, затем второй вложенный список и из него выбираем первый элемент.

Вот так в Python можно определять многомерные списки разной структуры и разного уровня вложенности.

Для закрепления этого материала подготовлены практические задания, после которых жду вас на следующем уроке.

Практика 3 · Часть I. Основы Python

Списки

Задания для закрепления темы · решений нет

Цели обучения

  • Создавать и изменять списки через индексацию, срезы и методы
  • Использовать len, sum, min, max и проверку принадлежности
  • Работать со вложенными списками (матрицами)

Задания

Задание 1. Циклический сдвиг влево

Сложность: лёгкое

Реализуйте rotate_left(items: list, k: int) -> list: верните новый список, сдвинутый влево на k позиций (k может быть больше длины; используйте остаток от деления). Пустой список → пустой список.

Требования:

  • Не изменяйте исходный список
  • Предпочтительно через срезы

Пример:

rotate_left([1, 2, 3, 4], 1)  # [2, 3, 4, 1]
rotate_left([1, 2, 3], 5)     # [3, 1, 2]

Задание 2. Уникальные с сохранением порядка

Сложность: лёгкое

Реализуйте unique_keep_order(items: list) -> list: только первое вхождение каждого значения, порядок сохранён.

Требования:

  • Не используйте set, если хотите чисто списковое решение (допустимо, но необязательно)
  • Исходный список не менять

Пример:

unique_keep_order([3, 1, 3, 2, 1])  # [3, 1, 2]

Задание 3. Разбиение на куски

Сложность: среднее

Реализуйте chunk(items: list, size: int) -> list[list]: разбейте на последовательные куски длины size. Последний кусок может быть короче. Если size <= 0, выбросьте ValueError.

Требования:

  • Верните список списков
  • Пустой ввод → []

Пример:

chunk([1, 2, 3, 4, 5], 2)  # [[1, 2], [3, 4], [5]]

Задание 4. Транспонирование матрицы

Сложность: среднее

Реализуйте transpose(matrix: list[list]) -> list[list]. Считайте матрицу непустой прямоугольной (все строки одной длины).

Требования:

  • Не используйте zip, если ещё не изучали — вложенные циклы / сбор списков допустимы
  • Исходная матрица не менять

Пример:

transpose([[1, 2, 3], [4, 5, 6]])
# [[1, 4], [2, 5], [3, 6]]

Задание 5. Разворачивание на один уровень

Сложность: среднее

Реализуйте flatten(nested: list) -> list: разверните один уровень вложенности. Элементы, не являющиеся list, оставьте как есть; элементы-списки «растяните».

Требования:

  • Только один уровень (не рекурсировать глубже)
  • Используйте extend / конкатенацию

Пример:

flatten([1, [2, 3], 4, [5]])  # [1, 2, 3, 4, 5]
flatten([1, [2, [3]]])        # [1, 2, [3]]

Задание 6. Таблица результатов

Сложность: сложное

Есть список записей игроков: пары [name, score], например [["Ann", 12], ["Bob", 9], ["Ann", 5]].

Реализуйте:

  • total_scores(records: list[list]) -> list[list] — суммарные очки по имени в виде [name, total], имена в порядке первого появления
  • top_player(records: list[list]) -> str — имя с наибольшей суммой (при ничьей — самое раннее имя)

Требования:

  • Используйте списки (и вложенные списки); dict опционален
  • Пустые records → total_scores возвращает []; top_player возвращает ""

Пример:

records = [["Ann", 12], ["Bob", 9], ["Ann", 5]]
total_scores(records)  # [["Ann", 17], ["Bob", 9]]
top_player(records)    # "Ann"

Глава 4

Условные операторы

Урок 17 · Часть I. Основы Python

Условный оператор if. Конструкция if-else

Источник: python3-uslovnyy-operator-if-konstrukciya-if-else

На этом занятии мы с вами познакомимся с работой условного оператора if. Что он делает и для чего нужен? Помните, на одном из прошлых занятий, мы с вами рассматривали операции сравнения, например, проверяли:

4 > 2

или с переменной:

a = 5
a < 0

На выходе получали булевы значения True и False. Но ничего не говорили, как их дальше использовать в программе. Пришло время восполнить этот пробел. Оператор if позволяет выполнить группу операторов, при истинности указанного условия. Давайте я сразу поясню эту конструкцию на конкретном примере. Предположим, мы пишем программу для вычисления модуля числа:

x = -4
if x < 0:
    x = -x
print(x)

Смотрите, после оператора if записываем условие, то есть, определяем, что x отрицательное число. И если это так, то оператор меньше вернет значение True, условие сработает и будет выполнена строчка x = -x. А вот следующая строчка (функция print()) стоит уже вне этого условия и будет выполняться всегда. Так как Python «понимает», что находится в блоке условного оператора, а что нет? Все дело в форматировании текста программы. Когда мы ставим двоеточие, то открывается новый блок, где может располагаться множество операторов. И все конструкции языка Python, что имеют отступ (обычно четыре пробела) относительно оператора if, будут располагаться внутри этого блока. Именно поэтому строчка x = -x выполняется только при истинности условия x < 0, а функция print() стоит уже после оператора if и выполняется всегда.

Запустим эту программу и убедимся, что все работает. Видим значение 4, то есть, условие x < 0 вернуло значение True, оператор if сработал и выполнилась строчка x = -x.

А давайте теперь определим:

x = 4

В этом случае также увидим 4, но строка x = -x уже не выполнялась, так как условие для значения False не срабатывает. И, смотрите, если функцию print() сместить на уровень предыдущего оператора:

x = 4
if x < 0:
    x = -x
    print(x)

то в консоли мы уже ничего не увидим. Это произошло, как раз, из-за того, что эта функция переместилась внутрь блока оператора if и будет теперь выполняться только при истинности условия. Вернем, снова:

x = -4

и, теперь, видим значение 4 в консоли. Этот пример показывает, что в Python форматирование текста программы имеет ключевое значение. И благодаря этому, кстати, программы становятся более наглядными и читабельными, а также заставляют начинающих программистов правильно их оформлять. На мой взгляд – это большой плюс данного языка программирования.

Чтобы все было понятно, приведу еще пару примеров. Предположим, мы хотим поменять значения двух переменных:

a = float(input("a: "))
b = float(input("b: "))

Если a меньше b:

if a < b:
    a, b = b, a
print(a, b)

Также можно прописывать более сложные, составные условия, например, для проверки попадания числа в заданный диапазон:

x = int(input())
if x >= -4 and x <= 10:
    print("x в диапазоне [-4; 10]")

О составных условиях мы с вами уже говорили на отдельном занятии, поэтому здесь все должно быть понятно.

Или, то же самое условие в Python допускается записывать и так:

if -4 <= x <= 10:

То есть, в качестве условия можно записывать любые конструкции, которые можно интерпретировать как истину (True) и ложь (False). Даже так, просто указав числовое значение:

x = int(input())
if x:
    print("x = True")

Мы здесь получим истину, если x не равен нулю. Наконец, в условиях можно явно прописывать булево значение:

if True:
    print("True")

Конечно, это лишь пример и практического смысла в таком операторе особо нет.

Наконец, мы можем использовать операторы проверки для списков. Например, студент имеет следующие оценки по результатам сдачи сессии:

marks = [3, 3, 4, 2, 4]

и мы хотим узнать, будет ли он отчислен. Выполним для этого, следующую проверку:

if 2 in marks:
    print("студент будет отчислен")

Вот в этом последнем примере нам бы хотелось в противном случае выдать сообщение, что студент успешно сдал сессию. Это лучше всего реализовать с помощью оператора else:

marks = [3, 3, 4, 2, 4]
if 2 in marks:
    print("студент будет отчислен")
else:
    print("студент успешно сдал сессию")

То есть, смотрите, если срабатывает первое условие, то блок else не выполняется. И, наоборот, если условие не срабатывает, то выполняется блок else. Это слово можно перевести как «иначе» и получается либо выполнение первого блока, либо второго, но никогда не обоих вместе. То есть, здесь определены два взаимоисключающих случая. Действительно, студен не может одновременно быть отчисленным и успешно сдавшим сессию (будем полагать, что по собственному желанию он не уходит).

Или другой подобный пример:

x = int(input())
if x < 0:
    print("x - отрицательное число")
else:
    print("x - неотрицательное число")

Очевидно, что x не может быть одновременно отрицательным и неотрицательным, поэтому для проверки такого условия можно использовать оператор else.

В последнем примере этого занятия мы проверим введенное число на четность. Сделать это можно так:

x = int(input())
if x % 2 == 0:
    print("x - четное число")
else:
    print("x - нечетное число")

Надеюсь, из всех этих примеров, вам понятно, что из себя представляет условный оператор if, как в нем можно прописывать различные условия и как работает оператор else. Вас еще ждет набор практических заданий, а я буду вас ждать на следующем уроке.

Урок 18 · Часть I. Основы Python

Вложенные условия и множественный выбор. Конструкция if-elif-else

Источник: python3-vlozhennye-usloviya-i-mnozhestvennyy-vybor-konstrukciya-if-elif-else

Мы продолжаем изучение условных операторов языка Python. На предыдущем занятии мы познакомились с работой оператора if проверки условий. И говорили, что внутри блока этого оператора могут быть любые конструкции языка Python, в том числе и другие условия. Давайте посмотрим на примерах, как это работает.

Иллюстрация к уроку

Предположим, что сначала в первом условии нам нужно проверить число на четность, а затем, определить, является ли это число цифрой или каким-либо другим числом:

x = int(input())
if x % 2 == 0:
    if 0 <= x <= 9:
        print("x - четная цифра")
    else:
        print("x - четное число")

Как видите, это удобно сделать с помощью вложенного условия. И, обратите внимание, оператор else здесь относится именно ко второму условию, так как записан на одном уровне с ним. А вот, если бы мы его прописали без отступов:

if x % 2 == 0:
    if 0 <= x <= 9:
        print("x - четная цифра")
else:
    print("x - четное число")

то он стал бы относиться к первому условию. Программа стала бы работать иначе и, вообще говоря, некорректно для данной задачи.

Я верну отступы для блока else и добавлю еще один такой блок для первого условия:

x = int(input())
if x % 2 == 0:
    if 0 <= x <= 9:
        print("x - четная цифра")
    else:
        print("x - четное число")
else:
    print("x - нечетное число")

В результате, у нас обрабатываются все возможные исходы для числа x.

Другой пример – поиск наибольшего среди трех чисел a, b и c:

a = int(input("a: "))
b = int(input("b: "))
c = int(input("c: "))
 
if a > b:
    if a > c:
        print("a -> max")
    else:
        print("c -> max")
else:
    if b > c:
        print("b -> max")
    else:
        print("c -> max")

Иллюстрация к уроку

Думаю, из этих примеров вам стало понятно, как использовать вложенные условия. Конечно, степень вложенности может быть любой, но все будет работать по аналогии. В практике реального программирования лучше избегать больших вложенностей. Нормальным считается до трех вложений. Если у вас выходит больше, то, скорее всего, что-то делаете не так и структуру программы следует пересмотреть.

Оператор elif

Во второй части этого занятия я хочу рассказать вам о способе реализации множественного выбора. Что это такое? Представьте, что мы просим пользователя выбрать один из пунктов меню:

  1. 1. Курс по Python
  2. 2. Курс по С++
  3. 3. Курс по Java
  4. 4. Курс по JavaScript

Используя текущие знания, мы можем реализовать это так:

item = int(input())
 
if item == 1:
    print("Выбран курс по Python")
else:
    if item == 2:
        print("Выбран курс по C++")
    else:
        if item == 3:
            print("Выбран курс по Java")
        else:
            if item == 4:
                print("Выбран курс по JavaScript")
            else:
                print("Неверный пункт")

Но эту же логику можно реализовать проще и нагляднее, используя еще один условный оператор

elif = else if

То есть, все конструкции с else if мы можем просто заменить на elif, получим:

if item == 1:
    print("Выбран курс по Python")
elif item == 2:
    print("Выбран курс по C++")
elif item == 3:
    print("Выбран курс по Java")
elif item == 4:
    print("Выбран курс по JavaScript")
else:
    print("Неверный пункт")

Видите, как это удобнее, когда нам в программе нужно реализовать выбор какого-то одного значения из множества доступных. Причем, последовательность операторов должна быть именно такой:

if – elif – else

После if можно опускать любой из них (или оба не прописывать), но порядок следования всегда нужно соблюдать именно таким.

Конечно, помимо проверок на равенство после elif можно прописывать любые условия. Например, вводим с клавиатуры целое положительное x и для него определяем число десятков:

x = int(input())
 
if x < 0:
    print("x должно быть положительным")
elif 0 <= x <= 9:
    print("x - цифра")
elif 10 <= x <= 99:
    print("x - двузначное число")
elif 100 <= x <= 999:
    print("x - трехзначное число")

В целом это все, что я хотел вам рассказать про условный оператор if. На следующем занятии мы еще затронем тему тернарных условий. А сейчас вас ждут практические задания по этой теме, после чего переходите к следующему уроку.

Урок 19 · Часть I. Основы Python

Тернарный условный оператор. Вложенное тернарное условие

Источник: python3-ternarnyy-uslovnyy-operator-vlozhennoe-ternarnoe-uslovie

На этом занятии по курсу языка Python мы поговорим о тернарном условном операторе, который появился в версии 2.5. Как всегда, вначале поясню, что это за оператор. В простейшем варианте его синтаксис можно представить так:

<значение 1> if <условие> else <значение 2>

Он возвращает значение 1, если условие истинно, а иначе – значение 2. Давайте поясню его работу на конкретном примере. Предположим, у нас имеются две переменные:

a = 12
b = 7

и мы хотим для них определить максимальное значение. Используя имеющиеся знания, это можно было бы сделать так:

if a > b:
    res = a
else:
    res = b
 
print(res)

А с использованием тернарного оператора это можно реализовать так:

res = a if a > b else b

Видите, какая простая, понятная и компактная запись в итоге получилась. Это одно из удобств данного оператора. Но, все же, между предыдущей программой с условным оператором if и тернарным оператором есть одно принципиальное отличие. Тернарный оператор автоматически возвращает результат. В данном примере – это или переменная a или переменная b. Тогда как обычный условный оператор предназначен для выполнения блока кода по определенному условию и сам по себе не возвращает никаких значений. То есть, если бы мы попытались записать что-то вроде:

d = if a > b:

то попросту возникла бы синтаксическая ошибка – так делать нельзя. А вот результат работы тернарного оператора мы, обычно, сохраняем в некой переменной.

Второе важное отличие – в тернарном операторе нет внутренних блоков, где бы мы могли записывать несколько операторов. Вместо a и b можно прописывать только одну какую-либо конструкцию. Часто это некое значение, или результат работы операторов, например, арифметических:

res = a + 2 if a > b else b - 5

Так делать вполне допустимо. Или же, можно использовать какие-либо функции:

a = -12
b = -7
res = abs(a) if a > b else abs(b)

То есть, здесь может быть любая конструкция языка Python, но только одна. По идее, можно даже записать функцию print():

res = print(a) if a > b else print(b)

Но тогда переменная res будет принимать значение None, так как функция print() ничего возвращает, то есть, None.

Давайте приведу еще один пример. Пусть имеется некая строка и способ преобразования этой строки:

s = 'python'
t = 'upper'

Пусть ‘upper’ означает преобразование строки s в верхний регистр. Сделаем это через тернарный оператор, следующим образом:

res = s.upper() if t == 'upper' else s

Видите, как элементарно и просто реализуется эта идея? В этом большой плюс тернарного оператора. Вообще, его можно рассматривать, как некий активный объект, который возвращает определенное значение в зависимости от условия. Благодаря этому, его можно вызывать прямо внутри различных конструкций, например:

[1, 2, a if a < b else b, 4, 5]
"a - " + ("четное" if a % 2 == 0 else "нечетное") + " число"

Обратите внимание здесь на круглые скобки. Они необходимы, чтобы следующий оператор + применялся к результирующей строке, а не к тернарному оператору. Если круглые скобки убрать, то последняя добавка пропадет.

Или его можно указать, как один из аргументов функции:

max(1, 5, a if a > 0 else b, 4, 5)

Я, надеюсь, из этих примеров вам стал понятен принцип использования тернарного условного оператора.

Вложенный тернарный оператор

Так как внутри тернарного оператора можно использовать любые конструкции, то кто нам мешает вложить один тернарный оператор в другой, например, так:

<r_1> if <c_1> else <r_2> if <c_2> else <r_3>

или так:

<r_1> if <c_1> else <r_2> if <c_2> else <r_3> if <c_3> else <r_4>

Сразу скажу, что это делается крайне редко и лучше избегать таких вложений, так как восприятие и понимание текста программы резко снижается.

Приведу один пример с такими вложениями. На предыдущем занятии мы с вами записывали вложенные условия для определения максимального из трех чисел. Давайте сделаем то же самое, но через тернарные операторы. Программа будет такой:

a = 2
b = 3
c = -4
 
d = (a if a > c else c) if a > b else (b if b > c else c)
print(d)

Иллюстрация к уроку

Думаю, общий принцип здесь понятен. Сначала проверяем условие a > b, затем, в зависимости от результата проверки, выполняется или левый тернарный оператор, или правый. Причем, опят же здесь обязательно вложенные тернарные операторы следует взять в круглые скобки, чтобы тернарная конструкция if-else воспринималась как единое целое во вложениях.

Вам осталось закрепить этот материал практическими заданиями и, затем, переходите к следующему уроку.

Практика 4 · Часть I. Основы Python

Условные операторы

Задания для закрепления темы · решений нет

Цели обучения

  • Ветвить выполнение через if, elif и else
  • Аккуратно вкладывать условия
  • Для простого выбора значения предпочитать тернарный оператор

Задания

Задание 1. Метка знака

Сложность: лёгкое

Реализуйте sign_label(x: float) -> str: верните "positive", "negative" или "zero".

Требования:

  • Используйте if / elif / else
  • Считайте -0.0 как "zero"

Пример:

sign_label(-3)  # "negative"
sign_label(0)   # "zero"

Задание 2. Оценка по баллам

Сложность: лёгкое

Реализуйте letter_grade(score: int) -> str:

БаллыОценка
90–100A
80–89B
70–79C
60–69D
0–59F

Вне 0..100 → "invalid".

Требования:

  • Используйте цепочку if-elif-else

Пример:

letter_grade(85)  # "B"
letter_grade(101) # "invalid"

Задание 3. Цена билета

Сложность: среднее

Реализуйте ticket_price(age: int, is_student: bool) -> int:

  • База: 10
  • Возраст < 12 или >= 65: 5
  • Студенты (любого возраста) получают скидку 2 от цены после возрастной скидки, но не ниже 3
  • Некорректный возраст (< 0) → выбросьте ValueError

Требования:

  • Чётко объедините правила возраста и студенчества
  • Верните int

Пример:

ticket_price(20, False)  # 10
ticket_price(20, True)   # 8
ticket_price(10, True)   # 3

Задание 4. Високосный год

Сложность: среднее

Реализуйте is_leap_year(year: int) -> bool (григорианский календарь): делится на 400, либо делится на 4, но не на 100.

Требования:

  • Предпочтительно одно булево выражение или понятная цепочка if
  • Считайте year > 0

Пример:

is_leap_year(2000)  # True
is_leap_year(1900)  # False
is_leap_year(2024)  # True

Задание 5. Ограничение через тернарный оператор

Сложность: среднее

Реализуйте clamp(x, low, high), используя только вложенные тернарные выражения (без операторов if): верните x, ограниченный диапазоном [low, high]. Считайте low <= high.

Требования:

  • Один return с тернарным(и) выражением(ями)
  • Работает для int и float

Пример:

clamp(5, 0, 10)   # 5
clamp(-1, 0, 10)  # 0
clamp(99, 0, 10)  # 10

Задание 6. Победитель в «камень–ножницы–бумага»

Сложность: сложное

Реализуйте rps_winner(a: str, b: str) -> str. Допустимые ходы: "rock", "paper", "scissors" (без учёта регистра после нормализации).

Верните "first", "second", "draw" или "invalid", если хотя бы один ход неизвестен.

Требования:

  • Нормализуйте через .lower().strip()
  • Используйте условия (вложенные или elif); небольшая таблица правил как вложенный dict опциональна

Пример:

rps_winner("rock", "scissors")  # "first"
rps_winner("paper", "PAPER")    # "draw"
rps_winner("lizard", "rock")    # "invalid"

Глава 5

Циклы

Урок 20 · Часть I. Основы Python

Оператор цикла while

Источник: python3-operator-cikla-while

На этом занятии начнем знакомиться с еще одним ключевым элементом компьютерных программ – циклами. Вначале, давайте я на простом примере покажу, о чем идет речь. Представим, что нам нужно вычислить сумму целых чисел от 1 до N. Причем, N может быть сколько угодно большой: тысяча, миллион и так далее. Понятно, что мы не можем здесь просто записать операторы сложения чисел друг за другом для вычисления этой последовательности. Тем более, что на момент написания программы, N может быть неизвестна. Вот в таких ситуациях нам на помощь, как раз, и приходят циклы.

Иллюстрация к уроку

Циклы позволяют реализовывать некие повторяющиеся действия. Например, предположим, что маленькие панды прыгают с горки в течение часа, пока мама-панда не позовет всех к столу – кушать. На уровне текста это можно записать, так:

цикл (пока не прошел час):
прыгаем с горки

То есть, пока истинно условие, цикл работает, как только условие становится ложным – прошел час, цикл завершается. Ровно так работает цикл while, о котором и пойдет речь на нашем занятии. Он имеет, следующее определение (синтаксис):

Иллюстрация к уроку

Вначале записывается ключевое слово while, затем, условие работы цикла, ставится двоеточие для определения блока операторов, работающих внутри этого цикла. Такой блок еще называют телом цикла, а ключевое слово while с условием – заголовком цикла.

Обратите внимание на форматирование. Здесь также, как и в условных операторах, набор операторов внутри тела цикла должны иметь одинаковые отступы относительно ключевого слова while.

Давайте вернемся к исходной задаче – вычисления суммы чисел от 1 до N и посмотрим, как здесь нам поможет цикл while. Вначале определим три вспомогательные переменные: N – значение последнего слагаемого; s – для хранения вычисленной суммы (начальное значение 0); i – значение текущего слагаемого (начинается с 1):

N = 1000
s = 0
i = 1

Далее, так как сумму нужно вычислять, пока слагаемое i не достигнет значения N, то условие цикла можно определить, следующим образом:

while i <= N:

А внутри цикла будем выполнять следующие действия:

s += i
i += 1

Вначале i равна 1 и эта единица прибавляется к сумме s. После чего i увеличивается на 1 и становится равной 2. Затем, выполняется проверка условия цикла. Пока оно у нас истинно, поэтому снова попадаем внутрь тела цикла и к s прибавляется уже значение 2, а i опять увеличиваем на 1 и оно становится равным 3. И так до тех пор пока i не станет больше N. К этому моменты мы просуммируем все числа и результат будет храниться в переменной s. Вот принцип работы циклов, причем, во всех языках программирования, не только в Python.

Иллюстрация к уроку

Также однократное выполнение тела цикла в программировании называют итерацией. Я буду часто использовать этот термин, поэтому привел его, чтобы вы меня правильно понимали.

Давайте реализуем теперь эту программу на Python и посмотрим как она сработает.

Возможно, у вас возник вопрос: а какие условия можно прописывать в циклах? В действительности, все те же самые, что и в условных операторах. В том числе и составные. Например, давайте будем вычислять сумму пока не дойдем до слагаемого N или до значения 50. Так как цикл работает, пока истинно условие, то его следует записать, так:

while i <= N and i <= 50:
    ...

Смотрите, мы здесь указали делать цикл пока i меньше или равна N и меньше или равна 50. Если хотя бы одно из этих подусловий окажется ложным, то и все составное условие также станет ложным и цикл завершится. В результате, i достигнет или N или 50. Вот это нужно хорошо себе представлять: в циклах прописываются условия их работы, а не завершения.

Используя этот же цикл, мы легко можем поменять условие задачи и вычислить сумму чисел, которые меняются через один:

1, 3, 5, 7, …

Для этого достаточно счетчик i увеличивать не на 1, а сразу на два:

i += 2

При этом, условие цикла можно оставить прежним. Он завершится, как только i превысит N или 50. Здесь уже нет гарантии, что последнее слагаемое будет именно N или 50, но нам это и не нужно, мы лишь указываем завершить цикл, когда превысим одно из этих значений.

Конечно, внутри тела цикла можно записывать любые операторы, в том числе и функцию print(). Давайте, например, отобразим в консоли цифры от 0 до 9:

i = 0
 
while i < 10:
    print(i)
    i += 1

Я здесь указал условие i меньше 10, а не i <= 9, так как оператор < работает несколько быстрее оператора <=. Поэтому на практике предпочтительно, по возможности, применять не составные, а простые операторы: меньше, больше, равно и не равно. Хотя использование <= или >= не критично и вполне допустимо. Но, все же, по возможности, лучше прописывать простые операторы в условиях циклов.

Если нам нужно реализовать убывающую последовательность чисел, например:

-1, -2, -3, …, -N

то это делается аналогично, только с уменьшающимся счетчиком:

N = -10
i = -1
 
while i >= N:
    print(i)
    i -= 1

Вообще, счетчик в цикле можно менять произвольным образом, например, умножая на два:

i *= 2

Здесь нет никаких ограничений.

В заключение этого занятия приведу еще пару примеров с оператором цикла while. Предположим, что пользователь вводит пароль, до тех пор, пока не введет верно. Это можно сделать, следующим образом:

pass_true = 'password'
ps = ''
 
while ps != pass_true:
    ps = input("Введите пароль: ")
 
print("Вход в систему осуществлен")

Вначале мы задаем пароль для проверки, затем, переменную ps, которая хранит введенный пользователем пароль и делаем цикл, пока пароли не совпадают. Обратите внимание, условие цикла – пока пароли не совпадают. Опять же, всегда следует помнить, что мы прописываем условие работы, а не остановки цикла. Поэтому здесь нам нужно проверять на несовпадение паролей и запрашивать у пользователя пароль, пока они не совпадут.

Наконец, внутри цикла while можно прописывать, например, и условные операторы. Давайте выведем все числа, кратные 3, которые нам встретятся при переборе целых значений от 1 до N:

N = 20
i = 1
 
while i <= N:
    if i % 3 == 0:
        print(i)
 
    i += 1

Как видите, все достаточно просто и очевидно. Здесь главное не забывать о правильном форматировании текста программы: функция print() находится внутри условия if, поэтому перед ней необходимы отступы. А сам блок условия имеет отступы относительно оператора while. Так определяются вложенные блоки операторов в языке Python. И об этом всегда следует помнить.

На этом мы завершим первое знакомство с оператором цикла while. На следующем уроке продолжим эту тему. А для закрепления текущего материала не забудьте выполнить несколько практических заданий. До встречи на следующем уроке.

Урок 21 · Часть I. Основы Python

Операторы циклов break, continue и else

Источник: python3-operatory-ciklov-break-continue-i-else

Мы продолжаем курс по языку Python. Это занятие начнем со знакомства операторов break и continue цикла while. Суть этих операторов, в следующем:

  • break – досрочное завершение цикла;
  • continue – пропуск одной итерации цикла.

Давайте сначала рассмотрим работу оператора break. Если в качестве условия цикла записать значение True:

print("запуск цикла")
 
i = 0
while True:
    i += 1
 
print("завершение цикла")

То такой цикл будет работать «вечно», он сам никогда не остановится и строчку «завершение цикла» мы не увидим. Программу в этом случае можно только прервать и полностью остановить. Однако, если записать в тело цикла оператор break, то он прервется, как только встретится:

while True:
    i += 1
    break

Обратите внимание, оператор i += 1 один раз будет выполнен, а прерывание сработает только в строчке с оператором break.

Но вы скажете, конечно, зачем писать программы с «вечными» циклами, нужно корректно прописывать условие и все будет хорошо? Часто, именно так и следует поступать. Но бывают ситуации, когда все же требуется досрочно прерывать работу цикла. Например, у нас имеется список с числами:

d = [1, 5, 3, 6, 0, -4]

И мы хотим определить, есть ли среди них хотя бы одно четное значение. Здесь удобно воспользоваться оператором break. Как только встретим первое четное значение, дальнейшую проверку можно не проводить:

d = [1, 5, 3, 6, 0, -4]
flFind = False
i = 0
 
while i < len(d):
    flFind = d[i] % 2 == 0
    if flFind:
        break
 
    i += 1
 
print(flFind)

Конечно, эту же программу можно было бы построить и без break, используя составное условие:

i = 0
while i < len(d) and d[i] % 2 != 0:
    i += 1
 
flFind = i != len(d)

Но, на мой взгляд, первый вариант с break красивее и понятнее, чем второй. Хотя, все дело вкуса – кому, как нравится.

Я, думаю, что принцип работы оператора break понятен. Он прерывает работу любого оператора цикла, как только выполнение программы перейдет к нему.

Следующий оператор continue позволяет пропускать одну итерацию тела цикла. Давайте, опять же, на конкретном примере посмотрим, где и как его целесообразно применять.

Предположим, что мы просим пользователя вводить с клавиатуры числа и все нечетные значения суммируем. Как только пользователь введет 0, подсчет суммы прекращается. Реализовать эту программу удобно, следующим образом:

s = 0
d = 1
while d != 0:
    d = int(input("Введите целое число: "))
    if d % 2 == 0:
        continue
 
    s += d
    print("s = " + str(s))

Смотрите, мы здесь на каждой итерации цикла проверяем, если текущее значение d четное, то последующий подсчет суммы и вывод ее в консоль не выполняется, пропускается. При этом, цикл продолжает свою работу и переходит к следующей итерации, пока пользователь не введет число 0. Благодаря оператору continue мы основную логику программы прописываем непосредственно в теле цикла, а не во вложенном блоке условного оператора. То есть, если программу переписать без continue, то она бы выглядела так:

s = 0
d = 1
while d != 0:
    d = int(input("Введите целое число: "))
    if d % 2 != 0:
        s += d
        print("s = " + str(s))

Здесь получается массивный вложенный блок операторов. Конечно, на производительность это никак не влияет, но, все же такие вложения лучше избегать, так программа становится менее читабельной и удобной для дальнейшего редактирования.

В заключение этого занятия рассмотрим третий оператор циклов else. Да, мы уже говорили об этом операторе, когда рассматривали условия. У циклов он тоже есть и сейчас разберем, как работает.

Синтаксис этого оператора, следующий. После тела цикла прописывается необязательный оператор else, в котором указываются операторы, исполняющиеся после завершения цикла:

Иллюстрация к уроку

И здесь возникает вопрос: а чем блок else отличается от блока операторов, просто идущих после блока while? Ведь когда цикл while завершается, мы так и так переходим к последующим операторам! Но обратите внимание вот на эту на фразу «штатное завершение цикла». Штатное завершение – это когда условие цикла стало равно False и оператор while прекращает свою работу. Только в этом случае мы перейдем в блок else. Давайте я покажу это на конкретном примере. Предположим, что мы вычисляем сумму вида:

S = 1/2 + 1/3 + 1/4 + 1/10 + … + 1/0

И если в этом сумме встречается деление на ноль, то вычисления следует прервать. Реализуем эту программу, следующим образом:

S=0
i=-10
 
while i < 100:
    if i == 0:
        break
 
    S += 1/i
    i += 1
else:
    print("Сумма вычислена корректно")
 
print(S)

Смотрите, если здесь при вычислении суммы встречается деление на 0, то срабатывает break и цикл досрочно прерывается, то есть, завершается в нештатном режиме. В этом случае блок else пропускается и мы не видим сообщения, что сумма вычислена корректно. Если же все проходит штатно и цикл завершается по своему условию, то в консоли появляется сообщение «Сумма вычислена корректно», означающее выполнение блока else.

Надеюсь, из этого примера вам стало понятно назначение оператора else цикла while. Также из этого занятия вы должны себе хорошо представлять работу операторов break и continue. После закрепления этого материала практическими заданиями, жду всех вас на следующем уроке.

Урок 22 · Часть I. Основы Python

Оператор цикла for. Функция range()

Источник: python3-operator-cikla-for-funkciya-range

На предыдущих занятиях мы с вами познакомились с оператором цикла while, а также вспомогательными операторами break, continue и else. На этом занятии вы узнаете о втором операторе цикла for, который довольно часто используется в Python.

Он имеет следующий синтаксис:

for <переменная> in <итерируемый объект>:
оператор 1
оператор 2
…
оператор N

С его помощью очень легко реализовывать перебор, так называемых, итерированных объектов. Что это такое, мы будем говорить на одном из следующих занятий, а сейчас, вам достаточно знать, что это объекты, состоящие из множества элементов, которые можно перебирать. Например, списки или строки.

Как всегда, постичь магию работу этого оператора лучше всего на конкретных примерах. Пусть у нас имеется список:

d = [1, 2, 3, 4, 5]

И мы хотим перебрать все его элементы. Через оператор цикла for сделать это можно, следующим образом:

for x in d:
    print(x)

Или, вместо списка, можно взять строку:

for x in "python":
    print(x)

Тогда переменная x на каждой итерации будет ссылаться на очередной символ этой строки.

Но давайте посмотрим, как все это работает в деталях. Вернемся к примеру со списком. На первой итерации переменная x будет ссылаться на первый элемент со значением 1. Соответственно, функция print() выводит это значение в консоль. На следующей итерации переменная x ссылается уже на второй элемент и print() выводит значение 2. И так до тех пор, пока не будет достигнут конец списка.

Иллюстрация к уроку

В этой демонстрации ключевое, что переменная x ссылается на элемент списка. То есть, если мы захотим изменить значение в списке, используя переменную x, например, вот так:

for x in [1, 2, 3, 4, 5]:
    x = 0

Иллюстрация к уроку

то ничего не получится. Здесь x просто будет ссылаться на другой объект со значением 0, но элементы списка это никак не затронет. То есть, в такой реализации оператора цикла for мы можем лишь перебирать значения элементов и что-то с ними делать, например, вычислять их произведение:

d = [5, 2, 4, 3, 1]
 
p = 1
for x in d:
    p *= x
 
print(p)

А как тогда менять значения элементов в списке с помощью for? Для этого к элементам списка нужно обращаться по индексу. То есть, цикл должен перебирать не элементы списка, а его индексы:

d = [5, 2, 4, 3, 1]
 
for i in [0, 1, 2, 3, 4]:
    d[i] = 0
 
print(d)

Иллюстрация к уроку

В этом случае, мы на каждой итерации цикла, обращаемся сначала к первому элементу списка, присваиваем ему ноль, затем, ко второму элементу, присваиваем ему ноль и так для всех остальных элементов. В итоге меняется сам список.

Однако описывать индексы через еще один список, далеко не лучшая практика. Для подобных целей в Python существует специальная функция range(), которая генерирует арифметическую последовательность чисел с параметрами:

range(start, stop, step)

Например, для генерации последовательности от 0 до 4, функцию range() можно записать в виде:

range(5)
range(0, 5)
range(0,5,1)

То есть, последнее значение 5 не включается в диапазон. Чтобы увидеть сгенерированные числа, преобразуем их последовательность в список с помощью известной нам функции list():

list(range(5))
list(range(0, 5))
list(range(0, 5, 1))

Если же мы запишем:

list(range(0))

то получим пустой список, так как значения здесь начинаются с нуля и заканчиваются нулем, при этом, ноль в интервал не входит.

То же самое произойдет при указании любого отрицательного значения, например:

list(range(-5))
list(range(0, -5))

Но как нам тогда формировать последовательность отрицательных значений? Очень просто, в качестве стартового значения нужно указать число меньше конечного значения:

list(range(-10, -5))

Или с шагом:

list(range(-10, -5, 2))

Но если указать отрицательный шаг:

list(range(-10, -5, -2))

то снова увидим пустой список. Я, думаю, вы догадались почему? Теперь, мы начинаем двигаться от -10 в меньшую сторону и значение -5 становится недостижимым. В этом случае функция range() не выдает никаких значений. Чтобы поправить ситуацию, в качестве конечного значения нужно записать число меньше -10, например, -20:

list(range(-10, -20, -2))

Вот так генерируются последовательности в обратном порядке. То же самое можно проделать и в положительной области:

list(range(5, 0, -1))

Обратите внимание, мы начинаем с 5 и заканчиваем 1. Здесь конечное значение 0 не включается в диапазон. Если нам нужно дойти до нуля, то в данном случае следует указать -1 в качестве конечного значения:

list(range(5, -1, -1))

Вот это всегда следует помнить при работе с функцией range() – конечное значение не включается в диапазон.

Итак, теперь, когда мы с вами узнали, как работает функция range(), перепишем нашу программу с перебором элементов списка по их индексам, следующим образом:

d = [5, 2, 4, 3, 1]
 
for i in range(5):
    d[i] = 0
 
print(d)

Здесь нам не нужно функцию range() превращать в список, оператор цикла for умеет перебирать любые итерируемые объекты, а range(), как раз возвращает такой объект, поэтому переменная i будет принимать значения от 0 до 4 включительно и мы видим, что все значения списка стали равны нулю.

И последний штрих в этой программе. Число 5 лучше заменить вызовом функции определения длины списка:

len(d)

Тогда получим универсальную программу, работающую со списком любой длины:

for i in range(len(d)):
    d[i] = 0

В заключение этого занятия приведу еще один пример использования цикла for для вычисления суммы ряда:

S = 1/2 + 1/3 + 1/4 + … + 1/1000

Программу можно реализовать, следующим образом:

S = 0
 
for i in range(2, 1001):
    S += 1 / i
 
print(S)

На этом мы завершим наше первое знакомство с оператором цикла for и функцией range(). На данный момент вам нужно хорошо понимать, как перебираются списки и строки, как формировать арифметические последовательности функцией range() и как ее можно использовать совместно с оператором цикла for. Следующий урок я целиком посвящу примерам использования этого оператора цикла со списками и строками, а пока закрепите текущий материал практическими заданиями.

Урок 23 · Часть I. Основы Python

Примеры работы оператора цикла for. Функция enumerate()

Источник: python3-primery-raboty-operatora-cikla-for-funkciya-enumerate

Мы продолжаем знакомиться с оператором цикла for языка Python. Сегодня мы с вами рассмотрим несколько примеров использования цикла for при решении разных задач. И первая задача – вычислить факториал от натурального числа n. Пусть пользователь вводит натуральное целое число, а мы будем выдавать значение его факториала:

n = int(input("Введите натуральное число не более 100: "))
 
if n < 1 or n > 100:
    print("Неверно введено натуральное число")
else:
    p = 1
    for i in range(1, n+1):
        p *= i
 
    print(f"Факториал {n}! = {p}")

Обратите внимание на запись функции range(). Чтобы она выдавала последовательность целых чисел от 1 до n включительно, необходимо записать n+1, так как последнее значение не включается в диапазон.

Следующий пример – отображение символов * в виде елочки. Сделать это можно очень просто:

for i in range(1, 7):
    print('*' * i)

Иллюстрация к уроку

Здесь счетчик i будет принимать значения 1, 2, 3, 4, 5 и 6. Соответственно, функция print() будет дублировать символ * i раз. В итоге, в первой строке будет одна звездочка, во второй – две и так до шести звездочек. Видите, как просто можно реализовать такую программу, используя оператор цикла и оператор работы со строками. Именно поэтому, все, что мы проходим, нужно хорошо запоминать и применять по мере необходимости.

Давайте, теперь, соединим все слова списка в одно предложение. Предположим, что у нас имеется список со словами:

words = ["Python", "дай", "мне", "силы", "пройти", "этот", "курс", "до", "конца"]

Которые объединим через цикл for:

s = ''
for w in words:
    s += ' ' + w
 
print(s)

У нас здесь получается вначале строки пробел. Убрать его можно двумя способами. Либо вызвать метод строки:

s = s.lstrip()

Либо, сделать так, чтобы он и не появлялся:

s = ''
flFirst = True
for w in words:
    s += ('' if flFirst else ' ') + w
    flFirst = False

Но, вот этот второй вариант получается более корявым и медленным по скорости работы. Поэтому, лучше воспользоваться методом lstrip().

А вот внимательный ученик с упреком заявил бы, что все это можно сделать еще проще – с помощью уже знакомого нам метода join():

print(" ".join(words))

И будет абсолютно прав! Те из вас, кто думал также – просто красавчики! Так держать!

Следующая задача. В списке:

digs = [4, 3, 100, -53, -30, 1, 34, -8]

все двузначные числа заменить нулями. Используя те знания, что у нас сейчас есть, это можно сделать так:

for i in range(len(digs)):
    if 10 <= abs(digs[i]) <= 99:
        digs[i] = 0
 
print(digs)

Обратите внимание, что мы здесь в цикле перебираем индексы элементов списка, а не сами элементы. Благодаря этому, в цикле получаем возможность изменять значение i-го элемента.

Как видите, в этой задаче нам потребовалось в цикле знать и индекс элемента и его значение. Именно для таких случаев в Python существует специальная функция:

индекс, значение = enumerate(объект)

которая возвращает пару (индекс, значение). Используя эту функцию, можно переписать наш пример, следующим образом:

for i, d in enumerate(digs):
    if 10 <= abs(d) <= 99:
        digs[i] = 0

Для меня такой вариант выглядит более читабельным и удобным. Во всем остальном эта программа подобна предыдущему варианту.

Последний пример, который я приведу на этом занятии – преобразование кириллицы в латиницу. Такая задача иногда возникает при создании сайтов. Вначале определим список замен для соответствующих русских букв (по алфавиту от а до я):

t = ['a', 'b', 'v', 'g', 'd', 'e', 'zh',
     'z', 'i', 'y', 'k', 'l', 'm', 'n', 'o', 'p',
     'r', 's', 't', 'u', 'f', 'h', 'c', 'ch', 'sh',
     'shch', '', 'y', '', 'e', 'yu', 'ya'
]

Затем, определим кодовое значение для первой буквы этого списка:

start_index = ord('а')

Далее, зададим строку и переменную slug, где будем формировать строку на латинице:

title = "Программирование на Python - лучший курс"
slug = ''

Затем, само преобразование в цикле, перебирая каждый символ исходной строки (причем, предварительно, строку мы переводим в нижний регистр – все буквы становятся малыми):

for s in title.lower():
    if 'а' <= s <= 'я':
        slug += t[ord(s) - start_index]
    elif s == 'ё':
        slug += 'yo'
    elif s in ' !?:,.':
        slug += '-'
    else:
        slug += s

После преобразования следует удалить все подряд идущие символы дефиса:

while slug.count('--'):
    slug = slug.replace('--', '-')
 
print(slug)

Конечно, это не самая оптимальная реализация данной задачи. Лучше ее делать с использованием, так называемых, регулярных выражений. Но, используя только наши текущие знания и как пример она очень хорошо вписывается в этот урок.

Если все примеры вам были понятны, то смело переходите к следующему уроку!

Урок 24 · Часть I. Основы Python

Итератор и итерируемые объекты. Функции iter() и next()

Источник: python3-iterator-i-iteriruemye-obekty-funkcii-iter-i-next

На этом занятии мы узнаем, что такое итерируемые объекты и познакомимся со способами их перебора. Мы уже знаем, что в Python существуют объекты, содержащие последовательность некоторых элементов. Например, строки и списки. Так вот, существует универсальный механизм для перебора элементов этих и других подобных им объектов. Реализуется он через специальную конструкцию под названием итератор. То есть, каждый итерируемый объект предоставляет доступ к своим элементам через итератор. С помощью этого итератора можно один раз пройтись по всем элементам коллекции от начала до конца.

Иллюстрация к уроку

Чтобы получить доступ к итератору объекта, например, списка, нужно вызвать специальную функцию iter() и первым аргументом указать итерируемый объект. Например, возьмем список:

d = [5, 3, 7, 10, 32]

и для него вызовем функцию iter():

iter(d)

Смотрите, нам был возвращен объект-итератор для списка. Сохраним его через переменную it:

it = iter(d)

Иллюстрация к уроку

Все, теперь у нас есть итератор для однократного перебора элементов списка d. Далее, чтобы перебрать значения итерируемого объекта, используется функция next(), которой следует передать объект-итератор:

next(it)

Она осуществляет переход к следующему элементу (при первом вызове переходим к первому элементу) и возвращает значение этого элемента. Видим значение 5. Вызовем эту функцию еще раз:

next(it)

Итератор был перемещен на следующий элемент и возвратилось значение 3. И так можно пройтись до конца нашего списка:

next(it)
next(it)
next(it)

Если для последнего элемента вызвать функцию еще раз:

next(it)

то получим ошибку StopIteration.

Когда итератор дошел до конца коллекции, его уже нельзя вернуть назад и пройти все элементы заново. Для этого придется создавать новый итератор с помощью функции iter():

it = iter(d)

и заново перебирать все элементы:

next(it)

Так работает этот механизм перебора элементов итерируемого объекта. Причем, он универсален и не зависит от типа объекта: это может быть и список и строка и любой другой перебираемый объект. Давайте я покажу, как это будет работать со строкой:

s = "python"

Также создаем итератор:

it_s = iter(s)

и перебираем символы функцией next():

next(it_s)
next(it_s)

Как видите, итератору все равно что перебирать, главное, чтобы сам объект поддерживал этот механизм, то есть, был итерируемым. Также следует иметь в виду, что доступ к элементам через итератор и по индексу:

s[2]

это совершенно разные способы обращения к элементам. К тому же не у всех итерируемых объектов есть возможность указания индексов.

Помимо строк и списков к итерируемым объектам также относится ранее рассмотренная функция:

r = range(5)

Для нее мы можем получить итератор:

it = iter(r)

и перебирать значения функцией next():

next(it)
next(it)

Когда я вам все это рассказываю, у вас, наверное, постоянно крутится вопрос: а зачем это надо? Мы и без всяких итераторов можем обращаться к элементам строк, списков и даже объекта range()? Да, все верно, если нам нужно извлечь какое-либо значение, скажем, из списка, то следует использовать индексы или срезы. То же самое и со строками. Но если нам в программе нужно перебирать итерируемые объекты самых разных типов, то единственный универсальный и безопасный способ это сделать – использовать итераторы. Например, так происходит в операторе цикла for. Мы можем ему указать перебрать любой итерируемый объект и он должен «уметь» это делать вне зависимости от типа этого объекта. Поэтому он обращается к итератору и перебирает элементы через этот универсальный механизм, пока не возникнет исключение StopIteration. Именно поэтому мы в цикле можем с легкостью перебирать и списки:

for x in [5, 3, 7, 10, 32]:
    print(x)

Иллюстрация к уроку

И строки:

for x in "python":
    print(x)

И объект range():

for x in range(1, 6):
    print(x)

И вообще любой другой тип объектов, которые поддерживают итератор, то есть, являются итерируемыми.

А что будет, если мы попробуем получить итератор для не итерированного объекта, например, числа:

iter(5)

В этом случае получим ошибку, что объект типа int не является итерируемым, то есть, не поддерживает итератор и перебор элементов. Действительно, число – это одно значение и перебирать тут нечего, поэтому оно относится к неитерируемым объектам. Соответственно, и в цикле for мы не можем указывать такие элементы:

for x in 5:
    print(x)

Перебрать одно число не получится. Здесь можно указывать только итерируемые объекты.

Надеюсь, из этого занятия вам стало понятно, что такое итератор и итерируемые объекты, как получать итератор с помощью функции iter() и как перебирать элементы функцией next(). Закрепите этот материал практическими заданиями, после чего жду всех вас на следующем уроке.

Урок 25 · Часть I. Основы Python

Вложенные циклы. Примеры задач с вложенными циклами

Источник: python3-vlozhennye-cikly-primery-zadach-s-vlozhennymi-ciklami

На предыдущих занятиях мы с вами в деталях познакомились с работой операторов циклов for и while. На этом занятии сделаем следующий важный шаг и узнаем, как реализуются и работают вложенные циклы.

Само это название уже говорит, что один оператор цикла можно вложить в другой. Это могут быть два цикла for или два цикла while или смешанные варианты. Давайте вначале разберемся, как работают эти конструкции. Принцип у всех един, поэтому, для простоты, я возьму два цикла for (один вложен в другой). Эти циклы будут просто пробегать диапазоны чисел, первый от 1 до 3, а второй – от 1 до 5:

for i in range(1, 4):
    for j in range(1, 6):
        print(f"i = {i}, j = {j}", end=' ')
    print()

Иллюстрация к уроку

Во втором вложенном цикле мы будем выводить значения i и j в строку без перехода на новую строчку. А после завершения работы вложенного цикла вызовем функцию print(), как раз, для перевода курсора на новую строку. В результате выполнения этой программы, мы получим таблицу значений переменных i и j.

Почему получились именно такие значения? Вначале у нас счетчик i принимает значение 1, а счетчик j пробегает числа от 1 до 5, в итоге получаем первую строку. После завершения вложенного цикла, срабатывает функция print() и курсор переходит на новую строку. После этого переходим ко второй итерации первого цикла и i = 2. Счетчик j снова проходит значения от 1 до 5 и получаем вторую строку. На следующей итерации первого цикла i = 3, j проходит от 1 до 5 и получаем третью строку. То есть, у нас вложенный цикл for трижды запускался заново и каждый раз j изменялось от 1 до 5. Это и есть принцип работы вложенного цикла – на каждой итерации он отрабатывает снова и снова, пока не завершится первый цикл.

Теперь второй вопрос – зачем все это нужно? Давайте представим, что у нас есть вложенный (двумерный) список:

a = [[1, 2, 3, 4], [2, 3, 4, 5], [3, 4, 5, 6]]

(О таких списках мы с вами уже говорили и вам здесь все должно быть понятно). Так вот, если мы будем перебирать его элементы с помощью одного оператора цикла for:

for row in a:
    print(row, type(row))

То переменная row будет ссылаться сначала на первый вложенный список, затем, на второй и потом на третий. Но, так как row ссылается на список, то есть, на итерируемый объект, то нам ничто не мешает перебрать его элементы с помощью второго, вложенного цикла for:

for row in a:
    for x in row:
        print(x, type(x), end=' ')
    print()

Как видите, теперь в консоль выводятся числа типа int, то есть, мы обращаемся непосредственно к элементам этого двумерного списка.

Ну, хорошо, а все-таки, зачем это может быть нужно? Например, так можно выполнить сложение значений из двух одинаковых двумерных списков:

a = [[1, 2, 3, 4], [2, 3, 4, 5], [3, 4, 5, 6]]
b = [[1, 1, 1, 1], [2, 2, 2, 2], [3, 3, 3, 3]]

И сформировать на их основе третий список:

c = []

следующим образом:

for i, row in enumerate(a):
    r = []
    for j, x in enumerate(row):
        r.append(x + b[i][j])
 
    c.append(r)
 
print(c)

Иллюстрация к уроку

Я здесь воспользовался еще одной уже знакомой нам функцией enumerate(), которая возвращает индекс и значение текущего элемента. Это удобно для реализации данной программы. Внутри первого цикла мы каждый раз создаем новый пустой список и с помощью метода append() добавляем в его конец новый элемент как сумму значений из списков a и b. Полученную строку (список r) мы, затем, добавляем в основной список c. Так вычисляется сумма значений элементов двух одинаковых списков a и b.

Как видите, для реализации данной программы нам потребовался вложенный оператор цикла for. И это лишь один маленький пример. Другой пример, пусть у нас имеется текст, представленный в виде списка:

t = ["– Скажи-ка,  дядя, ведь не даром",
    "Я Python выучил с   каналом",
    "Балакирев что    раздавал?",
    "Ведь были  ж заданья боевые,",
    "Да, говорят,  еще какие!",
    "Недаром помнит    вся Россия",
    "Как мы рубили   их тогда!"
]

Здесь в строках присутствуют два и более пробелов. Наша задача удалить их и оставить только один. Сделаем это с помощью вложенных циклов. В первом цикле for будем перебирать строки – элементы списка, а во втором (вложенном) цикле while удалять лишние пробелы:

for i, line in enumerate(t):
    while line.count('  '):
        line = line.replace('  ', ' ')
 
    t[i] = line
 
print(t)

В качестве условия цикла мы здесь вызываем метод count(), который подсчитывает число фрагментов из двух пробелов подряд. Как только их станет 0 – это будет означать False и цикл завершится. Преобразованная строка становится новым i-м элементом списка и в конце результат выводим в консоль.

Следующий пример. Предположим, вначале мы формируем вложенный список размером M x N элементов. Причем, M, N вводим с клавиатуры. Вначале сформируем список, состоящий из всех нулей:

M, N = list(map(int, input("Введите M и N: ").split()))
 
zeros = []
for i in range(M):
    zeros.append([0]*N)
 
print(zeros)

А после этого все элементы заменим на единицы, используя вложенные циклы:

for i in range(M):
    for j in range(N):
        zeros[i][j] = 1

Как видите, в целом, все достаточно просто.

И последний пример. Пусть у нас имеется квадратный список (размерности совпадают):

A = [[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12], [13, 14, 15, 16]]

Необходимо поменять строки на столбцы и получить новое представление этого же списка. Для этого достаточно поменять местами элементы, стоящие выше главной диагонали с элементами, стоящими ниже главной диагонали. То есть, у нас счетчик i будет меняться от 0 до 3, а счетчик j от i+1 до 3. Затем, соответствующие элементы будем менять между собой:

for i in range(len(A)):
    for j in range(i+1, len(A)):
        A[i][j], A[j][i] = A[j][i], A[i][j]
 
for r in A:
    for x in r:
        print(x, end='\t')
    print()

Иллюстрация к уроку

Как видите, у нас получилось нужно преобразование. В математике это называется транспонированием матрицы.

Конечно, уровень вложенности операторов циклов может быть еще больше и два и три и четыре. Однако, на практике слишком большого вложения следует избегать, так как программа становится менее читаемой и гибкой для дальнейшего изменения. Лучше ограничиваться тремя подряд идущими во вложении операторами циклов, не более.

Для закрепления, как всегда, пройдите практические задания и, затем, переходите к следующему уроку.

Урок 26 · Часть I. Основы Python

Треугольник Паскаля как пример работы вложенных циклов

Источник: python3-treugolnik-paskalya-kak-primer-raboty-vlozhennyh-ciklov

На этом занятии мы с вами напишем программу для построения треугольника Паскаля. Этот треугольник состоит из особых чисел, которые вычисляются по правилу: по краям каждой строки стоят единицы, а каждое из остальных чисел равно сумме двух стоящих над ним из предыдущей строки. Именно в таком виде его привел французский математик Блез Паскаль в «Трактате об арифметическом треугольнике». Популярность этого треугольника возникла из-за того, что эти числа довольно часто встречаются в самых разных задачах математики: алгебре, комбинаторике, теории вероятностей и многих других. Мы сейчас не будем вдаваться в их анализ, так как перед нами стоит несколько другая задача – написать программу формирования такого треугольника.

Иллюстрация к уроку

Первый вопрос, на который, обычно, требуется ответить при разработке новой программы – как хранить данные? В данном случае, как хранить эти числа? Я это сделаю с помощью неравномерного вложенного списка. Смотрите, весь этот треугольник можно представить как набор вложенных списков постоянно увеличивающейся длины:

P = [ [1],
      [1, 1],
      [1, 2, 1],
      …
]

Далее, в программе мы запишем два вложенных цикла for со счетчиками: i – для перебора строк треугольника Паскаля; j – для перебора элементов формируемой строки. Причем, j будет меняться в диапазоне [0; i]. То есть, для первой строки принимает только одно значение 0, для второй – два значения [0; 1], для третьей – три [0; 1; 2] и так далее.

А формировать значения строк будем следующим образом. Для каждой новой (i-й) строки мы создадим список длиной i+1, состоящий из всех единиц:

row = [1] * (i+1)

Затем, все крайние элементы с индексами:

j == 0 or j == i

мы трогать не будем, так как там уже стоят нужные нам единицы. А все другие значения формировать на основе суммы двух предыдущих:

row[j] = P[i-1][j-1] + P[i-1][j]

В итоге, всю программу можно записать, так:

N = 7
P = []
 
for i in range(0, N):
    row = [1] * (i + 1)
    for j in range(i + 1):
        if j != 0 and j != i:
            row[j] = P[i-1][j-1] + P[i-1][j]
 
    P.append(row)
 
for r in P:
    print(r)

Мы вначале определяем общее число строк, затем коллекцию P, которая будет хранить значения треугольника Паскаля и, далее, вложенные циклы. Первый цикл со счетчиком i перебирает строки, а второй – со счетчиком j перебирает элементы текущей строки row. Внутри вложенного цикла проверяем, если индекс j ссылается не на крайние элементы строки, то формируем их значения на основе суммы двух чисел из предыдущей строки. После этого добавляем строку в список P и проделываем эту операцию N раз. В конце программы выводим результат и давайте посмотрим, что у нас получится.

Как видите, у нас сформировался треугольник Паскаля, состоящий из семи строк. Вот так, с помощью вложенных циклов можно решить эту, относительно несложную задачку.

Опять же, все программы, что я привожу на учебном курсе не являются истиной в последней инстанции. У вас могут получаться другие программные реализации той же самой задачи. Здесь главное помнить, что лучшая реализация будет та, которая расходует меньше памяти и работает быстрее. Это два самых главных критерия построения любых программ. Ну и, разумеется, программы должны приводить к корректным результатам, иначе их можно считать неработоспособными.

Надеюсь, из этого занятия вы хорошо себе представили, как можно запрограммировать задачу формирования треугольника Паскаля с произвольным числом строк. Если здесь никаких вопросов не возникает, то смело переходите к следующему уроку.

Практика 5 · Часть I. Основы Python

Циклы

Задания для закрепления темы · решений нет

Цели обучения

  • Эффективно использовать while и for / range
  • Управлять потоком через break, continue и else цикла
  • Применять enumerate и вложенные циклы для сеток и комбинаторных шаблонов

Задания

Задание 1. Сумма до сторожевого значения

Сложность: лёгкое

Реализуйте sum_until_zero(values: list[int]) -> int: суммируйте элементы с начала, пока не встретите 0 (не включая). Если нуля нет — сумму всего списка.

Требования:

  • Предпочтительно for с break или while
  • Пустой список → 0

Пример:

sum_until_zero([1, 2, 0, 99])  # 3
sum_until_zero([4, 5])         # 9

Задание 2. Индексы «fizz»

Сложность: лёгкое

Реализуйте fizz_indices(n: int) -> list[int]: индексы i в 0..n-1, где (i+1) делится на 3. Используйте for + range и continue либо условие-фильтр.

Требования:

  • Верните список индексов (с нуля)
  • Если n <= 0, верните []

Пример:

fizz_indices(6)  # [2, 5]  # числа 3 и 6

Задание 3. Первый повтор с enumerate

Сложность: среднее

Реализуйте first_duplicate(items: list) -> tuple | None: верните (index, value) первого элемента, который уже встречался ранее; иначе None.

Требования:

  • Используйте enumerate
  • Отслеживайте уже виденные значения в list или set

Пример:

first_duplicate(["a", "b", "a"])  # (2, "a")
first_duplicate([1, 2, 3])        # None

Задание 4. Шаги Коллатца

Сложность: среднее

Реализуйте collatz_steps(n: int) -> int: число шагов до 1 по правилам Коллатца (n чётное → n/2, нечётное → 3n+1). Используйте while. Если n < 1, выбросьте ValueError. Для n == 1 верните 0.

Требования:

  • Целочисленное деление через //
  • Цикл, пока n == 1 не достигнуто

Пример:

collatz_steps(6)  # 8  # 6→3→10→5→16→8→4→2→1

Задание 5. Фрагмент таблицы умножения

Сложность: среднее

Реализуйте mul_table(n: int) -> list[list[int]]: таблица n×n, где ячейка [i][j] = (i+1)*(j+1).

Требования:

  • Вложенные циклы for
  • Если n <= 0, верните []

Пример:

mul_table(3)
# [[1, 2, 3],
#  [2, 4, 6],
#  [3, 6, 9]]

Задание 6. Строка треугольника Паскаля

Сложность: сложное

Реализуйте pascal_row(k: int) -> list[int]: k-я строка треугольника Паскаля с нуля (например, строка 0 → [1], строка 3 → [1, 3, 3, 1]).

Требования:

  • Строите через вложенные циклы (или итеративно от предыдущей строки)
  • Если k < 0, выбросьте ValueError

Пример:

pascal_row(4)  # [1, 4, 6, 4, 1]

Подсказки:

  • Каждый элемент — сумма двух «родителей» из предыдущей строки

Задание 7. Флаги решета простых

Сложность: сложное

Реализуйте primes_up_to(n: int) -> list[int]: все простые <= n через решето с вложенными циклами или пробное деление. Если n < 2, верните [].

Требования:

  • Без импортов сторонних библиотек
  • Порядок по возрастанию

Пример:

primes_up_to(20)  # [2, 3, 5, 7, 11, 13, 17, 19]

Глава 6

Генераторы коллекций

Урок 27 · Часть I. Основы Python

Генераторы списков (List comprehensions)

Источник: python3-generatory-spiskov-list-comprehensions

Мы продолжаем курс по языку программирования Python. На этом занятии мы с вами познакомимся с еще одной довольно полезной и популярной конструкцией – генератором списков. По-английски это записывается как:

List comprehension

Для лучшего понимания, давайте я начну сразу с конкретного примера. Предположим, мы хотели бы сформировать список из квадратов целых чисел от 0 до N. Используя наши текущие знания, очевидно, это можно было бы сделать, следующим образом:

N = 6
a = [0] * N
 
for i in range(N):
    a[i] = i ** 2
 
print(a)

Но это не лучший вариант. Все то же самое можно реализовать буквально в одну строчку:

a = [x ** 2 for x in range(N)]

И, кроме того, этот вариант будет работать быстрее предыдущей программы, т.к. Python оптимизирует работу таких конструкций.

Давайте теперь разберемся в этом синтаксисе. Вначале мы указываем, что будем делать с переменной x. Казалось бы, переменная нигде не задана, а мы уже говорим что с ней делать. Да, это так, это такой элемент синтаксиса list comprehensions. Далее, через пробел мы записываем цикл for и уже там указываем эту переменную x и говорим как она будет меняться. То есть, эта временная переменная x существует только внутри списка и пропадает после его создания.

Такой подход и называется генератором списков. Вначале указываем, как формируются значения списка, а затем, описываем изменение параметра x через ключевое слово for. Причем, здесь можно указывать только его. К примеру, ключевое слово while прописывать нельзя.

Итак, для генерации списков следует придерживаться следующего синтаксиса (определения):

[<способ формирования значения> for <переменная> in <итерируемый объект>]

В самом простом варианте мы можем сформировать список и так:

a = [1 for x in range(N)]

Хотя, в таких случаях, когда все значения одинаковы, обычно, используют оператор *:

b = [1] * N

Но, в отличие от простого дублирования с помощью List comprehension можно формировать более сложные последовательности, например, состоящих из остатков от деления на 4:

a = [x % 4 for x in range(N)]

То есть, мы можем использовать любые доступные нам операторы для формирования текущего значения. Если, например, взять оператор определения четного и нечетного значений:

a = [x % 2 == 0 for x in range(N)]

то получим список из булевых величин True и False. Или же сформировать значения линейной функции:

a = [0.5*x+1 for x in range(N)]

И так далее. Кроме того, мы здесь можем вызывать и функции. Пусть в программе пользователь вводит несколько целых чисел через пробел:

d_inp = input("Целые числа через пробел: ")

Тогда с помощью генератора списков мы легко можем преобразовать их в набор чисел:

a = [int(d) for d in d_inp.split()]

Здесь конструкция d_inp.split() возвращает список строк из чисел, а функция int(d) преобразовывает каждую строку в целое число. Если убрать функцию int() и записать просто d:

a = [d for d in d_inp.split()]

то у нас получится уже список из строк, то есть, функция int() действительно делает нужное нам преобразование.

Работа этой реализации очень похожа на функцию map(), которую мы с вами использовали в подобных задачах:

d_inp = list(map(int, input("Целые числа через пробел: ").split()))

(О функции map() подробнее мы еще будем говорить).

Вообще, в генераторе списков можно использовать любые итерируемые объекты, в том числе и строки. Например, вполне допустима такая реализация:

a = [d for d in "python"]

получим список из отдельных символов. Или, можно каждый символ превратить в его код:

a = [ord(d) for d in "python"]

Имеем список из соответствующих кодов. Если же взять список из слов:

t = ["Я", "б", "Python", "выучил", "только", "за", "то", "что", "есть", "он", "на", "этом", "канале"]

то генератор списка:

a = [d for d in t]

сформирует точно такой же список. То есть, строки здесь воспринимаются уже как отдельные элементы и d ссылается на каждую из них по порядку. Я добавлю функцию len() для определения длины строк:

a = [len(d) for d in t]

и теперь мы имеем список из длин.

Условия в генераторах списков

В генераторах дополнительно можно прописывать условия. Например, выберем все числа меньше нуля:

a = [x for x in range(-5, 5) if x < 0]

Мы здесь после оператора for записали необязательный оператор if. В результате, в список будут попадать только отрицательные значения x. Или, можно сделать проверку на нечетность:

a = [x for x in range(-5, 5) if x % 2 != 0]

Получаем только нечетные числа из диапазона [-5; 5). Также можно прописывать составные условия, например:

a = [x for x in range(-6, 7) if x % 2 == 0 and x % 3 == 0]

Выберем все числа, которые кратны 2 и 3 одновременно. Или, такой пример, выберем из списка городов только те, длина которых меньше семи:

cities = ["Москва", "Тверь", "Рязань", "Ярославль", "Владимир"]
a = [city for city in cities if len(city) < 7]

Видите, как легко и просто можно реализовать такую задачу с помощью List comprehension.

Ну и последнее, что я хочу отметить на этом занятии – это возможность использования тернарного условного оператора внутри генераторов списков. Так как первым элементом мы можем прописывать любые конструкции языка Python, то кто нам мешает сделать следующее. Пусть имеется список чисел:

d = [4, 3, -5, 0, 2, 11, 122, -8, 9]

и мы хотим преобразовать его в последовательность со словами «четное» и «нечетное». Сделать это можно как раз с помощью тернарного условного оператора:

a = ["четное" if x % 2 == 0 else "нечетное" for x in d]

Обратите еще раз внимание, что этот оператор не является какой-то особой частью синтаксиса генератора списка. Мы здесь всего лишь используем его как обычный оператор языка Python. Это такой же оператор как сложение, умножение и другие:

a = [x + 2 for x in d]

которые мы также можем использовать при формировании списков.

Полученная запись генератора списка с тернарным оператором получилась не очень читаемой. Это можно исправить, если записать все в отдельных строчках:

a = ["четное" if x % 2 == 0 else "нечетное"
     for x in d
     if x > 0
]

Кстати, здесь можно добавить еще и условие.

На этом мы завершим первое знакомство с генераторами списков. Для закрепления материала обязательно пройдите практические задания, после чего переходите к следующему уроку, где мы продолжим знакомиться с этой темой.

Урок 28 · Часть I. Основы Python

Вложенные генераторы списков

Источник: python3-vlozhennye-generatory-spiskov

Мы продолжаем тему генераторов списков языка Python. На прошлом занятии мы увидели, как можно формировать списки, используя конструкции:

[<способ формирования значения> for <счетчик> in <итерируемый объект>]

и

[<способ формирования значения>
for <счетчик> in <итерируемый объект>
if <условие>
]

Но, в действительности, Python позволяет записывать любое число циклов for в генераторах списков. Здесь операторы if после циклов являются необязательными (мы их можем прописывать, а можем и пропускать).

Как всегда, работу таких вложенных циклов лучше всего увидеть на примере. В самом простом варианте, мы сформируем просто пары чисел в списке, следующим образом:

a = [(i, j) for i in range(3) for j in range(4)]
print(a)

Для большей наглядности запишем генератор списка в несколько строк:

a = [(i, j)
     for i in range(3)
     for j in range(4)
]

Вот отсюда уже гораздо лучше видно, что второй цикл вложен в первый. То есть, сначала при i = 0 отрабатывает внутренний цикл по j от 0 до 3. Затем, переходим к первому циклу, i увеличивается на 1 и внутренний цикл повторяется. В результате, получаем пары чисел:

[(0, 0), (0, 1), (0, 2), (0, 3), (1, 0), (1, 1), (1, 2), (1, 3), (2, 0), (2, 1), (2, 2), (2, 3)]

То есть, здесь у нас происходит работа двух вложенных циклов. Дополнительно, мы можем указывать условия для каждого из них, например, так:

a = [(i, j)
     for i in range(3) if i % 3 == 0
     for j in range(4)
]

Или, у обоих вместе:

a = [(i, j)
     for i in range(3) if i % 3 == 0
     for j in range(4) if j % 2 != 0
]

Используя этот подход, мы можем, например, сформировать таблицу умножения:

a = [f"{i}*{j} = {i*j}"
     for i in range(1, 4)
     for j in range(1, 4)
]

Или, двумерный список превратить в одномерный:

matrix = [[0, 1, 2, 3],
          [10, 11, 12, 13],
          [20, 21, 22, 23]]
 
a = [x
     for row in matrix
     for x in row
]

Обратите внимание, мы во втором цикле используем переменную row из первого цикла. Это вполне допустимая операция, т.к. второй цикл вложен в первый и в нем доступны все переменные, объявленные ранее.

Вложенные генераторы списков

Давайте еще раз посмотрим на исходное определение генератора списка:

[<оператор> for <счетчик> in <итерируемый объект>]

Как я уже отмечал, в качестве оператора можно записывать любую конструкцию языка Python. А раз так, то кто нам мешает прописать здесь еще один генератор:

[[генератор списка]
for <переменная> in <итерируемый объект>
]

В результате, получим вложенный генератор списка. Давайте посмотрим на примере, как это будет работать:

M, N = 3, 4
matrix = [[a for a in range(M)] for b in range(N)]
 
print(matrix)

Получаем двумерный список, вида:

[[0, 1, 2], [0, 1, 2], [0, 1, 2], [0, 1, 2]]

Результат вполне очевиден. Смотрите, сначала отрабатывает первый (внешний) генератор списка и переменная b = 0. Затем, выполнение переходит к вложенному генератору, который выдает список [0, 1, 2]. Этот список помещается как первый элемент основного списка. Далее, снова отрабатывает первый генератор и b принимает значение 1. После этого переходим к вложенному генератору, который возвращает такой же список [0, 1, 2]. И так пока не закончится работа первого генератора. В итоге, видим список, в который вложены четыре других списка.

Где может пригодиться такой подход? Например, для изменения значений двумерного списка. Давайте предположим, что у нас есть вот такой список:

A = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]

И мы хотим возвести все его значения в квадрат. Лучше всего это сделать именно через генератор, следующим образом:

A = [[x ** 2 for x in row] for row in A]

В первом генераторе происходит перебор строк (вложенных списков) матрицы A, а во вложенном генераторе – обход элементов строк матрицы. Каждое значение возводится в квадрат и на основе этого формируется текущая строка. Обратите внимание, что во вложении мы можем использовать переменные из внешнего генератора списка, в частности, переменную row, ссылающуюся на текущую строку матрицы A.

Другой пример – это транспонирование матрицы A (то есть, замена строк на столбцы) с использованием вложенных генераторов. Сделать это можно, следующим образом:

A = [[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]]
A = [[row[i] for row in A] for i in range(len(A[0]))]

Поясню работу этой конструкции. Сначала значение i = 0, а переменная row[i] пробегает первые значения строк матрицы A. В результате формируется первая строка транспонированной матрицы. Далее, i увеличивается на 1 и row[i] пробегает уже вторые элементы строк матрицы A. Получаем вторую строку транспонированной матрицы. И так делаем для всех столбцов. На выходе формируется транспонированная матрица.

С таким типом вложений, я думаю, в целом все должно быть понятно. Другой вариант, когда мы список помещаем в качестве итерируемого объекта. Да, сам по себе генератор списка поддерживает механизм итерирования – перебора элементов через итератор, поэтому может быть использован в операторе for, например, так:

g = [u ** 2 for u in [x+1 for x in range(5)]]

Здесь сначала отрабатывает вложенный генератор списка, получаем список [1, 2, 3, 4, 5], а затем, эти значения перебираются первым генератором и возводятся в квадрат, получаем результат:

[1, 4, 9, 16, 25]

Это очень похоже на вычисление значений сложной (вложенной) функции:

g(u(x+1)) = (x+1) ^ 2

Вот такие варианты вложений генераторов списков, а также их комбинации, можно использовать в Python. Для закрепления этого материала пройдите практические задания и жду всех вас на следующем уроке.

Урок 34 · Часть I. Основы Python

Генераторы множеств и генераторы словарей

Источник: python3-generatory-mnozhestv-i-generatory-slovarey

На этом занятии мы с вами поговорим о генераторах множеств и словарей. Ранее, я вам уже рассказывал о генераторах списков, когда мы их создавали, используя синтаксис:

[<способ формирования значения> for <счетчик> in <итерируемый объект>]

Например:

a = [x ** 2 for x in range(1, 5)]
print(a)

Далее, я буду полагать, что вы помните и знаете этот материал. Так вот, те же самые конструкции можно определять и для множеств со словарями. Для этого достаточно вместо квадратных скобок прописать фигурные:

a = {x ** 2 for x in range(1, 5)}

и вместо списка получим уже множество. Почему было сформировано именно множество, а не словарь? Как мы помним, множество представляет собой набор отдельных значений, а в словаре дополнительно еще прописываются ключи. Здесь же, при генерации мы получаем серию значений, поэтому, такая коллекция в Python воспринимается именно как множество.

А вот если мы будем генерировать последовательность с ключами, например, так:

a = {x: x ** 2 for x in range(1, 5)}

то получим уже словарь.

Где такие генераторы могут использоваться? Давайте представим, что нам нужно выделить уникальные значения из списка:

d = [1, 2, '1', '2', -4, 3, 4]

Причем, все элементы следует привести к целым числам перед записью в множество. Для решения этой задачи удобно воспользоваться генератором множества:

a = {int(x) for x in d}

Видите, как легко и просто, в одну строчку мы это сделали. Мало того, генераторы работают быстрее циклов. Поэтому реализация задачи в виде:

set_d = set()
for x in d:
    set_d.add(int(x))
print(set_d)

будет и более громоздкой и более медленной. Поэтому там, где это возможно, лучше использовать соответствующие генераторы.

То же самое и со словарем. Допустим, нам нужно все его ключи записать заглавными буквами, а значения представить целыми числами:

m = {"неудовл.": 2, "удовл.": 3, "хорошо": '4', "отлично": '5'}

Опять же используем генератор:

a = {key.upper(): int(value) for key, value in m.items()}

и на выходе получаем искомый словарь. Видите, как элегантно это можно сделать с использованием генераторов.

Также как и со списками, в генераторах множеств и словарей можно использовать условия. Например, мы хотим в множество добавить только положительные числа из списка:

d = [1, 2, '1', '2', -4, 3, 4]

Также предварительно их преобразовываем в числа и делаем проверку:

a = {int(x) for x in d if int(x) > 0}

Или, со словарем. Поменяем в нем местами ключи и значения и поместим в него только отмети от 2 до 5:

m = {"безнадежно": 0, "убого": 1, "неудовл.": 2, "удовл.": 3, "хорошо": '4', "отлично": '5'}
a = {int(value): key for key, value in m.items() if int(value) >= 2 and int(value) <= 5}

Вот так просто и легко можно использовать генераторы множеств и словарей в своих программах. Основное их преимущество перед обычными циклами – более высокая скорость работы и наглядность текста программы. Поэтому, если циклы можно относительно легко заменить генераторами, то стоит это делать. Также в генераторах множеств и словарей можно применять и вложенные схемы, когда один генератор вложен в другой. Причем, можно комбинировать генераторы списков с генераторами множеств и словарей. Делается это все по аналогии с вложенными генераторами списков, о которых мы с вами уже говорили.

Практика 6 · Часть I. Основы Python

Генераторы коллекций (comprehensions)

Задания для закрепления темы · решений нет

Цели обучения

  • Заменять простые циклы на list comprehensions
  • Вкладывать comprehensions для матриц и разворачивания
  • Строить set и dict через comprehensions

Задания

Задание 1. Квадраты нечётных

Сложность: лёгкое

Реализуйте squares_of_odds(n: int) -> list[int]: квадраты нечётных чисел в 1..n включительно через list comprehension.

Требования:

  • Один comprehension (без императивного цикла с append)
  • Если n < 1, верните []

Пример:

squares_of_odds(5)  # [1, 9, 25]

Задание 2. Длины слов

Сложность: лёгкое

Реализуйте word_lengths(text: str) -> dict[str, int]: отобразите каждое слово (разделённое пробелами) в его длину через dict comprehension. При дубликатах побеждает последнее вхождение (обычно для dict).

Требования:

  • Dict comprehension по text.split()
  • Пустой текст → {}

Пример:

word_lengths("to be or not to be")
# {"to": 2, "be": 2, "or": 2, "not": 3}

Задание 3. Уникальные гласные

Сложность: среднее

Реализуйте unique_vowels(s: str) -> set[str]: множество строчных гласных из s (a e i o u) через set comprehension. Регистр игнорируйте.

Требования:

  • Set comprehension
  • Небуквенные символы игнорируются

Пример:

unique_vowels("Education")  # {"e", "u", "a", "i", "o"}

Задание 4. Разворачивание матрицы

Сложность: среднее

Реализуйте flatten_matrix(matrix: list[list]) -> list через вложенный list comprehension (двойной for).

Требования:

  • Одно выражение / comprehension
  • Пустая матрица или пустые строки обрабатываются

Пример:

flatten_matrix([[1, 2], [3], [4, 5]])  # [1, 2, 3, 4, 5]

Задание 5. Единичная матрица

Сложность: среднее

Реализуйте identity(n: int) -> list[list[int]] через вложенный list comprehension: 1 на диагонали, 0 в остальных ячейках. Если n <= 0, верните [].

Требования:

  • Вложенный comprehension с тернарным оператором для значения ячейки

Пример:

identity(3)
# [[1, 0, 0],
#  [0, 1, 0],
#  [0, 0, 1]]

Задание 6. Карта индексов первого вхождения

Сложность: сложное

Реализуйте first_index_map(items: list) -> dict: для каждого уникального значения — индекс его первого вхождения. Предпочтительно dict comprehension с хелпером или comprehension по отфильтрованной последовательности — по возможности избегайте обычного for с мутацией.

Требования:

  • Ключи результата — уникальные значения; значения — индексы
  • Порядок ключей для тестов не важен

Пример:

first_index_map(["a", "b", "a", "c"])
# {"a": 0, "b": 1, "c": 3}

Подсказки:

  • items.index(x) внутри comprehension по set(items) работает, но O(n²); здесь допустимо

Глава 7

Словари, кортежи и множества

Урок 29 · Часть I. Основы Python

Введение в словари (dict). Базовые операции над словарями

Источник: python3-vvedenie-v-slovari-dict-bazovye-operacii-nad-slovaryami

Мы продолжаем курс по языку Python. На этом занятии мы с вами познакомимся с новой коллекцией данных – словарем. Давайте представим, что мы в программе хотели бы описать, следующие зависимости:

house -
дом
car -
машина
tree -
дерево
road -
дорога
river -
река

Если определить значения через список:

d = ["дом", "машина", "дерево", "дорога", "река"]

Иллюстрация к уроку

то мы получим коллекцию, где каждое значение (русское слово) будет связано с числом – индексом. И изменить эти индексы невозможно – они создаются автоматически самим списком. А нам бы хотелось обращаться к этим значениям по английским словам. Как раз это позволяет делать словарь. Он формирует коллекцию в виде ассоциативного массива с доступом к элементу по ключу.

Для создания словаря используется следующий синтаксис:

{key1: value1, key2: value2, …, keyN:valueN}

и он определяет неупорядоченную коллекцию данных, то есть, данные в словаре не имеют строгого порядка следования. Располагаться они могут произвольным образом, но всегда связаны с одним, строго определенным ключом.

В нашем конкретном случае словарь можно определить, так:

d = {"house": "дом", "car": "машина",
     "tree": "дерево", "road": "дорога",
     "river": "река"}

Иллюстрация к уроку

Как видите, мы можем записывать значения в несколько строчек, не обязательно все писать в одну.

После создания словаря, мы можем по ключу получать нужное нам значение. Для этого записываются квадратные скобки и в них указывается ключ:

d["house"]

возвращается значение «дом», которое связано с этим ключом. Если же указать не существующий ключ:

d[100]

то получим ошибку. Разумеется, ключи в словарях всегда уникальны. Если записать два одинаковых:

d = {"house": "дом", "house": "дом 2", "car": "машина"}

то ключ «house» будет ассоциирован с последним значением – «дом 2».

Также для определения словаря в Python существует специальная встроенная функция dict(). Ей, в качестве аргументов, через запятую перечисляются пары в формате ключ=значение:

d2 = dict(one = 1, two = 2, three = "3", four = "4")

Здесь ключи преобразовываются в строки и должны определяться как и имена переменных. Например, использовать числа уже не получится:

d2 = dict(1 = "one", two = 2, three = "3", four = "4")

Это неверное имя переменной.

Один из плюсов этой функции – возможность создать словарь из списка специального вида. Что это за вид? Например, такой:

lst = [[2, "неудовлетворительно"], [3, "удовлетворительно"], [4, "хорошо"], [5, "отлично"]]

Здесь вложенные списки состоят из двух элементов, которые функцией dict() интерпретируются как ключ и значение. Если мы сформируем словарь:

d3 = dict(lst)

то, как раз, увидим такую структуру данных. Причем, в этом случае, в качестве ключей можно уже выбирать и другие типы данных, не только строки, например, числа.

Если вызвать эту функцию без параметров:

d = dict()

то получим пустой словарь. Это эквивалентно такой записи:

d = {}

и, чаще всего, она используется на практике, так как короче.

Давайте теперь ответим на вопрос: а что вообще можно использовать в качестве ключей? Какие типы данных? В наших примерах это было или число, или строка. Что можно брать еще? На самом деле любые неизменяемые типы. Обратите внимание – неизменяемые! Например, можно написать так:

d[True] = "Истина"
d[False] = "Ложь"

Здесь ключи – булевы значения. В результате, получим словарь:

{True: ‘Истина’, False: ‘Ложь’}

Также этот пример показывает, что присваивая словарю значение с новым ключом, оно автоматически добавляется в словарь. В результате, наш изначально пустой словарь стал содержать две записи. Если же мы существующему ключу присваиваем другое значение:

d[True] = 1

то он просто поменяет свое значение в словаре. Вот так можно добавлять и менять значения словаря. То есть, словарь относится к изменяемым типам.

А вот если ключом указать список:

d[[1,2]] = 1

то возникнет ошибка, т.к. список – это изменяемый объект. Вообще, чаще всего в качестве ключей используются строки или числа.

Это то, что касается ключей, а вот на значения словаря никаких ограничений не накладывается – там могут самые разные данные:

d = {True: 1, False: "Ложь", "list": [1,2,3], 5: 5}

Операторы и функции работы со словарем

В заключение этого занятия рассмотрим некоторые операторы и функции работы со словарем. С помощью функции:

len(d)

можно определить число элементов в словаре. Оператор:

del d[True]

выполняет удаление пары ключ=значение для указанного ключа. Если записать несуществующий ключ:

del d["abc"]

то оператор возвращает ошибку. Поэтому перед удалением лучше проверить существует ли данный ключ в словаре с помощью оператора in:

"abc" in d

Обратите внимание, оператор in проверяет именно наличие ключа, а не значения. Например, если добавить это значение:

d[1] = "abc"

и повторно выполнить команду:

"abc" in d

то увидим значение False.

Также можно делать противоположную проверку на отсутствие ключа, прописывая дополнительно оператор not:

"abc" not in d

Надеюсь, из этого занятия вы узнали, что такое словарь, как можно его задавать и обращаться к элементам этой коллекции по ключам. Познакомились с функцией dict() для создания словарей, функцией len() – для определения числа элементов и операторами in и del. Для закрепления этого материала подготовлены практические задания, после которых жду вас на следующем уроке.

Урок 30 · Часть I. Основы Python

Методы словаря, перебор элементов словаря в цикле

Источник: python3-metody-slovarya-perebor-elementov-slovarya-v-cikle

Мы продолжаем изучение словарей языка Python. Это занятие начнем с ознакомления основных методов, которые есть у этой коллекции. Начнем с метода

dict.fromkeys(список[, значение по умолчанию])

который формирует словарь с ключами, указанными в списке и некоторым значением. Например, передадим методу список с кодами стран:

a = dict.fromkeys(["+7", "+6", "+5", "+4"])

в результате, получим следующий словарь:

{‘+7’: None, ‘+6’: None, ‘+5’: None, ‘+4’: None}

Обратите внимание, все значения у ключей равны None. Это значение по умолчанию. Чтобы его изменить используется второй необязательный аргумент, например:

a = dict.fromkeys(["+7", "+6", "+5", "+4"], "код страны")

на выходе получаем словарь с этим новым указанным значением:

{‘+7’: ‘код страны’, ‘+6’: ‘код страны’, ‘+5’: ‘код страны’, ‘+4’: ‘код страны’}

Следующий метод

d.clear()

служит для очистки словаря, то есть, удаления всех его элементов.

Далее, для создания копии словаря используется метод copy:

d = {True: 1, False: "Ложь", "list": [1,2,3], 5: 5}
d2 = d.copy()
d2["list"] = [5,6,7]
print(d)
print(d2)

Также копию можно создавать и с помощью функции dict(), о которой мы с вами говорили на предыдущем занятии:

d2 = dict(d)

Результат будет абсолютно таким же, что и при вызове метода copy().

Следующий метод get позволяет получать значение словаря по ключу:

d.get("list")

Его отличие от оператора

d["list"]

в том, что при указании неверного ключа не возникает ошибки, а выдается по умолчанию значение None:

print(d.get(3))

Это значение можно изменить, указав его вторым аргументом:

print( d.get(3, False) )

Похожий метод

dict.setdefault(key[, default])

возвращает значение, ассоциированное с ключом key и если его нет, то добавляет в словарь со значением None, либо default – если оно указано:

d.setdefault("list")
d.setdefault(3)

Добавит ключ 3 со значением None. Удалим его:

del d[3]
d.setdefault(3, "three")

тогда добавится этот ключ со значением «three». То есть, этот метод способен создать новую запись, но только в том случае, если ключ отсутствует в словаре.

Следующий метод

d.pop(3)

удаляет указанный ключ и возвращает его значение. Если в нем указывается несуществующий ключ, то возникает ошибка:

d.pop("abc")

Но мы можем легко исправить ситуацию, если в качестве второго аргумента указать значение, возвращаемое при отсутствии ключа:

d.pop("abc", False)

Здесь возвратится False. Если же ключ присутствует, то возвращается его значение.

Следующий метод

d.popitem()

выполняет удаление произвольной записи из словаря. Если словарь пуст, то возникает ошибка:

d2 = {}
d2.popitem()

Следующий метод

d.keys()

возвращает коллекцию ключей. По умолчанию цикл for обходит именно эту коллекцию, при указании словаря:

d = {True: 1, False: "Ложь", "list": [1,2,3], 5: 5}
for x in d:
    print(x)

то есть, эта запись эквивалента такой:

for x in d.keys():
    ...

Если же вместо keys записать метод values:

for x in d.values():
    ...

то обход будет происходить по значениям, то есть, метод values возвращает коллекцию из значений словаря.

Последний подобный метод items

for x in d.items():
    ...

возвращает записи в виде кортежей: ключ, значение. О кортежах мы будем говорить позже, здесь лишь отмечу, что к элементу кортежа можно обратиться по индексу и вывести отдельно ключи и значения:

print(x[0], x[1])

Или, используя синтаксис множественного присваивания:

x,y = (1, 2)

можно записать цикл for в таком виде:

for key, value in d.items():
    print(key, value)

что гораздо удобнее и нагляднее.

Следующий метод update() позволяет обновлять словарь содержимым другого словаря. Например, есть два словаря:

d = dict(one = 1, two = 2, three = "3", four = "4")
d2 = {2: "неудовлетворительно", 3: "удовлетворительно", 'four': "хорошо", 5: "отлично"}

И мы хотим первый обновить содержимым второго:

d.update(d2)

Смотрите, ключ four был заменен строкой «хорошо», а остальные, не существующие ключи были добавлены.

Если же нам нужно создать новый словарь, который бы объединял содержимое обоих, то для этого можно воспользоваться конструкцией:

d3 = {**d, **d2}

Однако, детально как она работает будет понятно позже, когда мы познакомимся с операторами распаковки коллекций.

Итак, на этом занятии мы с вами познакомились с основными методами словарей, а также способами их перебора и объединения. Для закрепления этого материала выполните практические задания и переходите к следующему уроку.

Урок 31 · Часть I. Основы Python

Кортежи (tuple) и их методы

Источник: python3-kortezhi-tuple-i-ih-metody

На этом занятии мы с вами познакомимся с еще одной новой коллекцией данных – кортежами. Что такое кортеж? Это упорядоченная, но неизменяемая коллекция произвольных данных. Они, в целом, аналогичны спискам, но в отличие от них, элементы кортежей менять нельзя – это неизменяемый тип данных.

Иллюстрация к уроку

Для задания кортежа достаточно перечислить значения через запятую:

a = 1,2

или, что то же самое, в круглых скобках:

a = (1, 2, 3)

Но, обратите внимание, при определении кортежа с одним значение, следует использовать такой синтаксис:

b = 1, или b = (1,)

Здесь висячая запятая указывает, что единицу следует воспринимать как первый элемент кортежа, а не как число 1. Без запятой – это будет уже просто число один. Вот это нужно очень хорошо запомнить, начинающие программисты здесь часто делают ошибку, не прописывая висячую запятую.

Далее, мы можем переменным сразу присвоить соответствующие значения из кортежа, перечисляя их через запятую:

x, y = (1, 2)

но, если число переменных не будет совпадать с числом элементов кортежа:

x, y = (1, 2, 3)

то возникнет ошибка.

Длину кортежа (число его элементов) можно определить с помощью известной уже вам функции:

len(a)

А доступ к его элементам осуществляется также как и к элементам списков:

  • по индексу:

a[0] a[2] a[-1]

  • через срезы:

a[1:2] a[0:-1] a[:3] a[1:] a[:]

О срезах мы с вами уже подробно говорили, когда рассматривали списки, здесь все абсолютно также, кроме одной операции – взятия полного среза:

b = a[:]

В случае с кортежем здесь не создается его копии – это будет ссылка на тот же самый объект:

print(id(a), id(b))

Напомню, что для списков эта операция приводит к их копированию. Этот момент нужно также очень хорошо запомнить: для кортежей – возвращается тот же самый объект, а для списков – создается копия.

Некоторые из вас сейчас могут задаваться вопросом: зачем было придумывать кортежи, если списки способны выполнять тот же самый функционал? И даже больше – у них можно менять значения элементов, в отличие от кортежей? Да, все верно, по функциональности списки шире кортежей, но у последних все же есть свои преимущества.

Во-первых, то, что кортеж относится к неизменяемому типу данных, то мы можем использовать его, когда необходимо «запретить» программисту менять значения элементов списка. Например, вот такая операция:

a[1] = 100

приведет к ошибке. Менять значения кортежей нельзя. Во-вторых, кортежи можно использовать в качестве ключей у словарей, например, так:

d = {}
d[a] = "кортеж"

Напомню, что списки как ключи применять недопустимо, так как список – это изменяемый тип, а ключами могут быть только неизменяемые типы и кортежи здесь имеют преимущество перед списками.

В-третьих, кортеж занимает меньше памяти, чем такой же список, например:

lst=[1,2,3]
t = (1,2,3)
print(lst.__sizeof__())
print(t.__sizeof__())

Как видите, размер кортежа меньше, чем списка. Здесь использован метод sizeof, который возвращает размер данных в байтах.

Из всего этого можно сделать такой общий вывод: если мы работаем с неизменяемым упорядоченным списком, то предпочтительнее использовать кортеж.

Теперь, когда мы поняли, что кортежи играют свою значимую роль в программах на Python, вернемся к их рассмотрению. Чтобы создать пустой кортеж можно просто записать круглые скобки:

a = ()

или воспользоваться специальной встроенной функцией:

b = tuple()
print(type(a), type(b))

Но здесь сразу может возникнуть вопрос: зачем создавать пустой кортеж, если он относится к неизменяемым типам данных? Слово неизменяемый наводит на мысль, что вид кортежа остается неизменным. Но это не совсем так. В действительности, мы лишь не можем менять уже существующие элементы в кортеже, но можем создавать новые, используя оператор +, например:

a = ()
a = a +  (1,)

или для добавления данных в начало кортежа:

a = (2, 3) + a

Также можно добавить вложенный кортеж:

a += (("a", "hello"),)

или дублировать элементы кортежа через оператор *, подобно спискам:

b = (0,)*10
b = ("hello", "world") * 5

Как видите, все эти операции вполне допустимы. А вот удалять отдельные его элементы уже нельзя. Если мы попытаемся это сделать:

del a[1]

то возникнет ошибка. Правда, можно удалить объект целиком:

del a

тогда кортеж просто перестанет существовать, не будет даже пустого кортежа, здесь объект удаляется целиком.

Далее, с помощью функции tuple() можно создавать кортежи на основе любого итерируемого объекта, например, списков и строк:

a = tuple([1,2,3])
a = tuple("Привет мир")

А если нам нужно превратить кортеж в список, то подойдет известная нам функция list(), которая формирует список также из любого итерируемого объекта:

t = (1,2,3)
lst = list(t)

Так как кортеж – это перебираемый, то есть, итерируемый объект, то никто не мешает нам превращать его в список.

Как я отмечал в самом начале, кортежи могут хранить самые разные данные:

a = (True, [1,2,3], "hello", 5, {"house": "дом"})

Иллюстрация к уроку

Причем, смотрите, если обратиться, например, к списку:

a[1]

то это изменяемый объект, следовательно, его значение даже в кортеже мы можем спокойно менять:

a[1].append("5")

То есть, неизменность кортежа относится к его структуре элементов и значениям ссылок на объекты. Но, если сами объекты, при этом, могут меняться, то мы можем легко это делать. То есть, обращаясь ко второму элементу кортежа, мы, фактически, имеем список, с которым возможны все его операции без каких-либо ограничений. Я, думаю, это должно быть понятно?

В заключение этого занятия рассмотрим два метода, которые часто используются в кортежах – это:

  • tuple.count(значение) – возвращает число найденных элементов с указанным значением;
  • tuple.index(значение[, start[, stop]]) – возвращает индекс первого найденного элемента с указанным значением (start и stop – необязательные параметры, индексы начала и конца поиска).

Эти методы работают так же, как и у списков. Пусть у нас есть кортеж:

a = ("abc", 2, [1,2], True, 2, 5)

И мы хотим определить число элементов со значениями:

a.count("abc")
a.count(2)

Как видите, метод count() возвращает число таких элементов в кортеже. Если же элемент не будет найден:

a.count("a")

то возвращается 0. Следующий метод:

a.index(2)

возвращает индекс первого найденного элемента с указанным значением. Если значение не найдено:

a.index(3)

то этот метод приводит к ошибке. Поэтому, прежде чем его использовать, лучше проверить, а есть ли такое значение вообще в кортеже:

3 in a

Второй необязательный параметр

a.index(2, 3)

позволяет задавать индекс начала поиска. В данном случае поиск будет начинаться с третьего индекса. А последний третий аргумент:

a.index(2, 3, 5)

определяет индекс, до которого идет поиск (не включая его). Если же записать вот так:

a.index(2, 3, 4)

то возникнет ошибка, т.к. в поиск будет включен только 3-й индекс и там нет значения 2.

Надеюсь, из этого занятия вы узнали, что такое кортежи, как с ними можно работать и зачем они нужны. В целом, вы должны запомнить следующее: операторы работы с кортежами, а также функции и методы кортежей. Закрепите этот материал практическими заданиями и переходите к следующему уроку.

Урок 32 · Часть I. Основы Python

Множества (set) и их методы

Источник: python3-mnozhestva-set-i-ih-metody

На этом занятии мы с вами познакомимся с последней базовой коллекцией – множествами.

Формально, множество (set) – это неупорядоченная коллекция уникальных элементов. Уникальных, то есть, в ней отсутствуют дублирующие значения.

Для задания множества используются фигурные скобки, в которых через запятую перечисляются значения элементов:

a = {1, 2, 3, "hello"}

Это немного похоже на определение словаря, но в отличие от него, здесь не прописываются ключи – только значения. В результате получаем совершенно другой тип объекта – множество:

type(a)

Так как множество состоит только из уникальных значений, то попытка в него поместить несколько одинаковых значений:

a = {1, 2, 3, "hello", 2, 3, "hello"}

приведет к тому, что останутся только не повторяющиеся. Это ключевая особенность работы данной коллекции – она автоматически отбрасывает все дубли.

Во множество мы можем записывать только неизменяемые данные, такие как:

  • числа;
  • булевы значения;
  • строки;
  • кортежи

    a = {1, 4.5, “hi”, “hi”, (4, True), (“a”, False)}

А вот изменяемые типы данных:

  • списки;
  • словари;
  • множества

добавлять нельзя, будет ошибка:

b = {[1, 2], 3, 4}
b = {{1: 1, 2: 2}, 3, 4}
b = {{1, 2}, 3, 4}

Для создания множества используется встроенная функция set(). Если ее записать без аргументов:

set()

то получим пустое множество. Но, обратите внимание, если попытаться создать пустое множество вот так:

b = {}  # словарь

то получим не пустое множество, а пустой словарь! Пустое множество создается именно с помощью функции set(). Вот этот момент нужно запомнить.

Если указать какой-либо итерируемый объект, например, список:

set([1, 2, 1, 0, -1, 2])

то получим множество, состоящее из уникальных значений этого списка. Или, если передать строку:

set("abrakadabra")

то увидим множество из уникальных символов этой строки. И так для любого итерируемого объекта, даже можно прописать функцию range():

b = set(range(7))

Обратите внимание, множества представляют собой неупорядоченную коллекцию, то есть, значения элементов могут располагаться в них в любом порядке. Это также означает, что с множествами нельзя выполнять операции доступа по индексу или срезам:

b[0]

приведет к ошибке.

Для чего вообще может потребоваться такая коллекция в программировании? Я, думаю, большинство из вас уже догадались – с их помощью, например, можно легко и быстро убирать дубли из данных. Представим, что некоторая логистическая фирма составила список городов, куда доставляли товары:

cities = ["Калуга", "Краснодар", "Тюмень", "Ульяновск", "Москва", "Тюмень", "Калуга", "Ульяновск"]

И отдел статистики хотел бы получить список уникальных городов, с которыми было сотрудничество. Очевидно, это можно сделать с помощью множества:

set(cities)

Обратите внимание, порядок городов может быть любым, так как множество – неупорядоченная коллекция данных. Мало того, мы можем этот полученный перечень снова преобразовать в список, используя функцию:

list(set(cities))

Все, мы отобрали уникальные города и представили их в виде списка. Видите, как это легко и просто можно сделать с помощью множеств.

А что если нам не нужен список уникальных городов, а достаточно лишь перебрать все элементы полученного множества:

q = set(cities)

Учитывая, что множество – это итерируемый объект, то пройтись по всем его элементам можно с помощью цикла for:

for c in q:
     print(c)

Здесь переменная c последовательно ссылается на значения элементов множества q и соответствующий город выводится в консоль. Или, то же самое можно сделать через механизм итераторов:

it = iter(q)
next(it)

Наконец, функция:

a = {"abc", (1, 2), 5, 4, True}
len(a)

возвратит нам число элементов в множестве. А для проверки наличия значения в множестве можно воспользоваться, уже знакомым нам оператором in:

"abc" in a

Он возвращает True, если значение имеется и False в противном случае. Или можно проверить на непринадлежность какого-либо значения:

7 not in a

Методы добавления/удаления элементов множества

В заключение этого занятия рассмотрим методы для добавления и удаления элементов в множествах. Первый метод add() позволяет добавлять новое значение в множество:

b.add(7)

Значение будет добавлено только в том случае, если оно отсутствует в множестве b. Если попробовать, например, еще раз добавить семерку:

b.add(7)

то множество не изменится, но и ошибок никаких не будет.

Если в множество требуется добавить сразу несколько значений, то для этого хорошо подходит метод update():

b.update(["a", "b", (1, 2)])

В качестве аргумента указывается любой итерируемый объект, в данном случае, список, значения которого добавляются в множество с проверкой уникальности. Или, можно передать строку:

b.update("abrakadabra")

Получим добавку в виде уникальных символов этой строки. И так далее, в качестве аргумента метода update() можно указывать любой перебираемый объект.

Далее, для удаления элемента по значению используется метод discard():

b.discard(2)

Если еще раз попытаться удалить двойку:

b.discard(2)

то ничего не произойдет и множество не изменится.

Другой метод для удаления элемента по значению – remove():

b.remove(4)

но при повторном таком вызове:

b.remove(4)

возникнет ошибка, т.к. значение 4 в множестве уже нет. То есть, данный метод возвращает ошибку при попытке удаления несуществующего значения. Это единственное отличие в работе этих двух методов.

Также удалять элементы можно и с помощью метода pop:

b.pop()

При этом он возвращает удаляемое значение, а сам удаляемый элемент оказывается, в общем-то, случайным, т.к. множество – это неупорядоченная коллекция. Если вызвать этот метод для пустого множества, то возникнет ошибка:

c=set()
c.pop()

Наконец, если нужно просто удалить все элементы из множества, то используется метод:

b.clear()

На этом мы с вами завершим первое знакомство с множествами. Для закрепления материала, как всегда, вас ждут практические задания, а я буду всех вас ждать на следующем уроке.

Урок 33 · Часть I. Основы Python

Операции над множествами, сравнение множеств

Источник: python3-operacii-nad-mnozhestvami-sravnenie-mnozhestv

На этом занятии мы с вами будем говорить об операциях над ними – это:

  • пересечение множеств;
  • объединение множеств;
  • вычитание множеств;
  • вычисление симметричной разности.

Для простоты зададим два множества с числами:

setA = {1, 2, 3, 4}
setB = {3, 4, 5, 6, 7}

На их основе можно построить третье множество, как результат пересечения этих двух:

setA & setB

Иллюстрация к уроку

На выходе получаем новое множество, состоящее из значений, общих для множеств setA и setB. Это и есть операция пересечения двух множеств. При этом, исходные множества остаются без изменений. Здесь именно создается новое множество с результатом выполнения этой операции.

Разумеется, чтобы в дальнейшем в программе работать с полученным результатом, его нужно сохранить через какую-либо переменную, например, так:

res = setA & setB

Также допустима запись в виде:

setA &= setB

это будет эквивалент строчки:

setA = setA & setB

То есть, мы вычисляем результат пересечения и сохраняем его в переменной seta и, как бы, меняем само множество setA.

А вот если взять множество:

setC = {9, 10, 11}

которое не имеет общих значений с другим пересекающимся множеством, то результатом:

setA & setC

будет пустое множество.

Обычно, на практике используют оператор пересечения &, но вместо него можно использовать специальный метод:

setA = {1, 2, 3, 4}
setB = {3, 4, 5, 6, 7}
setA.intersection(setB)

Результат будет тем же, на выходе получим третье множество, состоящее из общих значений множеств setA и setB. Если же мы хотим выполнить аналог операции:

setA &= setB

то для этого следует использовать другой метод:

setA.intersection_update(setB)

В результате, меняется само множество setA, в котором хранятся значения пересечения двух множеств.

Вот такие способы вычислений пересечения множеств существуют в Python.

Объединение множеств

Следующая операция – это объединение двух множеств. Она записывается, так:

setA = {1, 2, 3, 4}
setB = {3, 4, 5, 6, 7}
setA | setB

Иллюстрация к уроку

На выходе также получаем новое множество, состоящее из всех значений обоих множеств, разумеется, без их дублирования.

Или же можно воспользоваться эквивалентным методом:

setA.union(setB)

который возвращает множество из объединенных значений. При этом, сами множества остаются без изменений.

Операцию объединения можно записать также в виде:

setA |= setB

Тогда уже само множество setA будет хранить результат объединения двух множеств, то есть, оно изменится. Множество setB останется без изменений.

Вычитание множеств

Следующая операция – это вычитание множеств. Например, для множеств:

setA = {1,2,3,4}
setB = {3,4,5,6,7}

операция

setA - setB

возвратит новое множество, в котором из множества setA будут удалены все значения, повторяющиеся в множестве setB:

{1, 2}

Иллюстрация к уроку

Или, наоборот, если из множества setB вычесть множество setA:

setB - setA

то получим значения из которых исключены величины, входящие в множество setA.

Также здесь можно выполнять эквивалентные операции:

setA -= setB
setB -= setA

В этом случае переменные setA и setB будут ссылаться на соответствующие результаты вычитаний.

Симметричная разность

Наконец, последняя операции над множествами – симметричная разность, возвращает множество, состоящее из неповторяющихся значений обоих множеств. Реализуется она следующим образом:

setA = {1,2,3,4}
setB = {3,4,5,6,7}
setA ^ setB

На выходе получим третье, новое множество, состоящее из значений, не входящих одновременно в оба множества.

Иллюстрация к уроку

Сравнение множеств

В заключение этого занятия я хочу показать вам, как можно сравнивать множества между собой.

Предположим, имеются два таких множества:

setA = {7, 6, 5, 4, 3}
setB = {3, 4, 5, 6, 7}

И мы хотим узнать, равны они или нет. Для этого, используется уже знакомый нам оператор сравнения на равенство:

setA == setB

Увидим значение True (истина). Почему? Дело в том, что множества считаются равными, если все элементы, входящие в одно из них, также принадлежат другому и мощности этих множеств равны (то есть они содержат одинаковое число элементов). Наши множества setA и setB удовлетворяют этим условиям.

Соответственно, противоположное сравнение на не равенство, выполняется, следующим образом:

setA != setB

Следующие два оператора сравнения на больше и меньше, фактически, определяют, входит ли одно множество в другое или нет.

Иллюстрация к уроку

Например, возьмем множества

setA = {7, 6, 5, 4, 3}
setB = {3, 4, 5}

тогда операция

setB < setA

вернет True, а операция

setB > setA

значение False. Но, если хотя бы один элемент множества setB не будет принадлежать множеству setA:

setB.add(22)

то обе операции вернут False. Для равных множеств

setA = {7, 6, 5, 4, 3}
setB = {3, 4, 5, 6, 7}

обе операции также вернут False. Но вот такие операторы:

setA <= setB
setA >= setB

вернут True.

Я, думаю, из этих примеров понятно, как выполняется сравнение множеств между собой.

Для закрепления этого материала, как всегда, пройдите практические задания и, затем, дальше – на покорение новых вершин языка Python. Буду вас ждать на следующем уроке.

Практика 7 · Часть I. Основы Python

Словари, кортежи и множества

Задания для закрепления темы · решений нет

Цели обучения

  • Искать, обновлять и перебирать dict (keys, values, items)
  • Рассматривать кортежи как неизменяемые записи
  • Применять алгебру множеств: объединение, пересечение, разность, симметрическая разность

Задания

Задание 1. Инверсия словаря

Сложность: лёгкое

Реализуйте invert(d: dict) -> dict: поменяйте ключи и значения местами. Считайте значения уникальными и хешируемыми.

Требования:

  • Верните новый dict
  • Пустой → {}

Пример:

invert({"a": 1, "b": 2})  # {1: "a", 2: "b"}

Задание 2. Слияние счётчиков

Сложность: лёгкое

Реализуйте merge_counts(a: dict, b: dict) -> dict: для каждого ключа сложите целочисленные счётчики из a и b (отсутствующий ключ считается 0).

Требования:

  • Не мутируйте a и b
  • Включите ключи из обоих словарей

Пример:

merge_counts({"x": 1, "y": 2}, {"y": 3, "z": 4})
# {"x": 1, "y": 5, "z": 4}

Задание 3. Расстояние между точками

Сложность: среднее

Представляйте точки кортежами (x, y). Реализуйте distance(p1: tuple, p2: tuple) -> float (евклидово). Используйте распаковку.

Требования:

  • Распаковка: x1, y1 = p1
  • Верните float (корень через ** 0.5 или math.sqrt)

Пример:

distance((0, 0), (3, 4))  # 5.0

Задание 4. Общие теги

Сложность: среднее

Реализуйте common_tags(posts: list[dict]) -> set: пересечение всех наборов/списков "tags" в каждом dict поста. Если posts пуст, верните set().

Каждый пост выглядит как {"title": "...", "tags": ["python", "tips"]}.

Требования:

  • Используйте операции над множествами (& или .intersection)
  • Нормализуйте теги к строкам в нижнем регистре

Пример:

posts = [
    {"title": "A", "tags": ["Python", "oop"]},
    {"title": "B", "tags": ["python", "django"]},
]
common_tags(posts)  # {"python"}

Задание 5. Группировка по длине

Сложность: среднее

Реализуйте group_by_len(words: list[str]) -> dict[int, list[str]]: длина слова → список слов этой длины (порядок сохранять).

Требования:

  • Используйте методы dict (setdefault или get)
  • Пустой ввод → {}

Пример:

group_by_len(["a", "bb", "c", "dd"])
# {1: ["a", "c"], 2: ["bb", "dd"]}

Задание 6. Мягкие рекомендации друзей

Сложность: сложное

Есть follows: dict[str, set[str]] — пользователь → множество тех, на кого он подписан.

Реализуйте:

  • mutual_follows(follows, u, v) -> set[str] — пользователи, на которых подписаны и u, и v
  • suggest_friends(follows, user) -> set[str] — люди, на которых подписан кто-то из подписок user, исключая самого user и тех, на кого user уже подписан

Требования:

  • Отсутствующие ключи считайте пустыми множествами
  • Используйте разность / объединение / пересечение множеств

Пример:

follows = {
    "ann": {"bob", "cara"},
    "bob": {"cara", "dan"},
    "cara": {"dan"},
}
mutual_follows(follows, "ann", "bob")  # {"cara"}
suggest_friends(follows, "ann")        # {"dan"}

Глава 8

Функции

Урок 35 · Часть I. Основы Python

Функции: первое знакомство, определение def и их вызов

Источник: python3-funkcii-pervoe-znakomstvo-opredelenie-def-i-ih-vyzov

Этим занятием мы открываем с вами одну из ключевых тем в программировании – функции.

Иллюстрация к уроку

Что это такое? Условно, их можно представить как активный объект, который не просто хранит какие-либо данные, а выполняет заданный фрагмент программы. Ссылка на такой объект называется именем функции. Например, знакомая нам функция print выполняет вывод в консоль переданных ей данных. Имя этой функции так и можно воспринимать, как ссылку на свой объект-функцию. Действительно, если в интерактивном режиме напечатать имя print, то увидим, что оно ссылается на встроенную функцию. Чтобы активизировать программу, заложенную в объект-функцию, нужно поставить круглые скобки после имени функции:

print()

Теперь был исполнен определенный код и в консоль была выведена пустая строка. Эти круглые скобки являются оператором вызова функций. То есть, само по себе имя – это ссылка на функцию, а имя функции с круглыми скобками – это уже вызов функции. Вот этот момент нужно очень хорошо и четко понимать, чтобы уметь правильно обращаться с функциями при построении программ.

Итак, раз print – это ссылка на функцию, то что нам тогда мешает создать еще одну ссылку на этот же объект-функцию, через оператор присваивания:

f = print

И вызвать ее через второе имя f:

f("hello")

Иллюстрация к уроку

Как видите, все работает. Теперь функцию print можно вызывать и через f. А можно ли тогда исходному имени функции print присвоить другой объект, например, строку:

print = "это была функция print"

Да, и это нам никто не мешает делать. Теперь прежнюю функцию можно вызвать только через имя f:

f(print)

То есть, имя функции – это просто ссылка на объект-функцию и не более того. Конечно, заменять стандартные имена функций на другие, без острой необходимости не стоит. А вначале лучше совсем этого не делать. Именно этого правила и следует придерживаться.

Хорошо, мы теперь знаем, как правильно воспринимать функцию в Python. Но зачем они нужны? Разве нельзя писать программы и без них? Конечно можно. И самые первые языки программирования их даже не имели. Но писать программы без них, это все равно, что поехать в другой город на лошади, а не на автомобиле. С функциями программы становятся более модульными, а процесс программирования значительно упрощается. Так за счет чего это происходит?

Допустим, мы пишем программу, в которой постоянно нужно делать отправку электронных писем по одному и тому же алгоритму. В результате, у нас в программе будут постоянно появляться одни и те же строчки кода для отправки писем. Такое дублирование программного кода негативно влияет на надежность программ, возможность их быстрого редактирования, читабельности и т.п. В программирование это называется кратко:

DRY – Don’t Repeat Yourself

Как только, вы замечаете в программе повторение (дублирование) кода, значит, неверно строите ее архитектуру и структуру кода следует пересмотреть. Это очень грубая ошибка в программировании.

Так вот, чтобы нам устранить дублирование при отправке электронных писем, повторяющийся фрагмент можно поместить в функцию, а затем, вызывать ее в нужных местах программы. Это первое, для чего были введены функции в языки программирования – устранять дублирование кода.

В Python существует множество стандартных, встроенных функций, но на все случаи жизни их не придумаешь. Поэтому, программист может сам создавать свои собственные по мере необходимости. Для этого используется следующий синтаксис:

def <имя функции>([список аргументов]):
оператор 1
оператор 2
…
оператор N

Здесь имя функции придумывается программистом подобно именам переменных и, так как функция – это определенное действие, то ее имя следует выбирать как глагол, например:

go, show, get, set и т.п.

Далее, идет набор операторов, которые образуют тело функции. Именно они начинают выполнятся при ее вызове.

Иллюстрация к уроку

Давайте в качестве примера, зададим простую функцию, которая будет имитировать отправку письма:

def send_mail():
    text = "Уважаемый, Сергей Балакирев! Я так и не понял, что такое функция. Объясните лучше!"
    print(text)

Обратите внимание, имя функции send_mail – фраза-глагол, действие. Кроме того, два разных слова send и mail отделены символом подчеркивания. Я его записал для лучшей читаемости текста программы. И, глядя на название функции, сразу понятно, что она должна делать. Это рекомендуемый подход к программированию – называть переменные и функции понятными именами.

Тело этой функции состоит из двух команд: переменной text со строкой и функции print(). Так как вы дошли до этого урока, то должны хорошо понимать, почему эти две строчки образуют единый блок операторов тела функции. Да, у них у всех единый отступ от левого края. Здесь все также, как и в условных операторах или операторах циклов. Поэтому повторяться не буду.

Итак, мы с вами определили функцию. Но, если сейчас запустить эту программу, то в консоли ничего не увидим, то есть, функция не сработала. Все верно, на данном этапе мы лишь определили, объявили функцию, но еще не вызывали. Как я говорил вначале, для вызова функции нужно записать ее имя и поставить круглые скобки – оператор вызова функции:

send_mail()

Теперь, при запуске программы, мы видим заветное сообщение. Обратите внимание, я записал вызов функции через две пустые строки после объявления функции. Это оформление по рекомендации стандарта PEP8. В интегрированной среде PyCharm, чтобы привести текст программы в соответствие с этим стандартом, достаточно нажать комбинацию клавиш Alt + Ctrl + L.

Эту же функцию мы можем вызвать и дважды:

send_mail()
send_mail()

Соответственно, она сработает два раза подряд. И еще, обратите внимание, мы можем вызывать функцию только после ее объявления. То есть, сначала сделать ее вызов, а потом объявить не получится, возникнет ошибка, что имя send_mail не определено. Нужно сначала объявлять функции и только потом их вызывать.

Вернем два подряд идущих вызова функции send_mail() и посмотрим в режиме отладки, как будет выполняться эта программа (показываем). Если нажать F8, то мы сразу выполним функцию. Чтобы зайти внутрь ее нужно нажать клавишу F7. А в теле функции уже можно F8. Так будет понятнее, как выполняется эта программа.

Сейчас у нашей функции нет никаких параметров. Давайте добавим один с именем отправителя:

def send_mail(from_name):
    text = f"""Уважаемый, Сергей Балакирев! 
Я так и не понял, что такое функция. 
Объясните лучше!
Ваш, навсегда {from_name}!"""
    print(text)

Для этого в круглых скобках записываем параметр с именем from_name (это имя мы придумываем сами, я решил назвать так) и, затем, в многострочной F-строке мы добавим это имя в конце сообщения.

Теперь функцию send_mail() следует вызывать с одним аргументом и по нашей задумке этот аргумент должен быть строкой, поэтому, запишем вызов, так:

send_mail("Иван Иванович")

а второй вызов поставим в комментарий. После запуска программы увидим сформированное сообщение. Здесь важно понять, как все это работает.

Во-первых, обратите внимание на терминологию. Определение внутри функции называется параметром, а передаваемое значение при вызове функции – аргументом. В дальнейшем, я буду пользоваться этими словами именно в этом смысле. Во-вторых, когда происходит вызов функции, то параметр ссылается на переданный аргумент. В итоге, в теле функции from_name принимает значение “Иван Иванович”, которое и подставляется в шаблон сообщения.

Давайте посмотрим, как это происходит в режиме отладки (показываем).

А что будет, если теперь попытаться вызвать эту же функцию без аргументов, так как мы это делали вначале? (Убираем комментарий). Здесь уже возникает ошибка, что функций ожидает один аргумент, а мы ничего не передаем. То же самое будет, если передать больше аргументов, например, два:

send_mail("Иван Иванович", "Сергей Балакирев")

То есть, функции нужно передавать ровно столько аргументов, сколько параметров в ней определено. Давайте пропишем второй параметр – возраст отправителя:

def send_mail(from_name, old):
    text = f"""Уважаемый, Сергей Балакирев! 
Я так и не понял, что такое функция. 
Объясните лучше!
Ваш, навсегда {from_name}! И не судите строго, мне всего {old} лет."""
 
    print(text)

Как видите, параметры записываются в круглых скобках через запятую и принимают значения аргументов при вызове функции:

send_mail("Иван Иванович", 7)
send_mail("Иван Иванович", "Сергей Балакирев")

Причем, на первый аргумент ссылается первый параметр, а на второй – второй. То есть, порядок здесь имеет значение. Также, смотрите, при втором вызове у нас вместо числа указана строка. Параметру все равно на какой тип данных ссылаться, так как в Python используется динамическая типизация (мы об этом ранее говорили). В итоге, второе сообщение несколько бессмысленно, но, тем не менее, все сработало без ошибок.

Итак, на этом первом занятии по функциям, мы с вами узнали, что это такое и зачем они нужны, как объявляются функции и как они вызываются с разным числом аргументов. Для закрепления этого материала пройдите практические задания и переходите к следующему уроку, где мы продолжим изучение этой темы.

Урок 36 · Часть I. Основы Python

Оператор return в функциях. Функциональное программирование

Источник: python3-operator-return-v-funkciyah-funkcionalnoe-programmirovanie

На прошлом занятии мы увидели, как их можно объявлять и вызывать. Сегодня сделаем следующий шаг и разберемся, как функции могут возвращать результаты своей деятельности.

Я открою программу, которую мы делали на предыдущем занятии с функцией send_mail(). И давайте здесь объявим еще одну функцию, которая бы вычисляла квадратный корень из положительных чисел:

def get_sqrt(x):
    res = None if x < 0 else x ** 0.5

Обратите внимание, что в соответствии со стандартом PEP8 каждое объявление функции разделяется двумя пустыми строчками. Рекомендуется так делать, чтобы текст программы был хорошо читаем.

Итак, у нас здесь функция с именем get_sqrt(), которое я сам придумал и одним параметром x. Внутри функции я воспользовался тернарным условным оператором, так что переменная res будет принимать None для отрицательных значений и квадратный корень – для неотрицательных.

Давайте попробуем ее вызвать и посмотрим, что она возвратит:

a = get_sqrt(49)
print(a)

Во-первых, мы здесь видим новую конструкцию: переменной a присваиваем вызов функции. Это следует воспринимать так, что переменная a будет ссылаться на результат работы этой функции. Что такое результат работы функции, мы сейчас узнаем. В данном случае, значение a равно None. Фактически, это означает, что функция ничего не возвращает, никакого результата! Но почему? Мы же в теле этой функции делаем вычисление квадратного корня? И аргумент передаем положительный. Все дело в том, что внутри функции нужно явно указать, что именно она должна вернуть. Делается это с помощью специального оператора return, после которого через пробел указываются данные, которые будут возвращены. В данном случае, пропишем переменную res.

Снова запустим программу и, смотрите, теперь наша переменная a ссылается на вычисленное значение. Как это произошло? Оператор res вернул объект с вычисленным значением 7.0 и это означает, что функция возвращает этот объект. Затем, с помощью оператора присваивания, создалась переменная a со ссылкой на этот объект. Поэтому при выводе этой переменной, мы видим значение 7.0

Причем, вот этот вот параметр x и переменная res существуют только в момент вызова функции get_sqrt() и пропадают за ее пределами. Мы об этом еще поговорим. Но, пока имейте в виду, что за пределами функции вывести напрямую переменную res, например, не получится:

print(a, res)

возникнет ошибка, что имя res не определено.

Внутри тела функции можно указывать только один оператор return, либо ни одного, тогда функция будет возвращать значение None, как мы только что видели. Но, что если все же прописать в функции два оператора return, что будет? Давайте посмотрим:

def get_sqrt(x):
    res = None if x < 0 else x ** 0.5
    return res
    return x

Нам интегрированная среда здесь сразу указывает писать этот оператор без отступов. Сейчас вы поймете почему. Запускаем программу и видим, что никаких ошибок нет и отображается прежнее значение 7.0. Дело в том, что функция завершает свою работу сразу, как только встретит оператор return. Поэтому, как только была выполнена строчка return res, все остальные команды в теле функции просто игнорируются. Убедимся в этом на отладке (убеждаемся). Поэтому второй return здесь просто бессмысленен – он никогда не будет выполнен. Равно, как и любая другая команда, например, функция print():

def get_sqrt(x):
    res = None if x < 0 else x ** 0.5
    return res
    print(x)

А вот если ее записать до этого оператора, то увидим вывод x, а затем, вычисленного значения res.

Но все же, что делать, если нам нужно вернуть оба значения и res и x? Для этого следует поместить эти переменные в коллекцию, обычно, кортеж и вернуть ее:

def get_sqrt(x):
    res = None if x < 0 else x ** 0.5
    return (res, x)

На практике часто не пишут круглые скобки, а просто записывают элементы через запятую:

return res, x

В дальнейшем, я именно так и буду делать. Причем, теперь, мы можем принимать данные, используя множественное присваивание:

a, b = get_sqrt(49)
print(a, b)

Видите, как это удобно, легко и наглядно делается в языке Python. Далеко не во всех языках программирования можно вот так запросто вернуть несколько значений через функцию.

Давайте зададим в программе еще одну функцию для определения максимального значения среди двух чисел:

def get_max2(a, b):
    return a if a > b else b

Казалось бы, что может быть примечательного в такой простой функции. Но, не торопитесь, сейчас кое-какая магия откроется перед вами. Вызвать эту функцию можно, очевидным образом, например, так:

x, y = 5, 7
print(get_max2(x, y))

Я здесь специально определил дополнительно две переменные x, y, чтобы показать, что их также можно спокойно передавать в качестве аргументов. После запуска в консоли увидим максимальное значение 7.

Давайте теперь усложним задачу и будем искать максимум среди трех чисел. Помните, для этого мы использовали вложенные условия. Здесь же, поступим иначе. Определим три переменные и воспользуемся все той же функцией get_max2():

x, y, z = 5, 7, 10
print(get_max2(x, get_max2(y, z)))

Иллюстрация к уроку

Вот это и есть обещанная магия. Смотрите, как это работает. Сначала будет вызвана функция, записанная в качестве аргумента, которая возвратит максимальное среди чисел 7 и 10, то есть, значение 10, а затем, вызывается первая функция, которая определяет максимум из чисел 5 и 10. Соответственно, на выходе получаем результат 10, который и выводится в консоль. Вот так функции можно записывать в аргументах и использовать в своих программах. Мало того, мы можем ту же самую конструкцию использовать и при объявлении новой функции, определяющей максимум среди трех чисел:

def get_max3(a, b, c):
    return get_max2(a, get_max2(b, c))

А, затем, просто вызвать ее с тремя аргументами:

print(get_max3(x, y, z))

Видите, как элегантно можно решить эту задачу, используя функциональный подход в программировании. Разумеется, здесь функция get_max3() должна объявляться после функции get_max2(), так как использует ее, иначе, мы бы получили ошибку.

Вообще, определение (объявление) функций в Python очень похоже на объявление переменных. Например, в программе, нам никто не запрещает объявить некую переменную с именем get_rect и присвоить ей значение 1 или 2 в зависимости от значения другой переменной PERIMETR:

PERIMETR = True
 
if PERIMETR:
    get_rect = 1
else:
    get_rect = 2

Но оказывается, то же самое можно делать и на уровне функций, вместо переменной get_rect будем объявлять разные функции:

if PERIMETR:
    def get_rect(a, b):
        return 2 * (a + b)
else:
    def get_rect(a, b):
        return a * b

И, если сейчас вызвать ее:

print(get_rect(1.5, 3.8))

то получим вычисление периметра прямоугольника. Если же переменную PERIMETR изменить на False:

PERIMETR = False

то функция с именем get_rect() теперь будет вычислять площадь прямоугольника. Здорово, да! Какая гибкость определения функций в языке Python! Такого мало где встретишь.

Наконец, мы можем вообще убрать условие и дважды определить одну и ту же функцию:

def get_rect(a, b):
    return 2 * (a + b)
 
 
def get_rect(a, b):
    return a * b

К ошибкам это не приведет, а просто ссылка get_rect будет инициализирована на второй объект-функцию и, соответственно, она и будет вызвана.

В заключение занятия приведу еще один пример использования функций. Объявим функцию для определения четности числа:

def even(x):
    return x % 2 == 0

А, затем, вызовем ее в цикле для определения: является ли текущее число четным:

for i in range(1, 20):
    if even(i):
        print(i)

После запуска в консоли увидим отображение только четных чисел.

На этом мы завершим наше второе занятие по функциям. Из него вам должно быть понятно, как и для чего используется оператор return, как вызываются функции, записанные в аргументах другой функции, а также объявление функций, подобно переменным. Если все это, действительно, понятно, то переходите к практическим заданиям, пока я собираюсь с мыслями для следующего урока.

Урок 37 · Часть I. Основы Python

Алгоритм Евклида для нахождения НОД

Источник: python3-algoritm-evklida-dlya-nahozhdeniya-nod

На этом занятии я хочу показать вам пример использования функций для решения одной частной задачи – нахождения наибольшего общего делителя (НОД) для двух натуральных чисел a и b. Причем, мы не просто напишем алгоритм, а еще выполним его тестирование с применением тестирующей функции. То есть, это будет полноценный пример, показывающий принцип разработки программ с использованием функций и тестов.

Но, вначале пару слов о самом алгоритме Евклида, о принципе его работы. Сначала рассмотрим его медленный, но простой вариант.

Например, пусть даны два натуральных числа: a = 18 и b = 24. Чтобы определить для них НОД, будем действовать, следующим образом. Из большего значения вычтем меньшее и результат сохраним в переменной с большим значением, то есть, в b. Фактически, это означает, что мы выполняем операцию: b = b - a. Теперь у нас два значения a = 18, b = 6. Для них повторяем тот же самый процесс. Здесь большее уже переменная a, поэтому, корректируем ее значение, вычитая меньшее. Получаем новую пару a = 12, b = 6. Опять повторяем этот процесс и видим, что a = 6, b = 6 – переменные равны. В этом случае останавливаем алгоритм и получаем, что НОД(18, 24) = 6, что, в общем то, верно.

Весь этот алгоритм можно представить следующим псевдокодом:

пока a != b
находим большее среди a и b
уменьшаем большее на величину меньшего

выводим полученное значение величины a (или b)

Давайте его опишем с помощью, следующей функции:

def get_nod(a, b):
    """Вычисляется НОД для натуральных чисел a и b
        по алгоритму Евклида.
        Возвращает вычисленный НОД.
    """
    while a != b:
        if a > b:
            a -= b
        else:
            b -= a
 
    return a

Смотрите, здесь вначале идет многострочная строка с описанием работы функции. Так рекомендуется делать для ключевых функций программы, чтобы другие программисты могли быстро понимать, как их применять на практике. А, далее, после описания следует сам алгоритм Евклида.

Выполним эту функцию со значениями аргументов 18 и 24:

res = get_nod(18, 24)
print(res)

Видим в консоли верное значение 6. Вот пример правильного оформления ключевых функций программы. Мало того, встроенная функция:

help(get_nod)

позволяет выводить описание указанных функций. И мы видим в консоли наше сформированное сообщение. Это очень удобно, особенно при групповой работе над проектом.

После того, как функция определена, ее следует протестировать и убедиться в корректности возвращаемых результатов. Для этого тестировщик создает свою вспомогательную функцию. Используя наши текущие знания, мы ее опишем, следующим образом:

def test_nod(func):
    # -- тест №1 -------------------------------
    a = 28
    b = 35
    res = func(a, b)
    if res == 7:
        print("#test1 - ok")
    else:
        print("#test1 - fail")
 
    # -- тест №2 -------------------------------
    a = 100
    b = 1
    res = func(a, b)
    if res == 1:
        print("#test2 - ok")
    else:
        print("#test2 - fail")
 
    # -- тест №3 -------------------------------
    a = 2
    b = 10000000
 
    st = time.time()
    res = func(a, b)
    et = time.time()
    dt = et - st
    if res == 2 and dt < 1:
        print("#test3 - ok")
    else:
        print("#test3 - fail")

В первых двух тестах мы проверяем корректность вычислений, а в третьем – еще и скорость работы. Конечно, это довольно примитивное тестирование, показывающее лишь принцип разработки программы, но для учебных целей вполне достаточно.

Далее, выполним импорт нужного нам модуля time для вызова функции time():

import time

и в конце вызовем тестирующую функцию для тестирования get_nod:

test_nod(get_nod)

Смотрите, у нас первые два теста прошли, а третий – не прошел, так как функция слишком долго вычисляла результат.

Давайте поправим ее и ускорим алгоритм Евклида. Как это можно сделать? Смотрите, если взять два числа a = 2 и b = 100, то по изначальному алгоритму мы будем делать многочисленные вычитания из b a, пока значения не сравняются. То есть, мы здесь, фактически, вычисляем остаток от вхождения двойки в сотню, а это есть не что иное, как операция:

b = b % a = 0

И никаких циклических вычитаний! Это, очевидно, будет работать много быстрее. При этом, как только получаем остаток равный нулю, то НОД – это значение меньшей переменной, то есть, в нашем примере – a = 2.

То же самое для предыдущих значений a = 18, b = 24. Получаем серию таких вычислений:

b = 24 % 18 = 6
a = 18 % 6 = 0

Значит, НОД(18, 24) = 6. Видите, как это быстро и просто! На уровне псевдокода быстрый алгоритм Евклида можно описать так:

  1. пока меньшее число больше 0
  2. большему числу присваиваем остаток от деления на меньшее число
  3. выводим большее число

Реализуем его в виде функции:

def get_fast_nod(a, b):
    """Вычисляется НОД для натуральных чисел a и b
        по быстрому алгоритму Евклида.
        Возвращает вычисленный НОД.
    """
    if a < b:
        a, b = b, a
 
    while b != 0:
        a, b = b, a % b
 
    return a

Предлагаю, в качестве самостоятельного задания, вам самим в деталях разобраться, как она работает. А мы ее сразу протестируем:

test_nod(get_fast_nod)

Как видите, она проходит все три наших теста.

Надеюсь, из этого занятия мне удалось донести до вас общий принцип разработки и тестирования ключевых программных функций. А также объяснить работу алгоритма Евклида. Если все это понятно, то смело переходите к следующему уроку.

Урок 38 · Часть I. Основы Python

Позиционные и именованные аргументы. Параметры со значениями

Источник: python3-imenovannye-argumenty-fakticheskie-i-formalnye-parametry

Сейчас мы с вами будем говорить о способах определения параметров в функциях и передачи им аргументов. Казалось бы, мы подробно разобрали эту тему и каждый из вас уже знает, что при объявлении функции в круглых скобках через запятую можно указать сколько угодно параметров. Например, простая функция вычисления объема прямоугольного параллелепипеда, очевидно должна принимать, как минимум, три параметра (ширину, высоту и глубину):

def get_V(a, b, c):
    print(f"a = {a}, b = {b}, c = {c}")
    return a * b * c

А, затем, может быть вызвана с конкретными числовыми значениями:

v = get_V(1, 2, 3)
print(v)

Причем, параметру a будет соответствовать число 1, параметру b – число 2, а c – число 3. Это так, потому что здесь используется позиционная запись аргументов при вызове функции, то есть, значения параметров a, b, c определяются порядком записи аргументов. А можно ли, не меняя порядка, параметру b присвоить 1, параметру c – 2, а a – 3? Оказывается да, в языке Python такое возможно, если явно указывать имена параметров при вызове функции:

v = get_V(b=1, a=2, c=3)

Такие аргументы называются именованными. Теперь, при запуске программы, мы видим, указанные значения у параметров a, b и c.

А можем ли мы комбинировать позиционные и именованные аргументы? Да и такое тоже возможно. Только вначале следует указывать позиционные, а в конце – именованные, например, так:

v = get_V(1, c=2, b=3)

Если же, мы не будем следовать этому правилу и позиционные аргументы запишем после именованного:

v = get_V(a=1, 2, 3)

то возникнет синтаксическая ошибка – так делать нельзя. Сначала всегда позиционные и только потом – именованные:

v = get_V(1, 2, c=3)

Причем, обратите внимание, последним именованным аргументом здесь может быть только имя параметра c. Если записать любой другой из трех, например b:

v = get_V(1, 2, b=3)

то у нас получится дублирование передаваемых данных. Второй позиционный аргумент уже присваивается параметру b, а далее, мы снова этому же параметру присваиваем значение 3. Так делать нельзя.

Вернемся теперь к параметрам самой функции. Мы их объявили просто через запятую с именами a, b, c. Однако, можно задавать параметры со значениями по умолчанию, например, так:

def get_V(a, b, c, verbose=True):
    if verbose:
        print(f"a = {a}, b = {b}, c = {c}")
 
    return a * b * c

Такие параметры называются формальными, а обычные – фактическими. В чем отличие формальных параметров от фактических, помимо значений по умолчанию? Их не обязательно прописывать при вызове функции. Например, наш прежний вызов:

v = get_V(1, 2, 3)

сработает без каких-либо проблем. Мы не указали аргумент для последнего формального параметра verbose. В этом случае он принимает значение по умолчанию True. Если же указать его:

v = get_V(1, 2, 3, False)

то функция print() внутри функции вызвана уже не будет. Разумеется, можно использовать и соответствующий именованный аргумент:

v = get_V(1, 2, 3, verbose=False)

Все будет работать также.

Зачем вообще нужны формальные параметры и когда их следует использовать? Я, думаю, ответ здесь очевиден – для удобства использования функций. Как мы только что видели, аргументы формальным параметрам можно не передавать, если нас устраивает поведение функции по умолчанию. В других, как полагается, редких ситуациях, всегда можно поменять значение такого параметра на другое и скорректировать работу функции.

Чтобы это было понятнее, приведу такой простой пример. Допустим, мы собираемся сравнивать строки в разных режимах: с учетом и без учета регистра, а также учитывать или не учитывать пробелы вначале и в конце. Для этого объявим следующую функцию:

def compare_str(s1, s2, reg=False, trim=True):
    if reg:
        s1 = s1.lower()
        s2 = s2.lower()
    if trim:
        s1 = s1.strip()
        s2 = s2.strip()
 
    return s1 == s2

Формальные параметры reg и trim определяют наиболее частый вариант использования операции сравнения строк: с учетом регистра и с удалением пробелов.

Теперь мы можем взывать эту функцию, просто с двумя аргументами:

print(compare_str("Python ", "  Python"))

или менять ее поведение, указывая другие значения формальных параметров:

print(compare_str("Python ", "  Python", trim=False))
print(compare_str("Python", "PYTHON", True, False))

В последнем варианте записаны обычные позиционные аргументы. В этом случае параметр reg примет значение True, а параметр trim – False. Конечно, всегда можно воспользоваться и именованными аргументами, здесь полная свобода выбора:

print(compare_str("Python", "PYTHON", reg=True, trim=False))

В заключение этого занятия хочу показать вам один нюанс при объявлении функции с формальными параметрами. Предположим, мы определяем вот такую очень простую функцию:

def add_value(value, lst=[]):
    lst.append(value)
    return lst

У нее один фактический и один формальный параметр, причем, второй параметр lst по умолчанию ссылается на изменяемый тип данных – список. Конечно, нам никто не запрещает этого делать, но давайте посмотрим, как она будет работать. Вызовем ее два раза:

l = add_value(1)
l = add_value(2)
print(l)

В консоли видим два значения в списке 1 и 2. Возможно, объявляя таким образом функцию, мы ожидали, что при каждом вызове параметр lst будет ссылаться на пустой список и функция будет каждый раз возвращать один элемент в этом списке. Но, получилось, что она сохраняет прежнее состояние списка при повторном вызове. Почему так произошло?

На самом деле, все просто. Когда мы объявляем функцию, то создается объект-функция и объекты для формальных параметров, в данном случае пустой список. Когда, затем, мы вызываем функцию, то (опуская некоторые детали) формальный параметр lst ссылается на этот список и добавление элемента происходит в него. При повторном вызове функции lst продолжает ссылаться на этот же список и в него добавляется следующее значение. Это все показывает, что при вызовах функции список не инициализируется повторно, а используется один и тот же объект.

Конечно, мы можем при вызовах функции каждый раз передавать пустой список:

l = add_value(1, [])
l = add_value(2, [])

И тогда формальный параметр lst будет при каждом вызове ссылаться уже на новый пустой список. А как сделать так, чтобы такое поведение было по умолчанию, чтобы нам явно не приходилось передавать пустой список? Исправить ситуацию можно, например, так:

def add_value(value, lst=None):
    if lst is None:
        lst = []
 
    lst.append(value)
    return lst

Значение формального параметра определим неизменяемым значением None, а в самой функции сделаем проверку, если этот параметр равен None, то есть, функция вызвана с одним первым аргументом, то создаем новый пустой список и в него помещаем значение. В этом случае, при каждом вызове функции:

l = add_value(1)
l = add_value(2)

будет автоматически создаваться новый список. То, что мы и хотели. А если хотим продолжить предыдущий, то достаточно его указать вторым аргументом:

l = add_value(2, l)

Вот такой нюанс существует при определении формальных параметров функции на изменяемые объекты, такие как списки, словари и множества.

Итак, из этого занятия вам нужно запомнить, что такое позиционные и именованные аргументы и как их можно записывать и комбинировать. Что такое фактические и формальные параметры, зачем нужны и как используются на практике, ну и, конечно же, как работают формальные параметры с изменяемыми типами данных. Закрепляйте материал практическими заданиями и переходите к следующему уроку.

Урок 39 · Часть I. Основы Python

Функции с произвольным числом параметров *args и **kwargs

Источник: python3-funkcii-s-proizvolnym-chislom-parametrov-args-i-kwargs

На этом занятии узнаем, как функциям можно передавать произвольное число аргументов. Где это используется, я думаю, вы понимаете? Например, известная нам функция

max(1, 2, 3, -4)

может принимать разное число аргументов и возвращает максимальное значение. Как можно самим определять такие функции? Делается это очень просто. Допустим, мы с вами хотим задать функцию для формирования маршрута к файлу:

И этот маршрут может состоять из нескольких частей. Причем, число фрагментов может быть произвольным. Опишем такую функцию. Я назову ее os_path(), а вместо списка параметров запишу звездочку и одну переменную args:

def os_path(*args):
    print(args)

Для начала, посмотрим, как это будет работать. Вызовем функцию с тремя строковыми аргументами:

os_path("F:\\~stepik.org", "Добрый, добрый Python (Питон)", "39\\p39. Функции.docx")

Не забываем здесь про экранирование обратных слешей. Выполним эту программу и в консоли видим, что переменная args ссылается на кортеж со значениями переданных трех аргументов. Здорово, да?! Чтобы функция принимала произвольное число аргументов, в ее объявлении достаточно у параметра прописать оператор *. Это оператор упаковки аргументов в кортеж и через переменную args мы сможем с ним работать.

Давайте теперь довершим нашу функцию и сформируем полный путь на основе его фрагментов. Сделать это можно с помощью знакомого нам метода join(), следующим образом:

def os_path(*args):
    path = "\\".join(args)
    return path

И, далее, вызвать эту функцию:

p = os_path("F:\\~stepik.org", "Добрый, добрый Python (Питон)", "39\\p39. Функции.docx")
print(p)

Надеюсь, из этого примера, вам понятно, как объявлять функцию с произвольным числом фактических параметров. Хорошо, а что если мы передадим этой функции дополнительно один именованный аргумент:

p = os_path("F:\\~stepik.org",
            "Добрый, добрый Python (Питон)",
            "39\\p39. Функции.docx",
            sep='/'
)

При запуске программы увидим ошибку, что функция не имеет такого формального параметра. Дело в том, что записывая объявление *args мы определяем лишь произвольное число фактических параметров, но не формальных. Как это можно поправить? Здесь есть, по крайней мере, два способа. В самом простом варианте, достаточно прописать этот формальный параметр в объявлении функции:

def os_path(*args, sep='\\'):
    path = sep.join(args)
    return path

И теперь никаких проблем с вызовом нет. Но, конечно, указать, какой-либо другой именованный аргумент мы не можем:

p = os_path("F:\\~stepik.org",
            "Добрый, добрый Python (Питон)",
            "39\\p39. Функции.docx",
            sep='/', trim=True
)

Снова получим ту же самую ошибку. Так как же определить в функции произвольное число формальных параметров? Делается это с помощью следующего синтаксиса:

def os_path(*args, **kwargs):
    print(kwargs)
    path = kwargs['sep'].join(args)
    return path

Мы прописываем уже две звездочки, а затем, имя переменной, которая будет ссылаться на упакованные значения в виде словаря. Убедимся в этом, выполним программу и смотрите, в консоли коллекция kwargs действительно представляет собой словарь, ключами которого являются имена аргументов, а значениями – значения аргументов. Все очень удобно и просто, как всегда в Python!

Причем, коллекция **kwargs обязательно должна быть записана после коллекции *args, наоборот нельзя, так как вначале должны идти фактические параметры и только потом – формальные. Мало того, мы можем некоторые параметры указывать явно, например:

def os_path(*args, sep='\\', **kwargs):
    path = sep.join(args)
    return path

И, тем самым, гарантировать их существование внутри функции. А другие, передаваемые именованные аргументы, следует проверять, прежде чем использовать, например, для параметра trim сначала делаем проверку его существования в словаре kwargs, а затем, смотрим, чему равно это значение:

def os_path(*args, sep='\\', **kwargs):
    if 'trim' in kwargs and kwargs['trim']:
        args = [x.strip() for x in args]
 
    path = sep.join(args)
    return path

Если условие выполняется, то удаляем пробелы до и после фрагментов путей к файлу.

То же самое и с фактическими параметрами. Некоторые из них можно явно указать, при объявлении функции:

def os_path(disk, *args, sep='\\', **kwargs):
    args = (disk,) + args
 
    if 'trim' in kwargs and kwargs['trim']:
        args = [x.strip() for x in args]
 
    path = sep.join(args)
    return path

И тогда на первый аргумент будет ссылаться параметр disk, а остальные позиционные аргументы упаковываться в коллекцию args:

p = os_path("F:", "~stepik.org",
            "Добрый, добрый Python (Питон)",
            "39\\p39. Функции.docx",
            sep='/', trim=True
)

Вот принцип, по которому объявляются функции с произвольным числом фактических и формальных параметров.

Вам осталось закрепить этот материал практическими заданиями и жду всех вас на следующем уроке.

Урок 40 · Часть I. Основы Python

Операторы * и ** для упаковки и распаковки коллекций

Источник: python3-operatory-i-dlya-upakovki-i-raspakovki-kollekciy

На этом занятии я хочу немного отступить от темы функций и рассказать об операторах * и **, которые мы затронули на предыдущем уроке.

Мы знаем, что они позволяют упаковывать аргументы в кортеж и словарь. Но их можно использовать не только в объявлении функций, но и при работе с разными коллекциями. Например, если взять кортеж из двух значений:

x, y = (1, 2)

то его можно распаковать в две переменные. Но, если мы пропишем там больше значений, например, четыре:

x, y = (1, 2, 3, 4)

то уже получим ошибку, так как элементов четыре, а переменных всего две. Но, используя оператор *, мы можем упаковать оставшиеся значения во вторую переменную:

x, *y = (1, 2, 3, 4)

или, в первую, без разницы:

*x, y = (1, 2, 3, 4)

То же самое можно проделывать и со списками:

x, *y = [1, "a", True, 4]

и строками:

*x, y, z = "Hello Python!"

И вообще с любыми итерируемыми объектами. То есть, оператор * упаковывает оставшиеся значения в список. Правда, мы не можем упаковывать уже упакованные данные, например, так:

*y = 1, 2, 3

произойдет ошибка, но вот так:

x, *y = 1, 2, 3

уже будет работать.

Этот же оператор может выполнять и обратную операцию – распаковывать коллекции в набор данных. Пусть у нас имеется список:

a = [1, 2, 3]

И на его основе мы хотим сформировать кортеж. Если просто записать переменную в круглых скобках:

(a,)

то увидим кортеж со списком внутри. Но, если прописать оператор * перед списком:

(*a,)

то произойдет распаковка его элементов и список превратится в кортеж. То же самое можно сделать и при вызове функций. Допустим, определим кортеж из двух значений:

d = -5, 5

и вызовем с этими значениями функцию:

range(d)

Возникнет ошибка, так как функция ожидает числа в качестве аргументов, а не коллекции. Но, мы можем распаковать кортеж d в два числа, поставив перед ним оператор *:

range(*d)

и теперь никаких ошибок нет. Давайте посмотрим, что вернет эта функция, преобразуем все к списку:

list(range(*d))

Да, получаем ожидаемые значения от -5 до 5. И, теперь, это же преобразование генератора range() в список мы можем сделать и так:

[*range(*d)]

Здорово, да?! Мы оператором * распаковали итерируемый объект и составили из его значений список.

Мало того, мы таким образом можем делать объединение разных коллекций в одну коллекцию, например, список:

[*range(*d), *(True, False), *a]

Как видите, оператор * - невероятно удобный инструмент. И те же самые действия можно делать и со словарем. Зададим, следующий словарь с расшифровкой оценок:

d = {0: "безнадежно", 1: "убого", 2: "неуд.", 3: "удовл.", 4: "хорошо", 5: "отлично"}

Распаковать его можно двумя способами. Если прописать один оператор *:

{*d}

То получим множество, состоящее из ключей этого словаря. Или, можно сформировать список из ключей:

[*d]

То есть, оператор * перебирает словарь как обычный итерируемый объект и по умолчанию, перебираются именно ключи. Если нам нужно перебрать значения, то следует вызвать дополнительно метод:

[*d.values()]

и получим список из значений. Соответственно, метод:

[*d.items()]

вернет кортежи из пары ключ-значение.

Если же требуется распаковать словарь как словарь, то перед ним следует прописать две звездочки:

{**d}

Теперь вместо множества мы получаем словарь. Где это нам может пригодиться? Например, для объединения нескольких словарей в один. Создадим еще один словарь:

d2 = {6: "превосходно", 7: "элитарно", 8: "божественно"}

И соединим их через распаковку данных:

{**d, **d2}

На выходе получаем новый словарь с объединенными данными. Такой прием часто используется на практике, когда нужно объединить сразу несколько словарей. А вот для упаковки оператор ** не используется, если прописать, что то вроде:

a, b, **c = d

то получим синтаксическую ошибку. Можно указывать только одну звездочку. Исключение только параметр **kwargs при определении функций.

Надеюсь, теперь вы знаете, как работают операторы * и ** для упаковки и распаковки коллекций. Закрепляйте все практическими заданиями и переходите к следующему уроку.

Практика 8 · Часть I. Основы Python

Функции

Задания для закрепления темы · решений нет

Цели обучения

  • Определять функции с понятными параметрами и возвращаемыми значениями
  • Использовать значения по умолчанию, именованные аргументы, *args и **kwargs
  • Распаковывать аргументы при вызове
  • Реализовать алгоритм Евклида для НОД / НОК

Задания

Задание 1. Среднее

Сложность: лёгкое

Реализуйте average(*nums: float) -> float. Если чисел нет, выбросьте ValueError.

Требования:

  • Используйте вариативные параметры в стиле *args
  • Верните среднее арифметическое

Пример:

average(1, 2, 3)  # 2.0

Задание 2. Степень со значением по умолчанию

Сложность: лёгкое

Реализуйте power(base, exp=2) -> float: верните base ** exp.

Требования:

  • Показатель по умолчанию — 2
  • Поддержите вызов по именам power(exp=3, base=2)

Пример:

power(5)         # 25
power(2, exp=10) # 1024

Задание 3. НОД и НОК по Евклиду

Сложность: среднее

Реализуйте:

  • gcd(a: int, b: int) -> int — алгоритм Евклида (итеративно или рекурсивно)
  • lcm(a: int, b: int) -> int — наименьшее общее кратное через |a*b| // gcd(a, b) (нули: lcm(0, x) == 0)

Требования:

  • Для отрицательных входов используйте абсолютные значения результата (НОД ≥ 0)
  • Не используйте math.gcd / math.lcm

Пример:

gcd(48, 18)   # 6
lcm(4, 6)     # 12

Задание 4. Сборка URL

Сложность: среднее

Реализуйте build_url(base: str, *path_parts: str, **query) -> str:

  • Объедините base и части пути через / (без дублирующих слэшей в местах стыка)
  • Если query непустой, добавьте ?key=value&key2=value2 (порядок вставки kwargs)
  • Преобразуйте значения через str

Требования:

  • Смешайте позиционные *path_parts и именованные **query
  • urllib не требуется

Пример:

build_url("https://api.test", "v1", "users", page=2, limit=10)
# "https://api.test/v1/users?page=2&limit=10"

Задание 5. Вызов с распаковкой

Сложность: среднее

Реализуйте call_with(pairs: list[tuple], fn) -> list: для каждой пары (args_tuple, kwargs_dict) в pairs добавьте в результат fn(*args_tuple, **kwargs_dict).

Требования:

  • Используйте распаковку * / ** в месте вызова
  • Пустой pairs → []

Пример:

def add(a, b, offset=0):
    return a + b + offset

call_with([((1, 2), {}), ((3, 4), {"offset": 10})], add)
# [3, 17]

Задание 6. Слияние конфигурации

Сложность: сложное

Реализуйте merge_config(*layers: dict, **overrides) -> dict:

  • Начните с {}
  • Обновляйте по порядку каждым dict из layers
  • В конце обновите через overrides
  • Вложенные dict: только поверхностное слияние (поздний ключ заменяет значение целиком)

Требования:

  • Не мутируйте входные словари
  • Верните объединённый dict

Пример:

merge_config({"a": 1, "b": 2}, {"b": 3}, c=4)
# {"a": 1, "b": 3, "c": 4}

Глава 9

Рекурсия, lambda и области видимости

Урок 41 · Часть I. Основы Python

Рекурсивные функции

Источник: python3-rekursivnye-funkcii

На этом занятии речь пойдет о рекурсивных функциях. То есть, о функциях, которые вызывают сами себя.

На первый взгляд может показаться невероятным, что функция может вызывать саму себя. Но это так. И, кстати, так можно делать во всех современных языках программирования, а не только в Python. Поэтому, изучая рекурсивные функции, вы, фактически, знакомитесь с фундаментальным материалом, который применим и в других языках программирования.

Чтобы все было предельно понятно, я вначале приведу фрагмент программы с набором из трех разных функций, которые вызываются друг из друга, а затем мы их заменим на одну рекурсивную функцию. Функции будут очень простыми:

def rcs3(x):
    print(f"down: x = {x}")
    print(f"up: x = {x}")
 
 
def rcs2(x):
    print(f"down: x = {x}")
    rcs3(x-1)
    print(f"up: x = {x}")
 
 
def rcs1(x):
    print(f"down: x = {x}")
    rcs2(x-1)
    print(f"up: x = {x}")

После этого вызовем функцию rcs1 с аргументом x=3:

rcs1(3)

В результате на экране увидим строчки:

down: x = 3
down: x = 2
down: x = 1
up: x = 1
up: x = 2
up: x = 3

Я думаю, вы без особого труда поймете, как работает эта простая программа. Вначале вызывается первая функция rcs1 с параметром x=3. В ней выполняется первая команда print с выводом первой строчки на экран. Затем управление передается следующей функции rcs2, но с параметром x=2. Она, в свою очередь, отображает следующую строчку и вызывает еще одну функцию rcs3 с параметром x=1. Эта последняя функция печатает две строчки:

down: x = 1
up: x = 1

Что происходит дальше? А дальше управление передается предыдущей функции rcs2, из которой была вызвана функция rcs3. При этом функция rcs2 продолжает свою работу, отрабатывает функция print с выводом строки:

up: x = 2

После этого она завершается и управление передается функции rcs1, которая так же продолжает выполнять команды. Отрабатывает print с выводом строки:

up: x = 3

Иллюстрация к уроку

На этом блок из последовательного вызова функций завершает свою работу.

Все это вы уже должны хорошо знать и понимать. А вот следующий шаг будет новым. Мы заменим все эти три функции одной рекурсивной, которая будет выглядеть следующим образом:

def rcs(x):
    print(f"down: x = {x}")
    if x > 1:
        rcs(x-1)
    print(f"up: x = {x}")

Давайте ее вызовем с начальным значением x=3 и посмотрим, что получится:

rcs(3)

После запуска программы в консоли появятся те же самые строчки:

down: x = 3
down: x = 2
down: x = 1
up: x = 1
up: x = 2
up: x = 3

Почему получился такой результат и как это работает? На самом деле все предельно просто. Вся эта магия получается благодаря тому, что интерпретатор языка Python запоминает порядок вызова функций, то есть, какая функция из какой и с какими аргументами была вызвана. Поэтому работу нашей рекурсивной функции можно представить в виде следующих последовательных вложенных вызовов:

Иллюстрация к уроку

Все начинается с первого вызова функции rcs с аргументом x=3. В теле этой функции срабатывает print с выводом в консоль первой строчки:

down: x = 3

Затем проверяется условие, что x должен быть меньше 1. Так как x=3, то условие срабатывает и снова вызывается функция rcs, но уже с аргументом x=2. Вот этот момент самый главный. Когда функция вызывает какую-либо другую функцию (в том числе и саму себя), то вызов первой функции не завершается, она продолжает работать, но появляется еще один вызов точно такой же функции, только с аргументом x=2. Для Python – это независимо работающие функции. Параметр x второй функции rcs никак не связан с параметром x первой функции rcs. Это как бы независимые копии одной и той же функции. Это ключевой момент в понимании работы рекурсивных функций: первая функция не завершается, и последующие вызовы этой же функции работают совершенно независимо друг от друга, так, словно это разные функции.

Итак, мы вызвали (рекурсивно) функцию rcs с аргументом x=2. В ней снова отрабатывает print с выводом строки:

down: x = 2

и проверяется условие, что x должен быть меньше 1. Условие истинно, поэтому еще раз вызывается рекурсивно функция rcs, но с аргументом x=1. Опять отрабатывает print с выводом строки:

down: x = 1

А вот условие теперь оказывается ложным, т.к. один не меньше одного. В результате очередного рекурсивного вызова функции rcs не происходит. Выполнение переходит к следующей функции print с выводом строки:

up: x = 1

На этом работа функции rcs(1) завершается и управление передается предыдущей функции rcs(2). Но в этой функции первые две строчки уже были выполнены, поэтому выполняется следующая с вызовом функции print, которая выводит на экран строчку:

up: x = 2

На этом функция rcs(2) также завершает свою работу. Управление переходит к первой функции rcs(1) и здесь выводится строчка:

up: x = 3

Вот общий принцип работы рекурсивных функций. Как видите, все предельно просто. При этом, когда движение идет вглубь, то имеем прямой ход рекурсии, а при возврате – обратный ход. Максимальное число вызовов рекурсивной функции называют глубиной рекурсии.

А что будет, если глубину ничем не ограничивать? Функция будет вызываться до бесконечности? Давайте проверим. Изменим рекурсивную функцию:

def rcs(x):
    print(f"down: x = {x}")
    rcs(x + 1)

И вызовем ее с начальным значением x=1:

rcs(1)

Смотрите, функция была вызвана 997 раз, после чего возникла ошибка RecursionError – достигнута максимальная глубина рекурсии. То есть, максимальная глубина последовательного вызова функций ограничена. В действительности это ограничение есть во всех ЯП и бесконечно вызывать функции друг из друга не допустимо. Поэтому при описании рекурсивной функции нужно гарантировать ограничение ее глубины вызовов. На практике считается нормальной глубина в 10-20 последовательных вызовов. Максимум следует делать не более 100 вызовов. Если же алгоритм предполагает большие значения глубины рекурсии, то такую программу следует пересмотреть и реализовать другим алгоритмом.

Примеры использования рекурсивных функций

Надеюсь, общий принцип работы рекурсивных функций вам понятен. И, возможно, остается один важный вопрос, зачем они нужны и где имеет смысл их применять? Давайте для этого рассмотрим задачу близкую к реальной. Предположим, у нас есть некоторое игровое поле pole размером 5х5 клеток и в каждой клетке проставлен либо символ ‘#’, либо символ ‘*’. Наша задача заменить связанную область из звездочек символами ‘@’:

Иллюстрация к уроку

Эту задачу достаточно просто можно реализовать с помощью рекурсивной функции, например, так:

def set_zeros(p, i, j, sz):
    if p[i][j] != '*':
        return
 
    p[i][j] = '@'
 
    if i-1 >= 0 and p[i-1][j] == '*':
        set_zeros(p, i-1, j, sz)
    if i+1 < sz and p[i+1][j] == '*':
        set_zeros(p, i+1, j, sz)
    if j-1 >= 0 and p[i][j-1] == '*':
        set_zeros(p, i, j-1, sz)
    if j+1 < sz and p[i][j+1] == '*':
        set_zeros(p, i, j+1, sz)
 
 
pole = [
    ['#', '*', '*', '*', '#'],
    ['#', '#', '#', '#', '#'],
    ['*', '*', '*', '*', '#'],
    ['#', '#', '*', '*', '*'],
    ['#', '#', '*', '#', '#'],
]
 
N = len(pole)
set_zeros(pole, 2, 2, N)
 
print(*pole, sep='\n')

Здесь рекурсивная функция set_zeros() заменяет символы ‘’ связанной области на символы ‘@’. Работает она очень просто. Вначале мы передаем ей двумерный список pole и индексы начальной клетки. Если текущая клетка списка содержит ‘’, то она заменяется на символ ‘@’ и запускается рекурсия во все соседние клетки:

Иллюстрация к уроку

Если в соседних клетках также будет символ ‘*’, то они заменятся на символ ‘@’, и рекурсия продолжится дальше. И так, пока вся группа связанных клеток из звездочек не будет заменена символами ‘@’.

После запуска программы увидим следующий результат:

[‘#’, ‘’, ‘’, ‘*’, ‘#’]
[‘#’, ‘#’, ‘#’, ‘#’, ‘#’]
[‘@’, ‘@’, ‘@’, ‘@’, ‘#’]
[‘#’, ‘#’, ‘@’, ‘@’, ‘@’]
[‘#’, ‘#’, ‘@’, ‘#’, ‘#’]

Как видите, все связанные клетки с центральной клеткой (2, 2) были заменены на символ ‘@’.

Вообще рекурсивные функции очень удобны, когда нам нужно перебирать некие иерархические данные, которые имеют сложную структуру, и обычными циклами их проходить было бы затруднительно. В частности, рекурсия используется для переборов вершин бинарных деревьев – довольно распространенной структуры данных следующего вида:

Иллюстрация к уроку

Или для перебора каталогов и файлов:

Иллюстрация к уроку

И так далее. Везде, где присутствует иерархичность можно подумать об использовании рекурсивных функций. Но нужно всегда помнить и об их недостатках. Они следующие:

  • рекурсивные вызовы работаю медленнее, чем итерации операторов циклов, поэтому, если задачу относительно просто можно реализовать через циклы, то именно их и следует применять;
  • рекурсия не может идти до бесконечности; программа аварийно завершится, когда стек вызова будет полностью заполнен, поэтому если в задаче сложно оценить максимальную глубину рекурсии, то от использования рекурсивных функций лучше отказаться.

Урок 42 · Часть I. Основы Python

Анонимные (lambda) функции

Источник: python3-anonimnye-lambda-funkcii

Это занятие будет посвящено, так называемым, анонимным или, их еще называют, lambda функциям. Что это за функции и почему их называют анонимными? Сейчас вы все узнаете!

Лямбда функция определяется по очень простому синтаксису:

lambda param_1, param_2, …: команда

и записывается в программе, как оператор. Например, вот так можно определить лямбда-функцию для сложения двух значений:

lambda a, b: a + b

У нее два параметра a и b, а затем, через двоеточие написано, что с ними нужно сделать. Полученное значение будет автоматически возвращено этой функцией. И, обратите внимание, у этой функции нет имени, поэтому она и называется анонимной. Но как тогда ее вызывать? Для этого объект-функцию, который создает лямбда-функция, нужно присвоить какой-либо переменной:

s = lambda a, b: a + b

И уже через нее вызывать саму функцию:

s(1, 2)

В чем особенность такого определения функции? Зачем ее придумали и почему бы не пользоваться обычными функциями? У нее есть одно принципиальное отличие от ранее рассматриваемых нами функций – она может быть записана как элемент любой конструкции языка Python. Например, прямо как элемент списка:

a = [4, 5, lambda: print("lambda"), 7, 8]

Мы здесь описываем лямбда-функцию и сразу же передаем ее в список. С обычными функциями так не получится. Они должны быть объявлены заранее и только потом мы могли бы передать ссылку на нее в список. Если мы сейчас обратимся к третьему элементу этого списка:

a[2]

то увидим ссылку на объект-функцию. И, как мы уже знаем, чтобы ее запустить на выполнение нужно прописать оператор – круглые скобки:

a[2]()

И, действительно, функция была выполнена и в консоли отобразилось сообщение.

Конечно, анонимные функции, обычно, не используются для вывода какой-либо информации. Как правило, они выполняют определенную команду и возвращают полученный результат. Для ясности, приведу такой пример. Предположим, у нас имеется список:

lst = [5, 3, 0, -6, 8, 10, 1]

и мы хотим написать функцию, которая бы выбирала значения из этого списка по определенному критерию (фильтру):

def get_filter(a, filter=None):
    if filter is None:
        return a
 
    res = []
    for x in a:
        if filter(x):
            res.append(x)
 
    return res

Здесь второй параметр filter – это ссылка на другую функцию, которая будет отбирать значения из списка lst. Если вызвать ее только с первым аргументом:

lst = [5, 3, 0, -6, 8, 10, 1]
r = get_filter(lst)
print(r)

То увидим в консоли тот же самый список без изменений. Но, если вторым аргументом передать вот такую лямбда-функцию:

r = get_filter(lst, lambda p: p % 2 == 0)

то возвратится новый список, состоящий только из четных значений. Как это произошло? В этом примере второй параметр filter функции get_filter стал ссылаться на лямбда-функцию. Эта функция возвращает True для четных значений и False – для нечетных. Соответственно, в цикле при переборе элементов списка, условие будет срабатывать только для четных значений и только они будут добавляться в список res. Видите, как удобно и наглядно можно использовать лямбда-функции в программировании? Если бы их не существовало, нам бы пришлось объявлять отдельную функцию:

def even(p):
    return p % 2 == 0

А, затем, передавать ссылку на нее:

r = get_filter(lst, even)

Согласитесь, это несколько более трудоемкий и менее удобный вариант? Мало того, если нам понадобится быстро изменить фильтр, то достаточно поправить реализацию анонимной функции, например, для выделения только положительных чисел:

r = get_filter(lst, lambda p: p > 0)

Быстро и просто! В этом одно из удобств этих анонимных функций – их можно сразу прописать в нужном месте программы.

Однако, у таких функций есть одно существенное ограничение – в них можно прописать только одну конструкцию языка Python, то есть, выполнить только одну какую-либо команду. Также нельзя объявлять анонимные функции в несколько строк:

lambda a: 
    print(a)

вызовет синтаксическую ошибку. Наконец, в лямбда-функциях нельзя использовать оператор присваивания:

lambda a: a = 1

Это также вызовет синтаксическую ошибку. Здесь мы можем лишь создавать новый объект на основе входных параметров (или глобальных, общих переменных программы):

s = lambda a: a + 1
s(1)
p = lambda: "hello python"
p()

либо просто возвращать ссылки на уже существующие объекты:

lambda a: a

На этом мы завершим текущее занятие. Для закрепления материала пройдите практические задания и переходите к следующему уроку.

Урок 43 · Часть I. Основы Python

Области видимости переменных. Ключевые слова global и nonlocal

Источник: python3-oblasti-vidimosti-peremennyh-klyuchevye-slova-global-i-nonlocal

На этом занятии мы поговорим о работе с глобальными и локальными данными, то есть, фактически, об области видимости переменных.

Когда мы начинаем писать какую-либо программу и сохраняем ее в файле, например, с названием:

myprog.py

то в Python автоматически создается пространство имен с названием myprog (слайд). Изначально оно пустое, но если там задать какие-либо переменные:

N = 100
WIDTH, HEIGHT = 1000, 500

то в этом пространстве появятся эти имена (ссылки). Так вот, все переменные, которые находятся непосредственно в этом пространстве имен, являются глобальными в пределах текущего программного модуля. То есть, они доступны в любом месте данной программы, после их объявления.

Добавим в эту программу еще и функцию, пусть она будет такой:

def my_func(lst):
    for x in lst:
        n = x + 1
        print(n)

Иллюстрация к уроку

В этом случае в пространстве имен появится переменная my_func – ссылка на объект-функцию, причем эта функция образует свое, локальное пространство имен с названием my_func. И внутри этого локального пространства автоматически появляются переменные lst, x и n. Обратите внимание, цикл for не образовывает своего локального пространства, только функция и все переменные внутри цикла находятся в области видимости функции.

Как вы уже догадались, переменные внутри локальной области видимости, называются локальными и доступны только в ее пределах. Например, вне функции мы не можем обращаться к локальным переменным lst, x и n. Строчка кода:

print(x)

приведет к ошибке – x не определена. А вот внутри функции все три переменные существуют:

print(lst, n, x)

Если теперь вызвать функцию:

my_func([1, 2, 3])

то мы увидим значения этих локальных переменных. Также внутри функции доступны все переменные из внешней области видимости, в данном случае, глобальной. Если записать:

print(N, WIDTH)

то значения этих переменных будут отображены.

А что будет, если мы внутри функции определим локальную переменную N, то есть, с тем же именем, что и глобальная переменная? Давайте попробуем:

def my_func(lst):
    N = 10
    …

В этом случае будет использоваться именно локальная переменная N, созданная в области видимости функции. То есть, алгоритм поиска переменных здесь такой. Сначала идет обращение к локальной области видимости и если переменная с нужным именем находится, то она и используется. Если же требуемая переменная не существует в локальной области, то поиск переходит на следующий уровень к внешней области и продолжается там. Поэтому, при отсутствии локальной переменной N внутри функции, берется глобальная переменная N из внешней области видимости. При этом, значение глобальной переменной никак не меняется, так как мы ее не используем:

my_func([1, 2, 3])
print(N)

Хорошо, а как нам тогда изменять значения глобальных переменных внутри функции, если попытка присвоить ей какое-либо значение приводит к созданию аналогичной локальной переменной? Для этого в программе нужно явно указать, что мы хотим работать именно с глобальной переменной. Это делается с помощью ключевого слова global, за которым перечисляются имена глобальных переменных, например, так:

def my_func(lst):
    global N
    …

Теперь имя N – это имя глобальной переменной и ее изменение внутри функции приведет к изменению и глобального значения.

Однако, здесь следует быть аккуратным, если в функции уже была создана локальная переменная N, то конструкция global приведет к ошибке:

    N = 5
    global N

Так можно делать только в отсутствии соответствующих локальных переменных.

Интересно, что если сейчас глобальную переменную N поставить в комментарий:

# N = 100

то есть, она не будет существовать изначально в программе, то после выполнения функции с конструкцией global N, эта глобальная переменная будет создана.

В Python имеется еще один интересный режим работы с локальными переменными с использованием ключевого слова nonlocal. Давайте предположим, что у нас имеется объявление одной функции внутри другой (так тоже можно делать):

x = 0
def outer():
    x = 1
    def inner():
        x = 2
        print("inner:", x)
 
    inner()
    print("outer:", x)
 
outer()
print("global:", x)

При запуске программы мы увидим ожидаемые результаты, так как берутся локальные переменные внутри каждой функции:

inner: 2
outer: 1
global: 0

А теперь представим, что внутри функции inner мы хотели бы работать с переменной x, объявленной уровнем выше, то есть, в функции outer. Для этого в локальной области этой функции следует прописать ключевое слово nonlocal и указать переменную, которую следует взять из внешней области видимости:

nonlocal x

Иллюстрация к уроку

Теперь строка x = 2 будет означать изменение переменной x в функции outer и при запуске программы получим результаты:

inner: 2
outer: 2
global: 0

Но так можно делать только с локальными переменными. С глобальной работать не будет. Если мы пропишем строчку

nonlocal x

в функции outer, то возникнет ошибка, т.к. уровнем выше находится уже глобальная область. Здесь, вместо nonlocal следует уже использовать global:

global x

а nonlocal в inner убрать, иначе опять же получится ссылка на глобальную переменную.

Теперь вы знаете, что такое глобальные и локальные переменные, как к ним обращаться и как использовать ключевые слова global и nonlocal. Для закрепления материала вас ждут практические задания, а я ухожу в следующий урок.

Урок 44 · Часть I. Основы Python

Замыкания в Python

Источник: python3-zamykaniya-v-python

На этом занятии затронем новую тему – замыкания. Это один из любимых вопросов на собеседовании в области программирования – рассказать, что такое замыкания. И сейчас вы узнаете подробный ответ на него.

Как мы с вами видели на предыдущем занятии, функции можно объявлять внутри других функций. Например, так:

def say_name(name):
    def say_goodbye():
        print("Don't say me goodbye, " + name + "!")
 
    say_goodbye()

А, затем вызвать:

say_name("Sergey")

Мы здесь сначала вызываем внешнюю функцию, затем, в ней формируется вложенная функция say_goodbye() и вызывается. В результате, в консоли видим сообщение «Don’t say me goodbye, Sergey!».

Я, думаю, здесь вам все должно быть понятно. А теперь сделаем, следующее. Вместо вызова внутренней функции возвратим ссылку на нее с помощью оператора return:

def say_name(name):
    def say_goodbye():
        print("Don't say me goodbye, " + name + "!")
 
    return say_goodbye

Конечно, после запуска программы мы не увидим никакого сообщения, так как внутренняя функция нигде не вызывается. Исправим это. Сохраним ссылку на функцию say_goodbye() в переменной f:

f = say_name("Sergey")

А, затем, вызовем ее:

f()

Иллюстрация к уроку

Мы снова видим то же самое сообщение. Вам не кажется здесь ничего странным? Например, откуда функция say_goodbye() берет значение переменной name? Ведь внешняя функция say_name() выполнилась и завершилась, а значит, все ее локальные переменные вроде как тоже должны были бы исчезнуть? Но нет, мы обращаемся к переменной name и успешно получаем ее значение! Почему? Давайте разберемся.

Дело в том, что когда у нас имеется глобальная ссылка f на внутреннее, локальное окружение функции say_goodbye(), то это окружение продолжает существовать, оно не удаляется автоматически сборщиком мусора, именно из-за этой глобальной ссылки на него. А вместе с ним, продолжают существовать и все внешние локальные окружения, в данном случае – окружение функции say_name(), потому что также существует неявная, скрытая ссылка на него из внутреннего окружения. Такие ссылки формируются автоматически и позволяют, в частности, обращаться к переменным, объявленным в этих внешних окружениях. Именно поэтому функция print() в say_goodbye() имеет доступ к переменной name и эта переменная продолжает существовать, пока существует окружение say_goodbye, а значит и окружение say_name.

Вот такой эффект, когда мы «держим» внутреннее локальное окружение и имеем возможность продолжать использовать переменные из внешних окружений, в программировании называется замыканием. Замыкание в том смысле, что мы держим внутреннее окружение say_goodbye переменной f из глобального окружения. Получается цепочка ссылок, замыкающаяся на глобальном окружении. Мало того, при каждом новом вызове внешней функции, формируется свое новое, независимое локальное окружение, со своими локальными переменными и соответствующими значениями:

f = say_name("Sergey")
f2 = say_name("Python")
f()
f2()

Иллюстрация к уроку

Где может пригодиться такой функционал? Например, можно создать функцию-счетчик, которая бы увеличивала значение локальной переменной на единицу при каждом запуске:

def counter(start=0):
    def step():
        nonlocal start
        start += 1
        return start
 
    return step

Обратите внимание, мы здесь используем ключевое слово nonlocal, чтобы переменная start изменялась во внешней локальной области, а не создавалась бы в текущей, локальной. Без этой строчки возникнет ошибка, из-за неопределенности: мы берем текущее значение start извне, а потом создавали бы переменную с тем же именем внутри области step. Так делать нельзя. И строчка nonlocal start четко указывает брать переменную start из внешней локальной области, а не создавать в текущей.

Теперь можно сформировать несколько таких независимых счетчиков и выполнить их:

c1 = counter(10)
c2 = counter()
print(c1(), c2())
print(c1(), c2())
print(c1(), c2())

У нас, действительно, оба счетчика отработают независимо друг от друга.

И приведу еще один пример с замыканиями. Предположим, мы хотим сделать функцию, которая бы удаляла ненужные символы в начале и конце строки. Через замыкание это можно реализовать, следующим образом:

def strip_string(strip_chars=" "):
    def do_strip(string):
        return string.strip(strip_chars)
 
    return do_strip

Обратите внимание, вложенная функция тоже имеет параметр – строку, у которой будут удаляться ненужные символы. Далее, создадим два объекта с разным списком удаляемых символов:

strip1 = strip_string()
strip2 = strip_string(" !?,.;")

И вызовем вложенную функцию с одним аргументом:

print(strip1(" hello python!.. "))
print(strip2(" hello python!.. "))

Смотрите, первая функция strip1 убрала только пробелы, а вторая еще и восклицательный знак с точками. Таким образом, мы можем многократно использовать в программе функции strip1 и strip2, передавая им разные строки.

Вот, что из себя представляют замыкания и вот так они работают. Для закрепления этого материала пройдите практические задания, а затем, на покорение нового материала – к новым урокам!

Практика 9 · Часть I. Основы Python

Рекурсия, lambda и области видимости

Задания для закрепления темы · решений нет

Цели обучения

  • Писать рекурсивные функции с понятными базовыми случаями
  • Использовать lambda для коротких колбэков
  • Понимать global / nonlocal и строить простые замыкания

Задания

Задание 1. Факториал

Сложность: лёгкое

Реализуйте factorial(n: int) -> int рекурсивно. При n < 0 → ValueError. 0! = 1.

Требования:

  • Обязательна рекурсия (без циклов)
  • Возвращать int

Пример:

factorial(5)  # 120

Задание 2. Сумма цифр

Сложность: лёгкое

Реализуйте sum_digits(n: int) -> int рекурсивно для неотрицательного n.

Требования:

  • Базовый случай при n < 10
  • Использовать n % 10 и n // 10

Пример:

sum_digits(1234)  # 10

Задание 3. Ключ сортировки через lambda

Сложность: среднее

Реализуйте sort_by_last_char(words: list[str]) -> list[str]: вернуть новый список, отсортированный по последнему символу, затем по самому слову. Используйте sorted(..., key=lambda ...).

Требования:

  • Lambda для key
  • Исходный список не менять

Сортировать в первую очередь по последнему символу по возрастанию, во вторую — по полной строке по возрастанию.

Пример:

sort_by_last_char(["apple", "pea", "grape", "banana"])
# ["banana", "pea", "apple", "grape"]

Задание 4. Замыкание-счётчик

Сложность: среднее

Реализуйте make_counter(start: int = 0), возвращающую функцию counter(step: int = 1) -> int. Каждый вызов увеличивает внутреннее значение на step и возвращает новое значение. Используйте nonlocal.

Требования:

  • Замыкание над изменяемой переменной-счётчиком
  • Независимые счётчики от разных вызовов make_counter

Пример:

c = make_counter(10)
c()     # 11
c(2)    # 13

Задание 5. Разворачивание вложенных списков

Сложность: среднее

Реализуйте deep_flatten(xs: list) -> list рекурсивно: развернуть произвольно вложенные списки до «листьев», которые сами не являются списками.

Требования:

  • Рекурсия; определять списки через isinstance(x, list)
  • Сохранять порядок слева направо

Пример:

deep_flatten([1, [2, [3, 4], 5], 6])  # [1, 2, 3, 4, 5, 6]

Задание 6. Фабрика скользящего среднего

Сложность: сложное

Реализуйте make_running_avg(), возвращающую функцию add(x: float) -> float, которая принимает новый образец и возвращает среднее всех образцов на данный момент. Используйте замыкание (nonlocal для count/sum или один список).

Требования:

  • Первый вызов: среднее равно x
  • Без глобальных переменных
  • Разные фабрики независимы

Пример:

avg = make_running_avg()
avg(10)  # 10.0
avg(20)  # 15.0
avg(30)  # 20.0

Глава 10

Декораторы

Урок 45 · Часть I. Основы Python

Введение в декораторы функций

Источник: python3-vvedenie-v-dekoratory-funkciy

Собственно, последняя тема, которую я хочу затронуть – это декораторы функций. Чтобы понять их суть, вы должны хорошо знать про замыкания и вложенные функции (на всякий случай, ссылки на эти занятия будут под этим видео).

Давайте, я сразу приведу пример, из которого и сформулирую понятие декоратора? Используя вложенную функцию wrapper и механизм замыканий, будем вызывать переданную функцию func внутри вложенной функции wrapper:

def func_decorator(func):
    def wrapper():
        print("------ что-то делаем перед вызовом функции ------")
        func()
        print("------ что-то делаем после вызова функции ------")
 
    return wrapper

Далее, для примера, объявим некоторую функцию:

def some_func():
    print("Вызов функции some_func")

И передадим ссылку на нее функции func_decorator:

f = func_decorator(some_func)

Иллюстрация к уроку

В результате, переменная f будет ссылаться на вложенную функцию wrapper и при ее вызове:

f()

соответственно запустится wrapper(), а она, в свою очередь, запустит переданную функцию func(), то есть, some_func().

То есть, декоратор – это функция, которая принимает ссылку на другую функцию и расширяет ее функциональность за счет вложенной функции.

Часто, чтобы не создавать новые имена функций, вместо имени f используют то же самое имя функции:

some_func = func_decorator(some_func)
some_func()

И у нас получается, словно, мы модифицировали существующую функцию. В этом и заключается смысл декоратора – наполнить уже существующую функцию дополнительным функционалом.

Однако, если сейчас в нашу функцию some_func() добавить хотя бы один параметр:

def some_func(title):
    print(f"title = {title}")

А, затем, вызвать ее с одним аргументом:

some_func = func_decorator(some_func)
some_func("Python навсегда!")

то увидим ошибку, так как внутренняя функция wrapper() прописана без параметров. А именно на нее и ссылается сейчас some_func. В самом простом варианте, мы, конечно, может просто добавить этот параметр для wrapper():

def func_decorator(func):
    def wrapper(title):
        print("------ что-то делаем перед вызовом функции ------")
        func(title)
        print("------ что-то делаем после вызова функции ------")
 
    return wrapper

И теперь программа будет запускаться без ошибок. Но, очевидно, она перестанет работать, если число параметров функции func() изменится. Как описать универсальную реализацию декоратора для функций с разным числом фактических и формальных параметров? Конечно, для этого нужно определить вложенную функцию, принимающую произвольное число аргументов, следующим образом:

def func_decorator(func):
    def wrapper(*args, **kwargs):
        print("------ что-то делаем перед вызовом функции ------")
        func(*args, **kwargs)
        print("------ что-то делаем после вызова функции ------")
 
    return wrapper

А, затем, переданные значения распаковываются и передаются функции func(). Получаем универсальную реализацию декоратора. И, действительно, если теперь добавить еще один параметр в функцию some_func:

def some_func(title, tag):
    print(f"title = {title}, tag = {tag}")

То нам достаточно будет при вызове декоратора передать эти два аргумента:

some_func("Python навсегда!", 'h1')

Сам декоратор остается без изменений.

И, наконец, последний штрих. Сама по себе функция some_func() может возвращать какие-либо значения, например, помимо вывода сообщения в консоль, она еще будет возвращать сформированную строку:

def some_func(title, tag):
    print(f"title = {title}, tag = {tag}")
    return f"<{tag}>{title}</{tag}>"

Но, при попытке получить сейчас это значение:

some_func = func_decorator(some_func)
res = some_func("Python навсегда!", 'h1')
print(res)

Увидим None. И я, думаю, вы прекрасно понимаете почему? Да, это потому, что вложенная функция wrapper() ничего не возвращает. Исправим это и сделаем так, чтобы она возвращала значение функции func():

def func_decorator(func):
    def wrapper(*args, **kwargs):
        print("------ что-то делаем перед вызовом функции ------")
        res = func(*args, **kwargs)
        print("------ что-то делаем после вызова функции ------")
        return res
 
    return wrapper

Вот теперь получили окончательную версию универсального декоратора функции и при выполнении программу видим не только его работу, но и возвращенное функцией значение.

Возможно, на протяжении всего этого урока вы задаете себе вопрос – зачем это надо? Где применяется? Приведу такой пример. Предположим, мы хотим протестировать различные функции на скорость их работы. Для этого возьмем функцию, которая реализует медленный алгоритм Евклида для поиска НОД (наибольшего общего делителя) двух натуральных чисел a и b (мы ее с вами делали на одном из прошлых занятий):

def get_nod(a, b):
    while a != b:
        if a > b:
            a -= b
        else:
            b -= a
    return a

И перед ней опишем декоратор-тестировщик:

def test_time(fn):
    def wrapper(*args, **kwargs):
        st = time.time()
        res = fn(*args, **kwargs)
        dt = time.time() - st
        print(f"Время работы: {dt} сек")
        return res
 
    return wrapper

Мы здесь замеряем время работы функции и выводим его в консоль. Чтобы воспользоваться функцией time, импортируем этот модуль:

import time

и декорируем функцию get_nod():

get_nod = test_time(get_nod)
res = get_nod(2, 1000000)
print(res)

После запуска программы видим время ее выполнения и возвращенный результат.

Мало того, если у нас будет еще какая-либо функция, например, тот же алгоритм Евклида, но с быстрой реализацией:

def get_fast_nod(a, b):
    if a < b:
        a, b = b, a
    while b:
        a, b = b, a % b
 
    return a

То мы легко можем применить тот же самый декоратор для тестирования скорости работы этой второй функции:

get_nod = test_time(get_nod)
get_fast_nod = test_time(get_fast_nod)
res = get_nod(2, 1000000)
res2 = get_fast_nod(2, 1000000)
print(res, res2)

Получается, что мы через декоратор test_time определили универсальный алгоритм для тестирования скорости работы любых функций. И это очень удобно!

И, наконец, последнее, о чем я хочу рассказать на этом занятии. Декораторы можно навешивать (применять) к функциям с помощью специального значка @. То есть, вместо строчек:

get_nod = test_time(get_nod)
get_fast_nod = test_time(get_fast_nod)

достаточно перед объявлением функций прописать @test_time. В результате, эти функции, как бы, «обертываются» нашим декоратором test_time и расширяются его функционалом. Если мы теперь запустим программу, то увидим тот же самый результат. А вот если у какой-либо функции уберем эту строчку, то будет обычный вызов без оценки скорости работы. Фактически, запись:

@test_time
def get_nod(a, b):
    ...

эквивалентна строчке:

get_nod = test_time(get_nod)

но со значком «собачка» программа выглядит, на мой взгляд, понятнее, да и записывать это декорирование проще. На практике, как правило, используют именно этот второй вариант.

На этом мы завершим наше первое знакомство с декораторами функций. Надеюсь, вы поняли, как они работают и для чего применяются? Отнеситесь серьезно к этому материалу, так как декораторы в Python используются довольно часто и важно правильно понимать принцип их работы.

Урок 46 · Часть I. Основы Python

Декораторы с параметрами. Сохранение свойств декорируемых функций

Источник: python3-dekoratory-s-parametrami-sohranenie-svoystv-dekoriruemyh-funkciy

На предыдущем занятии, мы познакомились с декораторами и рассмотрели некоторые примеры их работы. Здесь немного углубимся в эту тему и начнем с декораторов, которым можно дополнительно передавать аргументы.

Предположим, что мы создаем декоратор для вычисления производной функции. Используя уже имеющиеся знания, это можно сделать, следующим образом:

def func_decorator(func):
    def wrapper(x, *args, **kwargs):
        dx = 0.0001
        res = (func(x + dx, *args, **kwargs) - func(x, *args, **kwargs)) / dx
        return res
 
    return wrapper

И к функции, например, sin(x) применить этот декоратор (не забываем import math):

@func_decorator
def sin_df(x):
    return math.sin(x)
 
 
df = sin_df(math.pi/3)
print(df)

После запуска программы видим искомый результат. Но, что если, мы хотим управлять значением dx, передавая его как аргумент декоратору? Прописывать еще один параметр непосредственно у func_decorator, не лучший вариант:

def func_decorator(func, dx=0.0001):

В этом случае, у нас перестанет работать синтаксис с собачкой:

@func_decorator(dx=0.01)
def sin_df(x):
    return math.sin(x)

и попытка выполнить такую программу, приведет к ошибке. Для корректной реализации такой задачи следует обернуть имеющийся у нас декоратор в еще одну внешнюю функцию:

def df_decorator(dx=0.0001):
    def func_decorator(func):
        def wrapper(x, *args, **kwargs):
            res = (func(x+dx, *args, **kwargs) - func(x, *args, **kwargs)) / dx
            return res
 
        return wrapper
   return func_decorator

И применить уже ее к функции синуса:

@df_decorator(dx=0.01)
def sin_df(x):
    return math.sin(x)

Иллюстрация к уроку

В этом случае, аргумент будет передан в первую функцию, ссылка sin_df – во вторую вложенную функцию, а затем, через ссылку на третью функцию, мы можем вычислять значение производной:

df = sin_df(math.pi/3)

Все это эквивалентно следующим вызовам:

f = df_decorator(dx=0.01)
sin_df = f(sin_df)

Или, в более краткой форме:

sin_df = df_decorator(dx=0.01)(sin_df)

Но, запись через символ «собачки» куда нагляднее и проще, поэтому он, как правило, используется на практике.

Контроль имени и описания декорируемой функции

Во второй части занятия я хочу коснуться проблемы потери имени и описания декорируемой функции. О чем здесь речь? Вот смотрите, имя нашей декорированной функции можно узнать по специальному свойству name:

print(sin_df.__name__)

Сейчас оно принимает значение wrapper, что не удивительно, так как это и есть ссылка на эту функцию. Но изначально имя было другим (декоратор в комментарий и повторяем) – sin_df. Иногда важно сохранять исходные имена и при декорировании. Как это сделать? В самом простом варианте мы можем вручную внутри функции func_decorator изменить имя, оставив исходное:

def df_decorator(dx=0.0001):
    def func_decorator(func):
        def wrapper(x, *args, **kwargs):
            res = (func(x+dx, *args, **kwargs) - func(x, *args, **kwargs)) / dx
            return res
 
        wrapper.__name__ = func.__name__
        return wrapper
 
    return func_decorator

И, как видим, это работает. И тот же самый фокус можем проделать с описанием функции:

@df_decorator(dx=0.01)
def sin_df(x):
    """Функция для вычисления производной синуса"""
    return math.sin(x)

Это описание доступно с помощью специального свойства doc:

print(sin_df.__doc__)

Для декорированной функции оно равно None, а для исходной – заданная строка. Также сохраняем описание, прописав в функции func_decorator строчку:

wrapper.__doc__ = func.__doc__

Все, теперь у нас сохраняются и имена и описания декорируемых функций.

Но есть более простой и продвинутый способ сохранять свойства name и doc - с помощью специального декоратора:

from functools import wraps

Если мы декорируем вложенную функцию wrapper:

@wraps(func)

то строчки можно убрать (я поставлю в комментарии):

# wrapper.__name__ = func.__name__
# wrapper.__doc__ = func.__doc__

И, выполняя программу, видим, что имя функции и ее описание остаются прежними. То есть, декоратор wraps автоматически сохраняет эти свойства.

На этом мы завершим тему декораторов и функций языка Python. Этого материала, вам вполне хватит для программирования большинства задач и, кроме того, позволит понимать уже существующие программы. До встречи на следующем уроке!

Практика 10 · Часть I. Основы Python

Декораторы

Задания для закрепления темы · решений нет

Цели обучения

  • Писать декораторы, оборачивающие вызываемые объекты
  • Передавать параметры в фабрики декораторов
  • Сохранять метаданные через functools.wraps

Задания

Задание 1. Once

Сложность: лёгкое

Реализуйте декоратор @once так, чтобы обёрнутая функция выполнялась только при первом вызове; последующие вызовы возвращают первый результат без повторного выполнения тела.

Требования:

  • Работает для функций с args/kwargs
  • Использовать functools.wraps

Пример:

@once
def compute(x):
    print("run")
    return x * 2

compute(3)  # prints "run", returns 6
compute(9)  # no print, returns 6

Задание 2. Подсчёт вызовов

Сложность: лёгкое

Реализуйте @count_calls, который добавляет атрибут call_count на обёртку (начинается с 0) и увеличивает его при каждом вызове.

Требования:

  • functools.wraps
  • f.call_count доступен для чтения после декорирования

Пример:

@count_calls
def hi():
    return "hi"

hi(); hi()
hi.call_count  # 2

Задание 3. Проверка типа первого аргумента

Сложность: среднее

Реализуйте @ensure_type(expected_type) (декоратор с параметром): перед вызовом проверить isinstance(args[0], expected_type), если есть хотя бы один позиционный аргумент; иначе возбудить TypeError.

Требования:

  • Паттерн фабрики декоратора
  • functools.wraps на самой внутренней обёртке

Пример:

@ensure_type(int)
def double(n):
    return n * 2

double(2)      # 4
double("2")    # TypeError

Задание 4. Retry

Сложность: среднее

Реализуйте @retry(times: int): при исключении повторять попытки до times раз в сумме. Если все неудачны — повторно возбудить последнее исключение.

Требования:

  • times >= 1
  • Сохранять метаданные функции через wraps

Пример:

@retry(3)
def flaky():
    ...

Задание 5. Логирование ввода/вывода

Сложность: среднее

Реализуйте @log_calls(logger_fn), где logger_fn(msg: str) -> None. При каждом вызове логировать строку вида "name args=... kwargs=... -> result" (использовать repr). При исключении залогировать ошибку и повторно возбудить его.

Требования:

  • Параметризованный декоратор
  • Использовать __name__ обёрнутой функции (через wraps)

Пример:

messages = []
@log_calls(messages.append)
def add(a, b):
    return a + b

add(1, 2)
# messages[0] contains "add" and "3"

Задание 6. Мини-проект: кэш с TTL

Сложность: сложное

Реализуйте @ttl_cache(seconds: float):

  • Кэшировать результаты по (args, frozenset(kwargs.items())) (предполагать хешируемые args/kwargs)
  • Записи истекают через seconds (использовать time.monotonic())
  • Предоставить .cache_clear() на обёртке

Требования:

  • functools.wraps
  • Декоратор с параметрами
  • Независимые кэши для каждой декорированной функции

Подсказки:

  • Хранить (expires_at, value) в словаре на обёртке

Глава 11

Модули и пакеты

Урок 47 · Часть I. Основы Python

Импорт стандартных модулей. Команды import и from

Источник: python3-import-standartnyh-moduley-komandy-import-i-from

Этим занятием мы открываем новую тему, связанную с модулями и пакетами. В некоторых программах этого курса я уже делал импорт стандартных модулей, например:

import math
import time

чтобы использовать их функции. Но что они из себя представляют? В действительности, модуль – это обычный текстовый файл программы на языке Python. В этом легко убедиться, если в PyCharm нажать и удерживать клавишу Ctrl и щелкнуть по имени модуля, например, math. Откроется файл и мы можем ознакомиться с его содержимым.

Второй вопрос, а что собственно делает конструкция import? Как он импортирует этот текст программы в нашу программу? Давайте я с помощью функции locals() выведу все локальные переменные нашей программы:

print(locals())

В консоли у нас появился словарь и последними записями в нем идут имена math и time, которые ссылаются на соответствующие импортированные модули. Для более читаемого вида этой информации я импортирую еще один модуль:

import pprint

и из него вызову функцию с тем же именем:

pprint.pprint(locals())

Теперь мы видим все гораздо нагляднее. Кстати, дополнительно появилась еще одна строчка с именем pprint после его импортирования. Так вот, все эти имена: math, pprint, time – это переменные в нашей программе и каждая ссылается на свое пространство имен, со своими глобальными переменными. Например, чтобы посмотреть, что содержит модуль math, можно получить все ее переменные с помощью функции dir:

pprint.pprint(dir(math))

Мы видим полный список глобальных атрибутов этого модуля, включая имена функций и переменных. То есть, чтобы обратиться к определенной функции в своей программе, нам нужно написать имя импортируемого модуля и через точку указать имя функции или переменной, например:

a = math.ceil(1.8)
print(a)
print(math.pi)

То есть, в сточке import math автоматически создается пространство имен math в нашей программе, через которое мы можем обращаться к любому глобальному атрибуту этого модуля. И так с каждым импортируемым модулем.

Все эти модули, что я использовал, поставляются вместе с языком Python и составляют его стандартную библиотеку. Что еще входит в нее? Полный список модулей и подробное их описание приведено на странице официальной документации:

https://docs.python.org/3/library/

Я рекомендую вам в целом с ней ознакомиться, чтобы представлять ее возможности и использовать в своей программе готовый функционал, а не изобретать собственные велосипеды.

Далее, предположим, что мы в своей программе используем переменную с именем:

math = 'математика'

В итоге, в нашей программе, сначала при импорте math будет создана глобальная переменная math на импортируемый модуль, а затем, эта переменная станет ссылаться на строку. В результате мы уже не можем воспользоваться модулем math в своей программе и попытки обратиться к функции или переменной приведут к ошибкам.

Как разрешить эту ситуацию? Язык Python позволяет нам в момент импорта указывать псевдонимы импортируемых модулей, используя ключевое слово as, например:

import math as mt

И, далее, по программе использовать переменную mt в качестве имени модуля. На практике такая подстановка выполняется в двух целях. Во-первых, чтобы избежать возможного конфликта имен в программе и, во-вторых, для удобства, если имя модуля слишком длинное, то имеет смысл записать его более короткий псевдоним.

Когда импортируется модуль через import, то автоматически подключается все его пространство имен к нашей программе. Однако, часто из всего этого многообразия используется всего несколько функций или переменных. И, если мы не хотим подключать модуль целиком, а сделать выборочный импорт некоторых его атрибутов, то для этого следует использовать другую конструкцию:

from math import ceil, pi

Смотрите, теперь, при выводе:

pprint.pprint(locals())

мы не видим имя модуля math, но в пространстве имен нашей программы появляются имена ceil и pi. То есть, для их использования мы теперь должны обращаться к ним напрямую:

print(ceil(1.8))
print(pi)

Но при таком импорте мы можем столкнуться с ситуацией, когда импортируемая функция (или переменная) переопределяется в нашей программе. Например, если прописать свою собственную функцию ceil:

def ceil(x):
    print("своя функция ceil")
    return x

то именно она и будет вызвана, потому что сначала происходит импорт, а затем, объявление функции. Если объявление функции сделать до импорта, то, наоборот, будет использована библиотечная функция, а наша затрется. То есть, берется то, что определяется последним.

Для разрешения такой ситуации (конфликта имен) можно у импортируемых элементов указывать псевдонимы через ключевое слово as:

from math import ceil as m_ceil, pi

И, далее, уже обращаться к функции ceil через имя m_ceil:

print(m_ceil(1.8))

Конструкция from позволяет выполнять импорт сразу всего пространства имен, если после import поставить *:

from math import *

Тогда все функции, переменные и другие объекты будут напрямую импортированы в нашу программу, что также может вызвать конфликт имен, в частности, сейчас это происходит с функцией ceil. Поэтому делать такой импорт крайне не рекомендуется. Мы даже наперед точно не сможем сказать, какие имена будут добавлены в этом случае, особенно, если библиотеки меняются от версии к версии. Так что лучше такой импорт вообще не делать в своих программах.

И еще один момент. Формально в импорте мы можем через запятую перечислять имена импортируемых модулей, например:

import pprint, time, random

но стандарт PEP8 так делать не рекомендует. Следует вместо одного такого импорта записывать три, каждый с новой строчки:

import pprint
import time
import random

Это правило не касается конструкции from … import … Здесь, конечно же, мы указываем конкретные имена через запятую.

Наконец, последняя рекомендация – располагать импорты в самом начале программы. Редко от этого правила отступают, но в большинстве случаев импортирование следует делать в первых строчках программы.

На этом мы с вами завершим первое знакомство с модулями языка Python. Надеюсь, теперь вы знаете, как выполнять импорт стандартных библиотек. На следующем занятии мы продолжим эту тему и поговорим о создании и импорте собственных модулей.

Урок 48 · Часть I. Основы Python

Импорт собственных модулей

Источник: python3-import-sobstvennyh-moduley

На этом занятии вы узнаете как создавать и импортировать свои собственные модули. Как мы говорили на предыдущем уроке, модули представляют собой обычный текстовый файл программы на Python. Поэтому, в текущем рабочем каталоге я создам еще один файл и назову его mymodule.py. (Щелкаем правой кнопкой по вкладке mymodule и выбираем пункт «Split and Move Right»). Запишем в этом модуле следующие строчки:

NAME = 'mymodule'
def floor(x):
    print("функция из mymodule")
    return int(x) if x >= 0 else int(x) – 1

В результате, в глобальном пространстве имен имеем две переменные: NAME и floor. Все локальные переменные, например, x сюда уже не попадают – только глобальные определения.

Импортируем этот модуль в нашу программу ex.py:

import mymodule

и если теперь ниже записать:

mymodule.

то, как раз, увидим наши определения – переменную NAME и имя функции floor. То есть, они были импортированы в нашу программу и доступны через пространство имен mymodule:

print(mymodule.floor(-5.4))

Или же, можем воспользоваться другой конструкцией:

from mymodule import floor

и напрямую вызвать эту функцию:

print(floor(-5.4))

Но что будет, если в файле mymodule тоже прописать импорт, скажем, библиотеки math, следующим образом:

import math

В этом случае, в модуле mymodule появляется глобальная переменная с именем math. Значит, при импорте уже модуля mymodule (в ex.py):

import mymodule
import pprint

мы должны увидеть это имя:

pprint.pprint(dir(mymodule))

Действительно, в конце списка оно присутствует, а это значит, к модулю math можно обратиться через модуль mymodule:

a = mymodule.math.floor(-5.6)
print(a)

То есть, мы здесь уже имеем иерархию модулей, сначала обращаемся к mymodule, затем к math, а потом к одной из его функций.

Конечно, чтобы не создавать таких цепочек, можно было бы импортировать библиотеку math через конструкцию:

from math import *

(Еще раз отмечу, что так делать не рекомендуется. Здесь, я лишь в учебных целях показываю, что произойдет). В итоге получаем неявное расширение модуля mymodule за счет модуля math. И все функции из math мы теперь напрямую можем вызывать из mymodule:

a = mymodule.floor(-5.6)
b = mymodule.ceil(-5.6)
print(a, b)

Причем, вот эта функция floor была переопределена, поэтому вызывается не библиотечный вариант, а наш. Так вот, такой импорт ни в коем случае делать не стоит, чтобы не смешивать свои и стандартные функции в одном месте. Лучше или перечислять, те элементы, что мы собираемся использовать, например:

from math import pi, ceil

или же воспользоваться простым импортом:

import math

Давайте теперь детальнее разберемся, как работает импорт модулей. Первый вопрос, откуда Python «знает», где искать импортируемые модули? Порядок поиска прописан в специальной коллекции path модуля sys:

import sys
pprint.pprint(sys.path)

Здесь первые строчки – это каталог с исполняемым модулем ex.py и рабочий каталог, а далее, идут дополнительные пути поиска, например, для файлов стандартной библиотеки. Поэтому, если мы переместим файл модуля mymodule из рабочего каталога, в какую-нибудь вложенную папку, например, с именем folder (создаем и перемещаем), то при импорте получим ошибку ModuleNotFoundError, так как к этой папке не прописан путь в коллекции path. Поэтому, нам дополнительно нужно указать каталог folder, в котором находится модуль mymodule, следующим образом:

import folder.mymodule

Конечно, в список path мы можем добавить путь для поиска модулей:

sys.path.append(r"C:\PythonProjects\example\folder")

и тогда при импорте по-прежнему достаточно будет прописывать только mymodule. Но это делается крайне редко, обычно добавляют имена подкаталогов через точку.

Давайте теперь поменяем местами эти два файла (ex.py и mymodule.py). В этом случае для импорта достаточно будет также прописать:

import mymodule

так как пути поиска теперь будут включать и рабочий каталог, где находится mymodule и каталог с исполняемым файлом.

Вернем файл ex.py в рабочий каталог. И заметим, что в момент выполнения импорта модуль преобразуется интерпретатором языка Python сначала в байт-код, а затем, запускается на исполнение. Это важный момент. Смотрите, если в mymodule прописать строчку:

print(NAME)

и запустить файл ex.py на исполнение, то в консоли увидим результат срабатывания функции print(). Причем она сработала в момент импорта модуля до вызова функции pprint(). Это означает, что если в mymodule будет записана программа:

for i in range(5):
    print(NAME)

то она будет выполнена. Так что с этим следует быть аккуратным.

Значит, получается, что подключаемые модули должны исключительно содержать определения переменных, функций и других объектов языка Python, но не их вызовы? Не обязательно! В каждом модуле есть специальная переменная name, которая принимает имя модуля, если они запускается при импорте:

print(__name__)

и значение “main”, если он запускается как самостоятельная программа (показываем). И это свойство часто используют для контроля исполнения модуля. Если в нем нужно прописать программу, выполняемую только при непосредственном запуске модуля, то ее следует поместить в следующее условие:

if __name__ == "__main__":
    print("самостоятельный запуск")
else:
    print("запуски при импорте")

Такую проверку часто можно увидеть в питоновских программах и вы теперь знаете, для чего она нужна.

Давайте посмотрим, что произойдет, если в модульном файле сделать импорт проектного:

import ex

Чтобы результат был виден, в проектный файл добавим:

print("ex.py")

а в модульный:

print("mymodule")

После запуска видим, что сначала был выполнен проектный файл, затем, модульный, а потом, снова проектный. Но почему это выполнение не пошло дальше по цепочке? Дело в том, что модуль импортируется только один раз. Например, если прописать два импорта подряд:

import mymodule
import mymodule

то увидим только одно сообщение. Это, как раз, и доказывает, что модуль был выполнен только один раз. Если же нам нужно сделать повторный импорт в одной и той же программе, то для этого следует использовать специальную функцию:

importlib.reload(mymodule)

а перед этим импортируем специальный модуль

import importlib

который доступен, начиная с версии Python 3.4. В качестве аргумента этой функции передаем ранее импортированный модуль и он будет обновлен без перезапуска, поэтому второй раз функция print() в нем выполняться не будет.

Надеюсь, из этого занятия вам стало понятно, как создавать свои собственные модули, как их импортировать и как все это работает в деталях. Жду всех вас на следующем занятии!

Урок 49 · Часть I. Основы Python

Установка сторонних модулей (pip install). Пакетная установка

Источник: python3-ustanovka-storonnih-moduley-pip-install-paketnaya-ustanovka

На этом занятии мы познакомимся со способами установки сторонних (внешних) модулей для текущего интерпретатора Питона.

Я, думаю, вы прекрасно понимаете, что существующих стандартных модулей часто недостаточно для создания различных приложений. Например, если мы решаем какую-либо инженерную задачу, то часто применяются пакеты:

  • NumPy - работа с многомерными массивами;
  • Matplotlib – отображение графиков.

Если мы собираемся работать с графикой, то, обычно, используют модуль:

  • Pygame – реализация простой 2D-графики.

Если разрабатываем бэкэнд сайта, то нам потребуется фремворк, например:

  • Flask – простой фреймворк (часто для информационных сайтов);
  • Django – продвинутый фреймворк для самых сложных сайтов.

И так далее. Сторонние модули разрабатываются и обновляются постоянно. Для языка Python за долгие годы были разработаны сотни тысяч пакетов для самых разных нужд. В этом также одно из преимуществ данного языка – его удобно применять для решения самых разных задач.

Чтобы увидеть, какие пакеты уже установлены для текущего интерпретатора языка Python, нужно открыть командное окно или вкладку «Terminal» в PyCharm, набрать команду:

pip list

и отобразится список с номерами версий. Здесь слово pip означает обращение к специальному модулю, отвечающему за установку сторонних пакетов в интерпретатор. В самом простом варианте, чтобы установить новый модуль, нам нужно знать его название и, затем, выполнить команду:

pip install <название пакета>

Но как нам узнать, какие пакеты существуют, как они называются и как их применять в программе? Для этого существует специальный сайт (репозиторий) со списком сторонних пакетов и их кратким описанием:

https://pypi.org

Конечно, отображать названия обычным списком просто нереально. Здесь, как в поисковой системе, нужно набрать примерное название и выполнить поиск. Например, найдем пакет flask:

В результате, получим множество пакетов, где это имя фигурирует. В самом начале, как правило, появляются наиболее релевантные результаты. И, действительно, здесь первой строчкой, как раз и стоит пакет Flask – микрофреймворк для разработки простых сайтов. Щелкнем по нему и увидим краткое описание, ссылку на подробную документацию и команду для установки этого пакета:

pip install Flask

Если прописать ее в таком виде, то будет найдена последняя версия и установлена на компьютер. При необходимости, можно явно указать версию для установки. Для этого после имени пакета ставится два равно и пишется номер версии:

pip install Flask==1.1.2

Другой способ установки пакетов – через PyCharm. Для этого нужно выбрать Settings->ProjectInterpreter. Увидим окно с текущим интерпретатором языка Python и набором внешних установленных пакетов, а также их версий. Чтобы добавить новый пакет, выбираем «+» и в открывшемся окне через поиск находим нужный пакет и нажимаем кнопку «Install Package».

Обратите внимание, я постоянно говорю об установке пакетов для текущего интерпретатора. Дело в том, что установка модулей осуществляется с привязкой к выбранной версии языка Python. У вас на компьютере может быть установлено несколько версий (как у меня) и у каждой версии свой набор установленных внешних модулей. Это сделано специально, так как некоторые пакеты привязаны к определенным версиям языка Python. Поэтому установка происходит для текущего интерпретатора.

Также вас может интересовать, а где располагаются эти установленные модули? Узнать это очень просто. Наведем курсор мыши на название любого пакета и увидим путь его расположения. Этот путь также присутствует в специальной коллекции:

sys.path

о которой мы с вами говорили на прошлом уроке. Поэтому, все установленные внешние пакеты могут быть импортированы в программу без дополнительных указаний каталогов и подкаталогов.

Наконец, последнее, о чем я хочу рассказать вам на этом занятии – это пакетная установка внешних модулей. Делается это с помощью команды:

pip install -r <текстовый файл>

А в текстовом файле нужно прописать имена устанавливаемых модулей, обычно, с указанием требуемых версий, но можно и без них (тогда будет установлена последняя версия пакета).

Этот файл можно сформировать вручную, но часто такая пакетная установка используется для переноса проекта с одного компьютера на другой. Поэтому, в файле нужно прописать все установленные внешние пакеты. Чтобы не делать этого вручную, можно выполнить команду:

pip freeze > requirements.txt

и в рабочем каталоге проекта появится текстовый файл requirements.txt с набором всех установленных модулей для текущего интерпретатора. Далее, мы можем указать этот файл в команде:

pip install -r requirements.txt

и эти пакеты будут установлены при их отсутствии.

Вот, в целом, порядок установки сторонних пакетов для выбранного интерпретатора языка Python. Для закрепления материала попробуйте выполнить установку какого-либо модуля и переходите к следующему уроку.

Урок 50 · Часть I. Основы Python

Пакеты (package) в Python. Вложенные пакеты

Источник: python3-pakety-package-v-python-vlozhennye-pakety

На этом занятии речь пойдет о пакетах, узнаем, как их создавать и импортировать. Ранее мы с вами уже говорили о модулях – отдельных файлах с текстами программ, которые можно импортировать в другие программы. А пакет (package) – это специальным образом организованный подкаталог с набором модулей, как правило, решающих сходные задачи.

Давайте в качестве примера создадим пакет из модулей по обучающим курсам:

  • HTML
  • Java
  • PHP
  • Python

Это можно сделать, следующим образом. В PyCharm во вкладке «Project» щелкнуть правой кнопкой мыши и из выпадающего меню выбрать New -> Python Package. Здесь нам нужно придумать название пакета, пусть оно будет:

courses

Нажимаем Enter и пакет в рабочем каталоге создан. Посмотрим, что он из себя представляет. Переходим в рабочий каталог и видим в нем подкаталог с указанным именем courses. Внутри этого каталога находится только один пустой файл init.py. Чуть позже мы узнаем для чего он нужен.

Итак, пакет в Python – это обычный каталог, в котором обязательно должен располагаться специальный файл init.py.

Но пока наш пакет пустой, в нем нет ни одного модуля. Добавим их, то есть, добавим обычные python-файлы в этот каталог. Пусть они будут такими:

html.py:

def get_html():
    print("курс по HTML")

java.py

def get_java():
    print("Курс по Java")

php.py

def get_php():
    pass
 
 
def get_mysql():
    pass

python.py

def
get_python():
    print("курс по Python")

И, кроме того, в файл init.py добавим строчку:

NAME = "package courses"

И обратите внимание. Для корректной обработки модулей в пакете, все файлы следует создавать с кодировкой UTF-8.

Все, мы сформировали пакет и теперь можем его импортировать в нашу программу. Для этого записывается ключевое слово import и указывается имя пакета (название подкаталога):

import courses

Давайте посмотрим, что в итоге было импортировано:

print( dir(courses) )

Мы видим имя нашей переменной NAME и вспомогательные переменные, которые были созданы автоматически средой Python:

[‘NAME’, ‘builtins’, ‘cached’, ‘doc’, ‘file’, ‘loader’, ‘name’, ‘package’, ‘path’, ‘spec’]

Выведем значение переменной NAME:

print( courses.NAME )

И в консоли отображается строчка, прописанная в файле init.py. О чем это говорит? О том, что при импорте пакета файл init.py был выполнен. В действительности – это инициализатор пакета. В нем мы прописываем то, что следует импортировать при импорте пакета. Например, в нашем каталоге courses присутствуют четыре наших файла, но ни один из них не был использован в момент импорта. Это произошло, как раз, по той причине, что в файле init.py мы их никак не обрабатывали.

Чтобы получить доступ к функциям из модулей внутри пакета, их, в свою очередь, нужно импортировать в инициализаторе init.py, например, так:

import courses.python

Я, думаю, вы понимаете, почему вначале указан подкаталог courses? Так как модули находятся по нестандартному пути, то этот путь следует явно прописать. В данном случае, достаточно указать имя подкаталога, а затем, через точку имя файла.

Теперь, после запуска программы, мы видим, что в пространстве имен пакета courses появилось имя python. Поэтому, мы можем обратиться к этому модулю и вызвать его функцию:

courses.python.get_python()

Но, обычно, в инициализаторе пакетов импорт выполняют с помощью конструкции:

from courses.python import get_python

чтобы, затем, не указывать имя модуля в основной программе:

courses.get_python()

Но, все же, у такого способа импортирования модулей в инициализаторе пакета есть один существенный недостаток – мы, фактически, указываем полный путь к модулю (это называется абсолютным импортом). Представьте, например, что в будущем, по каким-либо причинам, придется поменять название пакета. Тогда и все абсолютные импорты также придется переписывать. Поэтому здесь лучше воспользоваться относительным способом импортирования. Для этого, вместо имени основного подкаталога courses, ставится точка:

from .python import get_python

Эта точка означает «использовать текущий каталог». Так гораздо практичнее и мы теперь совершенно не привязаны к названию пакета.

Или, можно записать так:

from . import html, java, php, python

тогда импортируем все модули в текущем пакете. Но, мы вернем прежний импорт и запишем его со звездочкой для получения всех данных из файла:

from .python import *

Ранее, я вам говорил, что в программах так лучше не делать. Однако, внутри пакетов делают – это исключение из общего правила. Почему такой импорт целесообразен? Дело в том, что модули внутри пакетов постоянно совершенствуются. Появляются новые функции, переменные, классы. И, чтобы каждый раз не менять их список в импорте, прописывают звездочку, так удобнее. При этом конфликта имен можно избежать, контролируя импортируемые данные. Для этого внутри модуля прописывается специальная переменная all со списком импортируемых данных, если используется оператор *. Например, если в модуле php.py, прописать:

__all__ = ['get_php', 'get_mysql']

то в пакет будут импортированы обе функции и мы их можем вызвать:

courses.get_php()
courses.get_mysql()

ошибок никаких не будет. Но, если оставить только какую-нибудь одну:

__all__ = ['get_php']

то прежняя программа выполнится с ошибками, так как вторая функция не была импортирована.

Эту же коллекцию all можно записывать и в инициализаторе, например, так:

from .python import *
from .php import *
 
NAME = "package courses"
 
__all__ = ['python', 'php']

Тогда модули python и php импортируются, а переменная NAME нет.

И последнее, о чем я, думаю, следует сказать – это возможность создавать вложенные пакеты. Делается это очевидным образом, создаем еще один вложенный каталог, например, с именем:

doc

через PyCharm (также). И, далее, разместим в этом вложенном пакете два файла:

java_doc.py:

doc = """Документация по языку Java"""

python_doc.py:

doc = """Документация по языку Python"""

Затем, в файле инициализатора этого пакета запишем импорт этих модулей:

from . import python_doc, java_doc

А в инициализаторе основного пакета – импорт вложенного пакета:

from .doc import *

и скорректируем коллекцию:

__all__ = ['python', 'php', "doc"]

Все, теперь в основной программе можно обращаться к переменным вложенного пакета, следующим образом:

print(courses.python_doc.doc)

Мало того, в самих модулях вложенного пакета можно обращаться к модулям внешнего пакета. Для этого следует при импорте указать две точки (переход во внешний каталог) и далее имя модуля, например (в файле python_doc.py):

from ..python import get_python

Затем, можно вызвать эту функцию:

doc = """Документация по языку Python: """ + get_python()

соответственно, ее переписав (в файле python.py):

def get_python():
    return "курс по Python"

Вот так относительно легко и просто можно создавать свои собственные пакеты, а также вкладывать один в другой. Принцип описания фрагментов программ на уровне пакета – довольно распространенная практика и вы теперь знаете, как все это работает.

Практика 11 · Часть I. Основы Python

Модули и пакеты

Задания для закрепления темы · решений нет

Цели обучения

  • Импортировать из стандартной библиотеки через import / from
  • Разбивать код на собственные модули
  • Структурировать небольшой пакет с __init__.py
  • Знать, когда и как устанавливать сторонние пакеты

Задания

Задание 1. Хелпер datetime из stdlib

Сложность: лёгкое

В файле dates_util.py реализуйте days_between(d1: str, d2: str) -> int, где даты в формате "YYYY-MM-DD". Вернуть абсолютную разницу в днях с помощью datetime.date.

Требования:

  • from datetime import date (или import datetime)
  • Парсить через date.fromisoformat

Пример:

from dates_util import days_between
days_between("2024-01-01", "2024-01-11")  # 10

Задание 2. Собственный модуль: geometry

Сложность: лёгкое

Создайте geometry.py с:

  • PI = 3.141592653589793
  • circle_area(r)
  • rectangle_area(w, h)

Из main.py в той же папке импортируйте и выведите обе площади для примерных значений.

Требования:

  • Два файла; пакета пока нет
  • Запуск как python main.py из этой папки

Задание 3. Выборочный импорт

Сложность: среднее

Создайте stats_ops.py с функциями mean, median, clamp. В demo_stats.py импортируйте только mean и clamp через from stats_ops import mean, clamp и продемонстрируйте обе.

Требования:

  • median должна существовать, но не импортироваться в demo_stats.py
  • Показать, что median нет в пространстве имён demo_stats

Задание 4. Структура пакета

Сложность: среднее

Создайте такую структуру:

textkit/
  __init__.py          # exports clean and word_count at package level
  clean.py             # def clean(s: str) -> str  (strip + lower)
  count.py             # def word_count(s: str) -> int

__init__.py должен позволять:

from textkit import clean, word_count

Требования:

  • Корректные реэкспорты в __init__.py
  • Относительные или абсолютные импорты внутри пакета на ваш выбор (задокументируйте, какие)

Задание 5. Вложенный пакет

Сложность: среднее

Расширьте до:

textkit/
  __init__.py
  clean.py
  count.py
  extra/
    __init__.py
    slug.py            # def slugify(s: str) -> str

slugify: в нижний регистр, пробелы заменить на -, оставить только a-z0-9-.

Требования:

  • from textkit.extra.slug import slugify работает, когда родитель textkit есть в sys.path

Пример:

slugify("Hello World!")  # "hello-world"

Задание 6. Мини-проект: небольшой пакет-инструментарий

Сложность: сложное

Соберите запускаемый мини-пакет calcapp/:

calcapp/
  __init__.py          # version = "0.1.0"
  __main__.py          # CLI entry: python -m calcapp
  ops/
    __init__.py
    basic.py           # add, sub, mul, div
    advanced.py        # power, mod

Использование CLI (разбор sys.argv):

python -m calcapp add 2 3      # prints 5
python -m calcapp power 2 10   # prints 1024

Требования:

  • __main__.py диспетчеризует по имени команды к функциям в ops
  • div возбуждает ZeroDivisionError при делении на ноль (не перехватывать)
  • При неверных аргументах вывести usage и завершиться с кодом 1
  • Опционально: в комментарии отметить, как бы вы сделали pip install стороннего пакета, если CLI позже понадобится (например rich) — для этого задания ничего устанавливать не требуется

Глава 12

Файлы

Урок 51 · Часть I. Основы Python

Функция open. Чтение данных из файла

Источник: python3-funkciya-open-chtenie-dannyh-iz-fayla

На этом занятии мы с вами научимся читать данные из файлов. Думаю, вы все прекрасно понимаете, что такое файлы и что они хранятся, как правило, на внешних носителях. (Часто – это жесткий диск устройства или флеш-память или SSD-диск. Бывают и другие носители). Главная особенность файлов – сохранение информации после отключения устройства от питания.

Начнем со знакомства с функцией:

open(file [, mode=’r’, encoding=None, …])

которая открывает указанный файл на чтение или запись данных (по умолчанию – на чтение). Основные ее параметры, следующие:

  • file – путь к файлу (вместе с его именем);
  • mode – режим доступа к файлу (чтение/запись);
  • encoding – кодировка файла.

Чтобы воспользоваться этой функцией, нужно правильно записать первый аргумент – путь к файлу. Давайте, посмотрим различные варианты его определения. Представим, что наш файл ex1.py находится в рабочем каталоге app:

Иллюстрация к уроку

Тогда, чтобы обратиться к файлу my_file.txt путь можно записать просто, как:

“my_file.txt”

или

“d:\\app\\my_file.txt”

или так:

“d:/app/my_file.txt”

Последние два варианта представляют собой абсолютный путь к файлу, то есть, полный путь, начиная с указания диска. Причем, обычно используют обратный слеш в качестве разделителя: так короче писать и такой путь будет корректно восприниматься как под ОС Windows, так и Linux. Первый же вариант – это относительный путь (относительно каталога с исполняемым файлом).

Теперь, предположим, что мы хотим обратиться к файлу img.txt. Это можно сделать так:

“images/img.txt”

или так:

“d:/app/images/img.txt”

Для доступа к out.txt пути будут записаны так:

”../out.txt”
“d:/out.txt”

Обратите внимание, здесь две точки означают переход к родительскому каталогу, то есть, выход из каталога app на один уровень вверх.

И, наконец, для доступа к файлу prt.dat пути запишутся так:

”../parent/prt.dat”
“d:/ parent/prt.dat”

Вот принцип, по которому прописываются пути к файлам. В нашем случае мы имеем текстовый файл «my_file.txt», который находится в том же каталоге, что и программа ex1.py, поэтому путь можно записать, просто указав имя файла:

file = open("my_file.txt")

В результате переменная file будет ссылаться на файловый объект, через который и происходит работа с файлами. Если указать неверный путь, например, так:

file = open("my_file2.txt")

то возникнет ошибка FileNotFoundError. Поэтому пути нужно прописывать аккуратно. Позже мы увидим, как можно избежать такой ошибки, чтобы программа не прерывалась при неверно указанном файле.

Итак, функция open() по умолчанию открывает файл на чтение. Это значит, что в этом режиме мы можем только считывать информацию из файла, но не записывать. Как прочитать данные из файла? Для этого существует несколько методов у файлового объекта. Например, если выполнить метод:

print( file.read() )

то будет прочитан весь файл целиком и результат представлен в виде строки. Но сейчас мы видим с вами в консоли отображаются какие-то кракозябры. Почему? Все дело в несовпадении кодировок. В моем случае метод read() читает данные в кодировке windows-1251, а кодировка файла с текстом – UTF-8. Чтобы это поправить, в функции open() нужно явно указать кодировку файла через именованный аргумент encoding:

file = open("myfile.txt", encoding="utf-8" )

Теперь все работает корректно. Но, что если нам нужно прочитать из файла всего несколько символов? Для этого достаточно вызвать метод read() и первым аргументом указать максимальное количество читаемых символов, например:

print( file.read(4) )

Из файла будут считаны первые четыре символа. Правда, в консоли мы видим только три символа. Дело в том, что при кодировке UTF-8 в файл автоматически добавляется первый (невидимый) символ с шестнадцатиричным кодом:

FEFF

Иллюстрация к уроку

Если мы снова вызовем метод:

print( file.read(4) )

то будут прочитаны следующие четыре символа. Вот эта стрелка (на рисунке) называется файловой позицией (file position), которая указывает, с какого места производить последующее считывание информации. Благодаря ей мы можем последовательно читать данные, просто вызывая метод read(). Когда доходим до конца файла, то здесь находится специальный символ EOF, означающий конец файла.

При необходимости, мы можем управлять положением файловой позиции. Для этого существует специальный метод:

file.seek(offset[, from_what])

Например, вот такая запись:

file.seek(0)

будет означать, что мы устанавливаем позицию в начало и тогда такие строчки:

    print( file.read(4) )
    file.seek(0)
    print( file.read(4) )

будут считывать одни и те же первые символы. Если же мы хотим узнать текущую позицию в файле, то следует вызвать метод tell:

pos = file.tell()
print( pos )

Следующий полезный метод readline() позволяет построчно считывать информацию из текстового файла:

    s = file.readline()
    print( s )

Здесь концом строки считается символ переноса ‘\n’, либо конец файла. Причем, этот спецсимвол переноса будет также присутствовать в строке. Мы в этом можем убедиться, вызвав дважды функцию:

    print( file.readline() )
    print( file.readline() )

Здесь в консоли строчки будут разделены пустой строкой. Это как раз из-за того, что один перенос идет из прочитанной строки, а второй добавляется самой функцией print(). Поэтому, если их записать вот так:

    print( file.readline(), end="" )
    print( file.readline(), end="" )

то вывод будет построчным с одним переносом.

Если нам нужно последовательно прочитать все строчки из файла, то для этого обычно используют цикл for следующим образом:

    for line in file:
        print( line, end="" )

Этот пример показывает, что объект файл является итерируемым и на каждой итерации возвращает очередную строку.

Или же, все строчки можно прочитать методом:

s = file.readlines()

и тогда переменная s будет ссылаться на список с этими строками:

print( s )

Однако этот метод следует использовать с осторожностью, т.к. для больших файлов может возникнуть ошибка нехватки памяти для хранения полученного списка.

По сути это все методы для считывания информации из файла. Осталось только добавить, что как только мы завершаем работу с файлом, его следует закрыть. Для этого используется метод close:

file.close()

Конечно, прописывая эту строчку, мы не увидим никакой разницы в работе программы. Но, во-первых, закрывая файл, мы освобождаем память, связанную с этим файлом и, во-вторых, у нас не будет проблем в потере данных при их записи в файл. А, вообще, лучше просто запомнить: после завершения работы с файлом, его нужно закрыть.

На этом мы завершим наше первое знакомство с файлами. Из этого занятия вы должны запомнить, как открыть файл на чтение, как прочитать все данные или часть данных, как менять файловую позицию и не забывать закрывать открытые файлы после работы с ними. Жду всех вас на следующем уроке!

Урок 52 · Часть I. Основы Python

Исключение FileNotFoundError и менеджер контекста (with) для файлов

Источник: python3-isklyuchenie-filenotfounderror-i-menedzher-konteksta-with-dlya-faylov

На предыдущем занятии я отмечал, что если указать неверный путь к файлу, то возникнет ошибка:

FileNotFoundError

и программа досрочно прерывается. Это неприятный момент, тем более, что программист наперед не может знать, в каких условиях будет работать программа и вполне возможна ситуация, когда ранее доступный файл становится недоступным, например, из-за случайного его удаления, или изменении имени и т.п. То есть, при работе с файлами нужно уметь обрабатывать исключение FileNotFoundError, чтобы программа продолжала работать, даже если файл не будет найден.

Для обработки подобных ошибок (или, как говорят, исключений) существует специальная группа операторов:

try / except / finally

о которых мы подробно будем говорить в части объектно-ориентированного программирования на Python. Но, несмотря на то, что это выходит за рамки базового курса, я решил показать, как использовать эти операторы при работе с файлами. Иначе, ваши программы будут заведомо содержать серьезную уязвимость при обращении к файлам.

Формально, операторы try / except / finally имеют, следующий синтаксис (определение):

try:
блок операторов
критического кода
except [исключение]:
блок операторов
обработки исключения
finally:
блок операторов
всегда исполняемых
вне зависимости, от
возникновения исключения

И в нашем случае их можно записать, так:

try:
    file = open("my_file.txt", encoding='utf-8')
    s = file.readlines()
    print(s)
    file.close()
except FileNotFoundError:
    print("Невозможно открыть файл")

Смотрите, здесь функция open() находится внутри блока try, поэтому, если возникнет исключение FileNotFoundError, то выполнение программы перейдет в блок except и отобразится строка «Невозможно открыть файл». Иначе, мы прочитаем все строки из файла, отобразим их в консоли и закроем файл.

Однако, и в такой реализации не все гладко. В момент считывания информации из файла (в методе readlines()) также может возникнуть исключение из-за невозможности считывания информации из файла. Поэтому, совсем надежно можно было бы реализовать эту программу, следующим образом:

try:
    file = open("my_file.txt", encoding='utf-8')
 
    try:
        s = file.readline()
        print(s)
    finally:
        file.close()
        
except FileNotFoundError:
     print("Невозможно открыть файл")
except: 
    print("Ошибка при работе с файлом")

Мы здесь прописываем еще один вложенный блок try, который будет учитывать все возможные исключения и при их возникновении мы обязательно перейдем в блок finally для закрытия файла. Это важная процедура – любой ранее открытый файл (функцией open()) следует закрывать, даже при возникновении исключений. И вот такая конструкция try / finally нам гарантирует его закрытие, что бы ни произошло в момент работы с ним. Но блок try / finally не отлавливает исключения, поэтому они передаются внешнему блоку try и здесь мы должны их обработать. Я сделал это через второй блок except, в котором не указал никакого типа исключений. В результате, он будет реагировать на любые не обработанные ошибки, то есть, в нашем случае – на любые ошибки, кроме FileNotFoundError.

Менеджер контекста для файлов

Более я не буду углубляться в работу блоков try / except / finally. Приведенного материала пока вполне достаточно, а в заключение этого занятия расскажу о замене блока try / finally так называемым файловым менеджером контекста, как это принято делать в программах на Python.

Так вот, в языке Python существует специальный оператор with, который, можно воспринимать как аналог конструкции try / finally и в случае работы с файлами записывается, следующим образом:

try:
    with open("my_file.txt", encoding='utf-8') as file:
        s = file.readlines()
        print( s )
 
except FileNotFoundError:
     print("Невозможно открыть файл")
except:
    print("Ошибка при работе с файлом")

Смотрите, мы здесь сразу вызываем функцию open(), создается объект file, через который, затем, вызываем методы для работы с файлом. Причем, все операторы должны быть записаны внутри менеджера контекста, так как после его завершения файл закрывается автоматически. Именно поэтому здесь нет необходимости делать это вручную.

При работе с менеджером контекста следует иметь в виду, что он не обрабатывает никаких ошибок (исключений) и все, что происходит, передается вышестоящему блоку try, где они и обрабатываются. Но в любом случае: произошли ошибки или нет, файл будет автоматически закрыт. В этом легко убедиться, если добавить блок finally для оператора try, в котором отобразить флаг закрытия файла:

try:
    with open("my_file.txt", encoding='utf-8') as file:
        s = file.readlines()
        print( s )
 
except FileNotFoundError:
     print("Невозможно открыть файл")
except:
    print("Ошибка при работе с файлом")
finally:
    print(file.closed)

После запуска программы видим значение True, то есть, файл был закрыт. Даже если произойдет критическая ошибка, например, вызовем функцию int() для строки s:

int(s)

то, снова видим значение True – файл был закрыт. Вот в этом удобство использования менеджера контекста при работе с файлами.

На этом мы завершим наше ознакомительное занятие по обработке файловых ошибок. Пока будет достаточно запомнить использование операторов try / except / finally при работе с файлами, а также знать, как открывать файлы через менеджер контекста. На следующем уроке мы продолжим тему файлов и будем говорить о способах записи данных.

Урок 53 · Часть I. Основы Python

Запись данных в файл в текстовом и бинарном режимах

Источник: python3-zapis-dannyh-v-fayl-v-tekstovom-i-binarnom-rezhimah

На этом занятии вы узнаете, как можно сохранять данные в файл. Первое, что нам нужно сделать – это открыть файл на запись. Для этого вторым аргументом функции open() следует указать строку “w”:

file = open("out.txt", "w")

(Если не указывать ничего, как это мы делали на прошлых уроках, то файл будет открыт на чтение, или же, можно явно прописать “r” – значение по умолчанию).

Итак, мы открыли файл на запись и далее, чтобы поместить в него какую-либо текстовую информацию следует вызвать метод write, следующим образом:

file.write("Hello World!")
file.close()

В результате будет создан файл out.txt (если его ранее не было) со строкой «Hello World!». Причем, этот файл будет располагаться в том же каталоге, что и исполняемый файл. Также после записи всей нужной информации в файл, его следует обязательно закрывать! Иначе, часть информации может не сохраниться. Как я уже говорил, метод close() нужно вызывать всегда после завершения работы с файлом.

Отлично, это у нас получилось! Давайте теперь запишем метод write со строкой «Hello»:

file.write("Hello")

и снова выполним эту программу. Смотрите, в нашем файле out.txt прежнее содержимое исчезло и появилось новое – строка «Hello». То есть, когда мы открываем файл на запись, то прежнее содержимое удаляется. Вот этот очень важный момент всегда следует иметь в виду – открывая файл на запись, его прежнее содержимое автоматически удаляется!

Те из вас, кто смотрел предыдущее занятие, сейчас могут заметить, что при открытии файла на запись могут возникать различные файловые ошибки, поэтому критический блок (кода открытия файла и записи информации) лучше поместить в блок try, а все операции с файлом выполнять через менеджер контекста:

try:
    with open("out.txt", "w") as file:
        file.write("Hello World!")
except:
    print("Ошибка при работе с файлом")

Об этом всегда следует помнить, при работе с файлами! Чтобы программа работала надежно даже в нештатных ситуациях, необходима конструкция try / except и менеджер контекста with.

Давайте теперь посмотрим, что будет, если вызвать метод write несколько раз подряд для одного и того же открытого файла:

        file.write("Hello1")
        file.write("Hello2")
        file.write("Hello3")

Смотрите, в файле появились все эти строчки друг за другом. То есть, здесь как и со считыванием, объект file записывает информацию, используя файловую позицию, и автоматически перемещает ее при выполнении записи новых данных. Поэтому все эти строки идут в файле друг за другом.

Если мы хотим, чтобы эти строки шли друг под другом, то в конце каждой из них достаточно указать символ переноса строки:

        file.write("Hello1\n")
        file.write("Hello2\n")
        file.write("Hello3\n")

Однако, если нам все же нужно, мы можем выполнять дозапись информации в файл. Для этого его следует открыть в режиме ‘a’ (сокращение от англ. слова append – добавление):

with open("out.txt", "a") as file:
    ...

Выполняя эту программу, мы видим в файле уже шесть строчек.

Но будьте аккуратны. Если мы открываем файл на запись или дозапись, то читать информацию из этого файла уже не получится. Например, если попытаться воспользоваться методом read():

file.read()

то возникнет ошибка. Чтобы ее увидеть я поставлю комментарии у блока try и снова запущу программу. Видим исключение UnsupportedOperation.

Если же мы хотим и записывать и считывать информацию, то можно воспользоваться режимом a+:

file = open("out.txt", "a+")

Так как здесь файловый указатель стоит на последней позиции, то для считывания информации, поставим его в самое начало:

        file.seek(0)
        print( file.read() )

А вот запись данных всегда осуществляется в конец файла, так как для записи используется другая файловая позиция и она указывает на конец файла.

Далее, если нам нужно записать несколько строк, представленных в какой-либо коллекции, то удобно воспользоваться методом writelines():

file.writelines(["Hello1\n", "Hello2\n"])

Это часто используется, если в процессе обработки текста у нас получается список из строк и его требуется целиком поместить в файл. Здесь метод writelines() незаменим.

Чтение и запись в бинарном режиме доступа

До сих пор мы с вами говорили о чтении и записи информации в текстовом режиме доступа. Есть еще другой – бинарный режим работы с файлами. Что такое бинарный режим доступа? Это когда данные из файла считываются один в один без какой-либо обработки. Обычно он используется для сохранения и считывания объектов целиком. Давайте предположим, что нам нужно сохранить в файл вот такой список:

books = [
    ("Евгений Онегин", "Пушкин А.С.", 200),
    ("Муму", "Тургенев И.С.", 250),
    ("Мастер и Маргарита", "Булгаков М.А.", 500),
    ("Мертвые души", "Гоголь Н.В.", 190)
]

Для этого откроем файл на запись в бинарном режиме:

file = open("out.bin", "wb")

Затем, для работы с бинарными данными подключим специальный встроенный модуль pickle:

import pickle

И вызовем его метод dump:

pickle.dump(books, file)

Все, мы сохранили этот объект в файл. Теперь прочитаем эти данные. Откроем файл на чтение в бинарном режиме:

file = open("out.bin", "rb")

и вызовем метод load модуля pickle:

bs = pickle.load(file)

Все, теперь переменная bs ссылается на эквивалентный список:

print( bs )

Аналогичным образом можно записывать и считывать сразу несколько объектов. Например, так:

import pickle
 
book1 = ["Евгений Онегин", "Пушкин А.С.", 200]
book2 = ["Муму", "Тургенев И.С.", 250]
book3 = ["Мастер и Маргарита", "Булгаков М.А.", 500]
book4 = ["Мертвые души", "Гоголь Н.В.", 190]
 
try:
    with open("out.bin", "wb") as file:
        pickle.dump(book1, file)
        pickle.dump(book2, file)
        pickle.dump(book3, file)
        pickle.dump(book4, file)
except:
    print("Ошибка при работе с файлом")

А, затем, считывание в том же порядке:

import pickle
 
try:
    with open("out.bin", "rb") as file:
        b1 = pickle.load(file)
        b2 = pickle.load(file)
        b3 = pickle.load(file)
        b4 = pickle.load(file)
except:
    print("Ошибка при работе с файлом")
 
print( b1, b2, b3, b4, sep="\n" )

Вот так в Python выполняется запись и считывание данных в бинарном режиме.

Надеюсь, из этого занятия вам стало понятно, как производится запись данных в файл, как делать дозапись информации, что такое бинарный и текстовый режимы доступа и как записывать и считывать информацию в бинарном режиме с помощью методов модуля pickle. До встречи на следующем занятии!

Практика 12 · Часть I. Основы Python

Файлы

Задания для закрепления темы · решений нет

Цели обучения

  • Открывать файлы для чтения и записи
  • Всегда использовать with для безопасной работы с ресурсами
  • Обрабатывать отсутствующие файлы и работать с текстовым и бинарным режимами

Задания

Задание 1. Прочитать все строки

Сложность: лёгкое

Реализуйте read_lines(path: str) -> list[str]: вернуть строки без завершающего \n. Используйте with open(...).

Требования:

  • Кодировка utf-8
  • Если файл отсутствует — возбудить FileNotFoundError (не перехватывать)

Пример:

# file content: "a\nb\n"
read_lines("sample.txt")  # ["a", "b"]

Задание 2. Записать строки

Сложность: лёгкое

Реализуйте write_lines(path: str, lines: list[str]) -> None: записать каждый элемент как строку, заканчивающуюся \n. Перезаписать файл, если он существует.

Требования:

  • Режим "w", кодировка utf-8
  • Использовать with

Задание 3. Безопасное чтение со значением по умолчанию

Сложность: среднее

Реализуйте read_or_default(path: str, default: str = "") -> str: вернуть текст файла, если он существует; при FileNotFoundError вернуть default.

Требования:

  • Перехватывать только FileNotFoundError
  • Использовать with при открытии

Пример:

read_or_default("missing.txt", "N/A")  # "N/A"

Задание 4. Бинарное копирование

Сложность: среднее

Реализуйте copy_binary(src: str, dst: str) -> int: скопировать файл в бинарном режиме; вернуть число записанных байт.

Требования:

  • Режимы "rb" / "wb"
  • Читать чанками (например, по 4096 байт) — не требовать загрузки всего файла в память, если он большой

Пример:

copy_binary("a.bin", "b.bin")  # e.g. 1024

Задание 5. Дописать строку в лог

Сложность: среднее

Реализуйте append_log(path: str, message: str) -> None: дописать одну строку "YYYY-MM-DD HH:MM:SS message\n", используя datetime.now().

Требования:

  • Режим "a", кодировка utf-8
  • Создать файл, если его нет

Задание 6. Мини-проект: статистика слов из файла

Сложность: сложное

Реализуйте небольшой CLI-скрипт wordstats.py:

python wordstats.py input.txt report.txt

Поведение:

  1. Прочитать input.txt (utf-8)
  2. Разбить на слова: нижний регистр, с краёв убрать пунктуацию (.,!?;:"'())
  3. Записать report.txt с:

- Первая строка: words: N (всего токенов)

- Вторая: unique: N

- Затем до 10 строк word: count для самых частых слов (при равенстве — по алфавиту)

Требования:

  • Использовать with для всего файлового I/O
  • При отсутствии входного файла вывести понятную ошибку в stderr и завершиться с кодом 1
  • Без сторонних библиотек

Подсказки:

  • collections.Counter можно, если знаете; иначе — словарь

Глава 13

Генераторы и функциональные инструменты

Урок 54 · Часть I. Основы Python

Выражения генераторы

Источник: python3-vyrazheniya-generatory

На этом занятии мы с вами поговорим о выражениях-генераторах. Что это такое? Смотрите, когда мы рассматривали генераторы списков, то в квадратных скобках описывали некий алгоритм формирования значений списка:

a = [x for x in range(1, 5)]

Так вот, все эти значения были сгенерированы внутренним генератором, с помощью которого и заполнялся весь этот список.

Иллюстрация к уроку

То же самое и для генерации множеств и словарей. Здесь также внутренний генератор автоматически заполнял значениями эти коллекции. Так вот, в Python можно определить такой генератор без привязки к какой-либо коллекции. Для этого используется синтаксис такой же, как и для генераторов коллекций, только все записывается в круглых скобках:

(<формирование значения> for <переменная> in <итерируемый объект>)

Обратите внимание, круглые скобки здесь не означают кортеж. Генераторов кортежей не существует. Когда мы пишем круглые скобки, то получаем на выходе «чистый» генератор. Например, строчка:

a = (x ** 2 for x in range(6))

задает генератор для формирования квадратов целых чисел от 0 до 5. Если выведем значение переменной a, то увидим, что это объект-генератор:

<generator object at 0x032DEAE0>

Но как получить нам конкретные значения из этого генератора? Очень просто! Генератор сам по себе является также и итератором, то есть, его значения можно перебирать с помощью функции next():

next(a)
…
next(a)

пока не получим исключение StopIteration. Соответственно, пройтись по значениям генератора можно только один раз. Повторно их перебрать уже не получится.

Помимо функции next() генераторы можно перебирать и в цикле for, так как они являются итерируемыми объектами:

gen = (x ** 2 for x in range(6))
 
for x in gen:
    print(x)

Но, опять же, перебрать его можно только один раз, поэтому повторный цикл for не выведет никаких значений:

for x in gen:
    print(x)

Некоторые функции, такие как:

list, set, sum, max, min и другие

позволяют работать непосредственно с итераторами. То есть, в качестве аргумента им можно передавать генератор, например:

a = (x ** 2 for x in range(6))
list(a)

будет сформирован список из значений на выходе генератора. Или так:

a = (x ** 2 for x in range(6))
set(a)

получим множество из значений генератора. То же самое и для других функций:

sum((x ** 2 for x in range(6)))
max((x ** 2 for x in range(6)))

И еще раз обратите внимание, использовать эти и другие подобные им функции для одного и того же генератора можно только один раз. Например, вызывая функцию sum() дважды:

a = (x ** 2 for x in range(6))
sum(a)
sum(a)

Во втором случае увидим 0, так как элементы генератора нельзя обойти второй раз.

Но здесь остается один важный вопрос: зачем вообще нужны эти выражения-генераторы? Дело в том, что эти объекты по сравнению, например, с обычными списками не хранят в памяти все значения сразу, а генерируют их по мере необходимости, то есть, при переходе к следующему значению. Например, если возникает необходимость оперировать очень большим списком:

lst = list(range(1000000000000))

то у компьютера попросту не хватит памяти для его хранения и возникнет ошибка. А вот с генераторами таких проблем не возникнет, так как они не хранят все числа сразу, а формируют их по мере необходимости «на лету»:

lst = (x for x in range(1000000000))
 
for i in lst:
    print(i, end=" ")
    if i > 50:
        break

И, кроме того, работает такая конструкция достаточно быстро. Правда, для генераторов нельзя определить число элементов через функцию len():

a = (x for x in range(10, 20))
len(a)

или получить доступ к его отдельному элементу по индексу:

a[2]

так как этих элементов попросту нет, они генерируются последовательно при вызове функции next().

Если все же требуется работать со значениями генератора, как с элементами списка, то его сначала нужно преобразовать в этот список, а затем со списком и работать:

a = (x for x in range(10, 20))
b = list(a)

И, опять же, если попробовать преобразовать этот же генератор к списку еще раз:

b2 = list(a)

то получим пустой список, так как элементы генератора уже были перебраны в первой функции list() и сделать это повторно не получится.

Также не получится преобразовать генератор к списку, используя квадратные скобки:

[(x ** 2 for x in range(6))]

В этом случае первым элементом списка будет ссылка на объект-генератор, не более того. Также это означает, что у генераторов списков нельзя внутри прописывать круглые скобки, как это сделано сейчас. Теперь мы знаем, что это определение выражения-генератора внутри обычного списка.

Итак, из этого занятия вы должны были узнать, что из себя представляют выражения-генераторы, как перебираются их элементы и для чего они могут понадобиться. Помнить об ограничениях, накладываемые на генераторы, связанные с генерацией значений «на лету», то есть, нельзя использовать функцию len(), обращаться по индексу и перебирать его элементы только один раз. Для закрепления этого материала пройдите практические задания и переходите к следующему уроку.

Урок 55 · Часть I. Основы Python

Функция-генератор. Оператор yield

Источник: python3-funkciya-generator-operator-yield

На этом занятии мы с вами поговорим о функциях-генераторах. Но вначале вернемся к выражениям-генераторам, которые рассматривали на предыдущем занятии. Давайте предположим, что нам нужны средние арифметические значения для разных последовательностей целых чисел:

1, 2, 3, 4, 5, 6, 7, 8, 9, 10
2, 3, 4, 5, 6, 7, 8, 9, 10
3, 4, 5, 6, 7, 8, 9, 10
4, 5, 6, 7, 8, 9, 10
5, 6, 7, 8, 9, 10
6, 7, 8, 9, 10
7, 8, 9, 10
8, 9, 10
9, 10

Для этого мы могли бы записать следующее выражение-генератор:

N = 10
a = (sum(range(i, N+1))/len(range(i, N+1)) for i in range(N))

Но оно не очень удобно для восприятия и редактирования и, кроме того, здесь дважды записана функция range() при вычислении среднего значения. Поправить это можно двумя способами. В первом, объявить собственную функцию для вычисления среднего арифметического и вызвать ее в генераторе:

def avg(start, stop, step=1):
    a = range(start, stop, step)
    return sum(a) / len(a)
 
 
N = 10
 
a = (avg(i, N + 1) for i in range(1, N))
print(list(a))

А во втором способе – создать собственную функцию-генератор , которая бы на выходе выдавала нужные значения. Давайте для начала запишем простую функцию-генератор, а потом вернемся к нашей исходной задаче. Функция будет просто возвращать значения списка:

def get_list():
    for x in [1, 2, 3, 4]:
        yield x

Смотрите, здесь в цикле записан новый для нас оператор yield, который возвращает текущее значение x и «замораживает» состояние функции до следующего обращения к ней (в том числе и все локальные переменные). Именно так определяются функции-генераторы. Если мы сейчас ее вызовем:

d = get_list()
print(d)

то, смотрите, переменная d ссылается на объект-генератор, то есть, мы здесь имеем дело с генератором, значения которого можно перебирать с помощью функции next():

print(next(d))
print(next(d))

Или, через цикл:

d = get_list()
for i in d:
    print(i, end=" ")

В этом и заключается роль оператора yield. Он превращает обычную функцию в генератор и при каждом вызове функции next() активизируется функция-генератор, возвращает очередное значение и «замораживает» свое состояние вместе с локальными переменными до следующего вызова функции next(). (Показываем это в режиме отладки).

Надеюсь, вы теперь хорошо представляете, как работает оператор yield и простая функция-генератор. Давайте вернемся к нашей исходной задаче и перепишем функцию avg() с использованием оператора yield (создаем еще одну):

def avg_gen(N, step=1):
    for i in range(1, N):
        a = range(i, N+1, step)
        yield sum(a) / len(a)

Принцип здесь тот же самый, на каждой итерации цикла будет возвращаться новое вычисленное среднее арифметическое значение. Далее, мы можем воспользоваться этой функцией-генератором и отобразить все ее значения, используя функцию list():

b = avg_gen(N)
print(list(b))

Как видите, результат полностью совпадает с первоначальным. То есть, мы заменили выражение-генератор на функцию-генератор. Ну и, как всегда, возникает вопрос, зачем это все было надо? Почему бы не пользоваться обычными генераторами? Что нам мешает это делать? В целом, ничего. Преимущество здесь, главным образом, в удобстве использования. В выражении генератора мы можем записать лишь один оператор для формирования значения, а в функции-генераторе – произвольный фрагмент программы, реализующий нужную нам логику формирования очередного значения. В этом ключевое отличие функции-генератора от обычного генератора.

В заключение этого занятия приведу еще один пример использования функции-генератора. Предположим, что мы хотим найти все начальные индексы слова «генератор» в текстовом файле lesson_54.txt. Для этого вначале откроем этот файл на чтение:

try:
    with open("lesson_54.txt", encoding="utf-8") as file:
        a = find_word(file, "генератор")
        print(list(a))
except FileNotFoundError:
    print("Файл не найден!")
except:
    print("Ошибка обработки файла!")

И внутри блока try вызовем функцию-генератор, которая и будет последовательно возвращать индексы найденного слова «генератор». Саму функцию определим выше (по программе), следующим образом:

def find_word(f, word):
    g_indx = 0
    for line in f:
        indx = 0
        while(indx != -1):
            indx = line.find(word, indx)
            if indx > -1:
                yield g_indx + indx
                indx += 1
 
        g_indx += len(line)

Мы здесь в первом цикле читаем файл по строкам. Во втором вложенном цикле while ищем указанное слово в строке, используя метод find(). И, если этот метод находит заданный фрагмент, то есть, возвращает значение больше -1, то функция генерирует на выходе значение индекса найденного слова как g_indx + indx. Здесь g_indx – это смещение по тексту для текущей строки, то есть, в ней мы суммируем длины предыдущих строк, чтобы сформировать индекс слова в тексте, а не в строке.

После запуска этой программы видим все найденные индексы данного слова по тексту. Как видите, мы в функции описали нетривиальную логику алгоритма поиска слова в текстовом файле. Сделать это с помощью обычного генератора было бы сложнее. В этом и преимущество функций-генераторов – они позволяют сразу, в одном месте кода, описывать нужный нам функционал.

На этом мы завершим с вами очередное занятие. Для закрепления материала, как всегда, пройдите практические задания и переходите к следующему уроку.

Урок 56 · Часть I. Основы Python

Функция map. Примеры ее использования

Источник: python3-funkciya-map-primery-ee-ispolzovaniya

На этом занятии мы с вами поговорим о функции map(). Мы ее ранее уже использовали и теперь пришло время в деталях понять, как она работает.

Вначале я приведу простой пример использования функции map() для преобразования строк чисел в обычные числа:

b = map(int, ['1', '2', '3', '5', '7'])

Первым аргументом указана ссылка на функцию, которая будет последовательно применяться к каждому элементу списка, а вторым аргументом – список из строк с числами. Вообще, вторым аргументом можно записывать любой итерируемый объект. На выходе функция map() возвращает итератор. То есть, переменная b – это итератор, который можно перебрать для преобразования строк в числа.

Вернемся к нашей программе и ниже дважды вызовем функцию next() для итератора b:

print(next(b))
print(next(b))

В консоли видим первые два преобразованных значения. Давайте переберем все их с помощью цикла for:

for x in b:
    print(x, end=" ")

Как видите, получили числа соответствующих строк. То есть, здесь действительно функция map() последовательно применила функцию int() к каждому элементу списка и на выходе мы видим уже обычные целые числа.

Мы также легко можем сохранить результат преобразования в новом списке, используя функцию list():

a = list(b)
print(a)

Здесь функция list() автоматически перебрала итератор, неявно вызывая функцию next(), и сформировала соответствующие значения списка.

Этот же результат можно получить, используя генератор списка, следующим образом:

a = [int(x) for x in ['1', '2', '3', '5', '7']]
print(a)

Но здесь, в отличие от функции map() мы все значения уже храним в памяти, тогда как функция map() возвращает итератор и значения формируются по одному в процессе вызова функции next().

А вот эквивалентный генератор:

a = (int(x) for x in ['1', '2', '3', '5', '7'])

нам бы, фактически, дал то же самое, что и функция map(). То есть, map() возвращает генератор, в котором некая функция применяется последовательно к элементам итерируемой последовательности. Используется она исключительно для удобства, чтобы не прописывать генератор в классическом виде.

Далее, кроме функции list() мы также с итератором можем применять некоторые другие функции, которые в качестве аргумента принимают итерированный объект, например:

print(sum(b))

Но, если следом попытаться перебрать итератор еще раз:

print(sum(b))

то увидим значение 0, так как мы помним, что итератор можно перебирать только один раз. Вот это следует помнить, используя функцию map() – ее значения можно извлечь только один раз.

Вместо функции sum() можно также использовать функции max() и min()

print(max(b))
print(min(b))

И другие, которые работают с итерируемыми последовательностями.

Конечно, вместо функции int() мы можем использовать любую другую, которая принимает один аргумент и возвращает некоторое значение. Например, можем взять список городов:

cities = ["Москва", "Астрахань", "Самара", "Уфа", "Смоленск", "Тверь"]

и применить к его элементам функцию len(), следующим образом:

b = map(len, cities)
print(list(b))

Видите, как легко и просто записан генератор для преобразования списка cities? В этом и заключается удобство использования функции map().

Также мы можем применять к этим строкам их методы, например, переведем все в верхний регистр:

b = map(str.upper, cities)

Мы здесь указали объект str и его метод upper(), который возвращает новую строку со всеми заглавными буквами.

Также мы можем определять и свои функции, используемые в map(). Как я уже отмечал, функция обязательно должна принимать один аргумент и возвращать некоторое значение, например, так:

def symbols(s):
    return list(s.lower())

Мы здесь сначала преобразовываем строку в нижний регистр, а затем, формируем список из отдельных символов, который и возвращаем. Далее, в функции map() указываем эту функцию:

b = map(symbols, cities)

(Обратите внимание, без круглых скобок, то есть, передаем ссылку на нее, а не вызываем). И после запуска программы увидим наборы вложенных списков из отдельных символов исходных строк.

Конечно, если функция выполняет какую-либо простую операцию, то часто прописывают лямбда-функции непосредственно в map(). В нашем случае это можно сделать так:

b = map(lambda s: list(s.lower()), cities)

Результат будет прежним, а программа стала более простой и читабельной.

Или, можно преобразовать строки, записав их символы в обратном порядке:

b = map(lambda s: s[::-1], cities)

Как видите, используя механизм срезов и функцию map(), сделать это очень просто. Поэтому весь материал, что мы с вами проходим, нужно очень хорошо запоминать, чтобы уметь использовать в своих программах.

Ну и теперь, возвращаясь к уже знакомой нам конструкции:

s = map(int, input().split())
print(list(s))

(Я ее записал здесь в две строки, чтобы было понятнее.) Вы понимаете, как она работает. Здесь input().split() возвращает список из строк введенных чисел, к каждой строке применяется функция int() и с помощью функции list() генератор s превращается в список из чисел.

Вот, что из себя представляет функция map(), которая довольно часто применяется на практике. Закрепите этот материал практическими заданиями и жду всех вас на следующем уроке.

Урок 57 · Часть I. Основы Python

Функция filter для отбора значений итерируемых объектов

Источник: python3-funkciya-filter-dlya-otbora-znacheniy-iteriruemyh-obektov

На прошлом занятии мы с вами детально познакомились с функцией map(). Здесь же будем говорить о похожей функции filter():

filter(func, *iterables)

которая служит для фильтрации (отбора) элементов указанного итерированного объекта.

Работает она очень просто. Если функция func возвращает для текущего значения элемента True, то он будет возвращен, а при False – отброшен. Например, у нас имеется список из целых чисел:

a = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

и мы хотим выбрать из него только четные значения. Для этого запишем функцию filter(), следующим образом:

b = filter(lambda x: x % 2 == 0, a)
print(b)

После запуска программы, видим, что переменная b ссылается на специальный объект filter. В действительности, это итератор, который можно перебрать с помощью функции next():

print(next(b))
print(next(b))

В результате, увидим в консоли первые два четных значения из списка. Переберем их все с помощью цикла for:

for x in b:
    print(x, end=" ")

Или, можно сформировать новый список с помощью функции list():

c = list(b)
print(c)

Или кортеж:

c = tuple(b)

И так далее. Можно перебрать итератор любыми известными нам функциями и операторами.

Иногда алгоритм обработки текущего значения может быть нетривиальным и записать его в лямбда-функцию довольно сложно. Ну, например, проверить, является ли число простым или нет. Напомню, что простым называется любое натуральное число, которое делится только на себя и на единицу. Такую проверку лучше вынести в отдельную функцию:

def is_prost(x):
    d = x-1
    if d < 0:
        return False
    
    while d > 1:
        if x % d == 0:
            return False
        d -= 1
 
    return True

А, затем, указать ее в filter():

b = filter(is_prost, a)

На выходе получим только простые числа из списка. Конечно, это не самый лучший способ нахождения простых чисел, но как пример функции для filter() вполне подходит.

Функцию filter можно применять с любыми типами данных, например, строками. Пусть у нас имеется вот такой кортеж:

lst = ("Москва", "Рязань1", "Смоленск", "Тверь2", "Томск")
b = filter(str.isalpha, lst)
 
for x in b:
    print(x)

и мы вызываем метод строк isalpha(), который возвращает True, если в строке только буквенные символы. В результате в консоли увидим:

Москва Смоленск Тверь2 Томск

Вложенные вызовы функции filter()

Так как функция filter() возвращает итератор и в качестве второго аргумента также можно указывать любой итерируемый объект, то мы можем одну функцию filter() вложить в другую:

Иллюстрация к уроку

Например, первая (вложенная) функция filter() будет формировать простые числа, а вторая (внешняя) выбирать из простых чисел только нечетные. В нашей программе для этого достаточно прописать еще одну строчку:

b2 = filter(lambda x: x % 2 != 0, b)

и вывести полученный список:

c = tuple(b2)
print(c)

Или, то же самое можно реализовать и так:

b2 = filter(lambda x: x % 2 != 0, filter(is_prost, a))

Мы здесь вторым аргументом передаем результат работы вложенной функции filter(). И таких вложений можно делать сколько угодно. Хотя на практике, как правило, все эти вложения можно легко свести к одному простому вызову функции filter(), сформировав более сложное условие. Обычно, так и поступают. То есть, опять же, в нашем случае вместо этой вложенности можно немного модифицировать саму функцию is_prost(), следующим образом:

def is_prost(x):
    d = x-1
    if d < 0 or x % 2 == 0:
        return False
 
    while d > 1:
        if x % d == 0:
            return False
        d -= 1
 
    return True

Мы здесь вначале прописали составное условие if d < 0 or x % 2 == 0, которое сразу возвратит False для четного значения x. И при этом, программа будет работать быстрее.

Вот так работает и используется функция filter() для отбора определенных значений из итерируемых объектов. Для закрепления этого материала пройдите практические задания и переходите к следующему уроку.

Урок 58 · Часть I. Основы Python

Функция zip. Примеры использования

Источник: python3-funkciya-zip-primery-ispolzovaniya

На прошлых занятиях мы с вами познакомились с двумя функциями map() и filter(). На этом продолжим эту тему и поговорим о третьей часто применяемой функции:

zip(iter1 [, iter2 [, iter3] …])

Она для указанных итерируемых объектов перебирает соответствующие элементы и продолжает работу до тех пор, пока не дойдет до конца самой короткой коллекции. Таким образом, она гарантирует, что на выходе будут формироваться наборы значений из всех переданных объектов.

Давайте в качестве простого примера возьмем два списка со значениями:

a = [1, 2, 3, 4]
b = [5, 6, 7, 8, 9, 10]

и передадим их в качестве аргументов функции zip():

z = zip(a, b)
print(z)

После запуска программы увидим, что переменная z ссылается на объект zip. Как вы уже догадались, это итератор, элементы которого перебираются функцией next():

print(next(z))
print(next(z))

Давайте переберем все пары через цикл for:

for x in z:
    print(x)

Здесь x является кортежем из соответствующих значений списков a и b. Причем последняя пара заканчивается числами (4, 8), когда функция zip() дошла до конца самого короткого списка.

Также всегда следует помнить, что функция zip() возвращает итератор. Это значит, что перебрать элементы можно только один раз. Например, повторный вызов оператора for для этой же функции:

for x in z:
    print(x)

ничего не возвратит, так как мы уже один раз прошлись по его элементам в предыдущем цикле.

Если нам все же нужно несколько раз обходить выделенные пары элементов, то их следует вначале преобразовать, например, в кортеж:

z = tuple(zip(a, b))

А, затем, обходить несчетное число раз. Но в этом случае увеличивается расход памяти, так как мы сохраняем все элементы в кортеже, а не генерируем «на лету» с помощью итератора. Так что, без особой необходимости делать преобразование к кортежу или списку не стоит.

В качестве перебираемых коллекций могут быть любые итерируемые объекты, например, строки. Если мы добавим строку:

c = "python"

и вызовем функцию zip() и с ней:

z = zip(a, b, c)

то в консоли увидим кортежи уже из трех значений, причем последнее будет соответствующим символом строки. Также, напомню, что оператор for можно записать с тремя переменными, если перебираемые значения являются кортежами:

for v1, v2, v3 in z:
    print(v1, v2, v3)

Иногда удобно кортеж сразу распаковать в отдельные переменные и использовать внутри цикла for.

Также все кортежи из функции zip() мы можем получить с помощью распаковки, используя запись:

z1, z2, z3, z4 = zip(a, b, c)
print(z1, z2, z3, z4, sep="\n")

Здесь неявно вызывается функция next() для извлечения всех элементов. Или, можно записать так:

z1, *z2 = zip(a, b, c)
print(z1, z2, sep="\n")

Тогда первое значение будет помещено в переменную z1, а все остальные – в список z2.

И в заключение этого занятия я покажу вам еще одно интересное преобразование, которое можно выполнить с помощью функции zip(). Если преобразовать итератор в список:

z = zip(a, b, c)
lz = list(z)

а, затем, распаковать его элементы с помощью оператора *:

print(*lz)

то мы получим уже не список, а четыре кортежа, следующих друг за другом. Если передать их в таком виде на вход функции zip():

t1, t2, t3 = zip(*lz)
print(t1, t2, t3, sep="\n")

то на выходе будут сформированы три кортежа из соответствующих элементов этих четырех. Вообще, это эквивалентно записи:

t1, t2, t3 = zip((1, 5, 'p'), (2, 6, 'y'), (3, 7, 't'), (4, 8, 'h'))

Но те же самые кортежи мы можем получить гораздо проще, если распаковать непосредственно итератор z:

t1, t2, t3 = zip(*z)

Как видите, к итератору вполне применим оператор распаковки элементов и на практике иногда этим пользуются.

Надеюсь, из этого занятия вы узнали, как работает функция zip() и ее назначение. Для закрепления материала, как всегда, пройдите практические задания и переходите к следующему уроку.

Практика 13 · Часть I. Основы Python

Генераторы и функциональные инструменты

Задания для закрепления темы · решений нет

Цели обучения

  • Предпочитать выражения-генераторы для ленивых конвейеров
  • Писать функции-генераторы с yield
  • Комбинировать map, filter и zip для преобразований

Задания

Задание 1. Ленивые квадраты

Сложность: лёгкое

Реализуйте squares(n: int) как функцию-генератор, выдающую 02, 12, ..., (n-1)**2. При n <= 0 ничего не выдавать.

Требования:

  • Использовать yield
  • Не возвращать список

Пример:

list(squares(4))  # [0, 1, 4, 9]

Задание 2. Сумма через выражение-генератор

Сложность: лёгкое

Реализуйте sum_even_squares(n: int) -> int с помощью выражения-генератора внутри sum (не list comprehension).

Требования:

  • Одно выражение sum(... for ...)
  • Чётные числа в диапазоне 1..n включительно

Пример:

sum_even_squares(5)  # 2**2 + 4**2 = 20

Задание 3. Бесконечный счётчик с остановкой

Сложность: среднее

Реализуйте count_from(start: int = 0, step: int = 1), выдающий бесконечную последовательность. Также реализуйте генератор take(iterable, n: int), выдающий не более n элементов.

Требования:

  • Оба — генераторы
  • take должен останавливаться раньше, если iterable закончился

Пример:

list(take(count_from(10, 2), 3))  # [10, 12, 14]

Задание 4. Параллельные списки через zip

Сложность: среднее

Реализуйте dot_product(a: list[float], b: list[float]) -> float с помощью zip. При разной длине использовать более короткую (как обрезает zip).

Требования:

  • Использовать zip (желательно sum + выражение-генератор)
  • Пустые → 0.0

Пример:

dot_product([1, 2, 3], [4, 5])  # 1*4 + 2*5 = 14.0

Задание 5. Конвейер map + filter

Сложность: среднее

Реализуйте positive_roots(nums: list[float]) -> list[float]:

  • Оставить только значения > 0 (filter)
  • Преобразовать каждое в квадратный корень (map + math.sqrt)
  • Вернуть список

Требования:

  • Использовать map и filter (не эквивалентные comprehensions)
  • Импортировать math

Пример:

positive_roots([4, -1, 9, 0])  # [2.0, 3.0]

Задание 6. Генератор скользящего окна

Сложность: сложное

Реализуйте window(iterable, size: int), выдающий кортежи подряд идущих элементов длины size. При size <= 0 возбудить ValueError. Если iterable короче size — ничего не выдавать.

Требования:

  • Функция-генератор с yield
  • Работать с любым iterable (можно материализовать в список или буферизовать)

Пример:

list(window([1, 2, 3, 4], 3))  # [(1, 2, 3), (2, 3, 4)]

Задание 7. Мини-проект: извлечение столбца CSV

Сложность: сложное

Реализуйте iter_csv_column(path: str, column: int):

  • Открыть текстовый файл UTF-8
  • Выдавать поле с индексом column из каждой непустой строки, разбитой по , (разбор quoted-CSV не требуется)
  • Пропускать строки, в которых недостаточно столбцов
  • Использовать генератор (yield) и with open

Также реализуйте column_as_floats(path, column) -> list[float] через map/filter над генератором (пропускать значения, которые не конвертируются, с помощью вспомогательного предиката).

Требования:

  • Ленивое чтение строк в iter_csv_column
  • Продемонстрировать использование на небольшом образце файла, который вы создадите

Глава 14

Сортировка, типы и предикаты

Урок 59 · Часть I. Основы Python

Особенности сортировки через sort() и sorted()

Источник: python3-osobennosti-sortirovki-cherez-sort-i-sorted

Здесь мы с вами затронем вопрос сортировки итерируемых объектов с помощью метода sort() и функции sorted(). Давайте вначале посмотрим на отличие в их вызовах. Если у нас имеется какой-либо список:

a=[1,-45,3,2,100,-4]

то этот объект имеет встроенный метод sort, который меняет его состояние и расставляет элементы по возрастанию:

a.sort()

Получим измененный список:

[-45, -4, 1, 2, 3, 100]

А вот коллекции кортежи или строки:

b=("ab", "bc", "wd", "gf")
c = "hello world"

не имеют такого встроенного метода и попытка их отсортировать, записав:

b.sort()
c.sort()

приведет к ошибке. Для их сортировки как раз и можно воспользоваться второй функцией sorted:

sorted(b)

на выходе получим упорядоченный список

[‘ab’, ‘bc’, ‘gf’, ‘wd’]

Обратите внимание, чтобы мы не передавали в качестве аргумента функции sorted, на выходе будем получать именно список отсортированных данных. В данном случае передаем кортеж, а получаем – список.

Или же, со строкой:

sorted(c)

результатом будет упорядоченная коллекция из символов:

[’ ‘, ‘d’, ‘e’, ‘h’, ‘l’, ‘l’, ‘l’, ‘o’, ‘o’, ‘r’, ‘w’]

Причем, эта функция не меняет исходные коллекции b и c, она возвращает новый список с отсортированными данными. В то время как метод sort для списка меняет этот список. Вот на это следует также обращать внимание. То есть, если нам нужно сохранить результат сортировки в переменной, это делается так:

res = sorted(b)

и res будет ссылаться на список:

[‘ab’, ‘bc’, ‘gf’, ‘wd’]

Также следует иметь в виду, что сортировка данных возможна для однотипных элементов: или чисел, или строк, или кортежей, но не их комбинаций. Например, вот такой список:

a=[1,-45,3,2,100,-4, "b"]

отсортировать не получится:

a.sort()

возникнет ошибка, что строку нельзя сравнивать с числом. И то же самое с функцией sorted:

sorted(a)

Если уберем последний элемент:

a=[1,-45,3,2,100,-4]

то все будет работать:

sorted(a)

И этот пример также показывает, что список можно сортировать и с помощью метода sort и с помощью функции sorted. Разница только в том, что метод sort не создает новой коллекции, а меняет уже существующую. Функция же sorted не меняет исходную коллекцию, а создает новую с отсортированными элементами. Поэтому, для изменения коллекции a здесь следует записывать такую конструкцию:

a = sorted(a)

Оба этих подхода к сортировке поддерживают необязательный параметр

reverse = True/False

который определяет порядок сортировки: по возрастанию (False) или по убыванию (True). По умолчанию стоит значение reverse=False. Если мы запишем его вот так:

a = sorted(a, reverse=True)

то получим сортировку по убыванию:

[100, 3, 2, 1, -4, -45]

И то же самое с методом sort:

a.sort(reverse=True)

Давайте еще посмотрим, как будет работать сортировка для словаря:

d = {'river': "река", 'house': "дом", 'tree': "дерево", 'road': "дорога"}

Очевидно, для него мы можем использовать только функцию sorted():

sorted(d)

которая на выходе даст список с ключами, отсортированными по возрастанию. И это логично, так как словарь по умолчанию возвращает именно ключи при его итерировании.

Также можно использовать конструкции вида:

sorted(d.values())

и

sorted(d.items())

Работают они очевидным образом.

Надеюсь, из этого занятия вы лучше стали понимать, как можно выполнять сортировку различных коллекций в языке Python. Для закрепления этого материала вас ждут практические задания, а я буду всех ждать на следующем уроке, где мы продолжим эту тему и поговорим о тонкой настройке алгоритма сортировки данных.

Урок 60 · Часть I. Основы Python

Аргумент key для сортировки коллекций по ключу

Источник: python3-argument-key-dlya-sortirovki-kollekciy-po-klyuchu

На этом занятии мы увидим, как можно управлять алгоритмом сортировки с помощью специального параметра key, который имеется у метода sort() и функции sorted().

По умолчанию сортировка коллекции выполняется по значениям ее элементов. Например:

a = [4, 3, -10, 1, 7, 12]
b = sorted(a)
print(b)

Но мы можем вместо этих значений указать другие, которые будут использованы для сортировки элементов. Например, вычислить показатель четности значений. Тогда последовательность будет выстроена по возрастанию этих ключей. В результате увидим сначала четные значения, а потом – нечетные.

Иллюстрация к уроку

Чтобы выполнить такую манипуляцию в функции sorted() прописывается аргумент key и ему присваивается ссылка на функцию, которая будет формировать альтернативное значение элемента, то есть, ключ:

b = sorted(a, key=is_odd)

А саму функцию можно определить, следующим образом:

def is_odd(x):
    return x % 2

Здесь аргумент x – это текущее значение элемента коллекции, а то, что она возвращает, становится значением соответствующего ключа. То есть, для четных значений будем иметь 0, а для нечетных – 1. После запуска программы видим искомый результат сортировки.

Конечно, для простых функций, обычно, в аргументе key записывают лямбда-функцию. В нашем примере она будет выглядеть, следующим образом:

b = sorted(a, key=lambda x: x % 2)

Как видите, все достаточно просто.

Тот же самый аргумент key можно указывать и в методе sort() для списка:

a.sort(key=lambda x: x % 2)

Он здесь работает абсолютно также, как и в функции sorted().

Давайте теперь немного усложним нашу задачу и сделаем не просто разделение на четные и нечетные, а еще и отсортируем каждую группу по возрастанию. Для этого значения ключей я буду увеличивать на значения элементов и, кроме того, нечетным величинам изначально присваивать число 100, чтобы гарантированно разделить четные и нечетные значения именно в нашей коллекции. Это исключительно учебный пример, показывающий возможности сортировки коллекций по ключу.

Иллюстрация к уроку

Итак, для формирования таких ключей, определим следующую функцию:

def key_sort(x):
    return x if x % 2 == 0 else 100 + x

И укажем ее в функции sorted():

b = sorted(a, key=key_sort)
print(b)

Теперь у нас выполняется не только разделение на четные и нечетные значения, но и их сортировка внутри групп.

Я, думаю, что вы в целом поняли, как использовать аргумент key для управления сортировкой. И здесь, как всегда, извечный вопрос – зачем это надо? Давайте я приведу несколько более практичных примеров. Предположим, что у нас имеется список городов:

lst = ["Москва", "Тверь", "Смоленск", "Псков", "Рязань"]

И требуется их выстроить по длине. Для этого воспользуемся функцией sorted() и в аргументе key укажем стандартную функцию len:

print( sorted(lst, key=len) )

получим следующий результат:

[‘Тверь’, ‘Псков’, ‘Москва’, ‘Рязань’, ‘Смоленск’]

Или можно сделать сортировку по последнему символу слова:

print( sorted(lst, key=lambda x: x[-1]) )

[‘Москва’, ‘Псков’, ‘Смоленск’, ‘Тверь’, ‘Рязань’]

Или только по первому:

print( sorted(lst, key=lambda x: x[0]) )

[‘Москва’, ‘Псков’, ‘Рязань’, ‘Смоленск’, ‘Тверь’]

И так далее.

Аргумент key часто используют для сортировки сложных структур данных. Допустим, у нас имеется вот такой кортеж, содержащий вложенные кортежи с информацией по книгам:

books = (
    ("Евгений Онегин", "Пушкин А.С.", 200),
    ("Муму", "Тургенев И.С.", 250),
    ("Мастер и Маргарита", "Булгаков М.А.", 500),
    ("Мертвые души", "Гоголь Н.В.", 190)
)

И нам нужно его отсортировать по цене (последнее значение). Очевидно, это можно сделать так:

print( sorted(books, key=lambda x: x[2]) )

На выходе получим отсортированный список:

[(‘Мертвые души’, ‘Гоголь Н.В.’, 190), (‘Евгений Онегин’, ‘Пушкин А.С.’, 200), (‘Муму’, ‘Тургенев И.С.’, 250), (‘Мастер и Маргарита’, ‘Булгаков М.А.’, 500)]

Вот так используется аргумент key для управления сортировкой элементов произвольных коллекций данных. И теперь вы знаете, как его применять в своих программах.

Урок 61 · Часть I. Основы Python

Функции isinstance и type для проверки типов данных

Источник: python3-funkcii-isinstance-i-type-dlya-proverki-tipov-dannyh

На этом занятии мы поговорим о функции isinstance(), с помощью которой можно выполнять проверку на принадлежность объекта определенным типам данных.

Например, объявим переменную:

a = 5

и для нее вызовем функцию isinstance(), следующим образом:

isinstance(a, int)

Увидим значение True, так как переменная a действительно ссылается на целочисленный объект. А вот если указать:

isinstance(a, float)

то уже будет возвращено значение False. Вот так в самом простом варианте работает эта функция. Но у нее есть один нюанс, связанный с булевым типом данных. Если определить переменную:

b = True

то, очевидно, функция:

isinstance(b, bool)

вернет значение True. Однако, если вместо bool записать int:

isinstance(b, int)

то тоже увидим True. Это связано с особенностью реализацией типа bool. Не буду углубляться в эти детали, здесь просто достаточно запомнить этот момент. Но тогда спрашивается, а как отличать тип bool от типа int? Если нужна строгая проверка на типы, то лучше использовать знакомую нам функцию type() с проверкой на равенство:

type(b) == bool

или, используя оператор is:

type(b) is bool

Эта функция различает булевы типы от целочисленных:

type(b) is int

Или, если мы хотим произвести множественную проверку, то воспользоваться оператором in:

type(b) in (bool, float, str)

Здесь мы сразу проверяем переменную b на три типа данных.

Сейчас у вас может возникнуть вопрос, зачем нужна функция isinstance(), если проверку типов можно делать функцией type()? В целом, они действительно очень похожи, но isinstance() в отличие от type() делает проверку с учетом иерархии наследования объектов и была разработана для проверки принадлежности объекта тому или иному классу:

Иллюстрация к уроку

Например, тип bool наследуется от int, поэтому isinstance() выдает True для обоих типов, когда b – булева переменная. А функция type() даст True только для типа bool. То есть, здесь проверка происходит без учета иерархии. (Я сейчас не буду углубляться и объяснять, что такое наследование – это уже раздел ООП и предмет отдельного курса).

Теперь, когда мы в целом познакомились с работой функции isinstance(), давайте рассмотрим следующий пример. Предположим, что у нас есть кортеж с произвольными данными:

data = (4.5, 8.7, True, "книга", 8, 10, -11, [True, False])

И наша задача вычислить сумму всех вещественных чисел этой коллекции. Для этого, очевидно, вначале каждый элемент кортежа нужно проверить на вещественный тип данных, а затем, выполнять суммирование. Я вначале сделаю это через обычный цикл for:

s = 0
for x in data:
    if isinstance(x, float):
        s += x
 
print(s)

Как видите, у нас получилась нужная сумма. Но эту же задачу можно реализовать лучше, с использованием ранее рассмотренной функции filter():

s = sum(filter(lambda x: isinstance(x, float), data))

Видите, все записано в одну строчку и, кроме того, работает быстрее, так как используются встроенные функции вместо цикла for.

А вот если мы попробуем вычислить сумму целочисленных значений, просто изменив тип данных:

s = sum(filter(lambda x: isinstance(x, int), data))

то увидим неверное значение 8, так как в коллекции data присутствует булево значение True, которое интерпретируется как целое число 1. Здесь лучше применять строгую проверку с использованием функции type():

s = sum(filter(lambda x: type(x) is int, data))

Теперь видим верное значение 7.

С помощью функции isinstance() можно делать и множественные проверки. Например, мы хотим определить, относится ли число к целому или вещественному типу данных? Для этого достаточно записать кортеж из этих типов:

a = 5.5
isinstance(a, (int, float))

Это эквивалентно записи:

isinstance(a, int) or isinstance(a, float)

Но первый вариант короче и потому чаще используется на практике.

Вот так в Python можно выполнять проверку типов данных для произвольных объектов. А также знаете отличия между работой функций isinstance() и type(). До встречи на следующем уроке.

Урок 62 · Часть I. Основы Python

Функции all и any. Примеры их использования

Источник: python3-funkcii-all-i-any-primery-ih-ispolzovaniya

На этом занятии мы поговорим о функциях all() и any(). Первым делом посмотрим, что они делают и зачем нужны? Начнем с функции all() и очень простого примера. Предположим, что есть список булевых значений:

a = [True, True, True, True]

И мы хотим узнать, принимают ли все они значение True? Для этого, как раз и используется функция all(), которая на вход принимает итерируемый объект и все его значения приводит к булевым величинам:

all(a)

Если все значения равны True, то на выходе получаем True. Если же, хотя бы одно значение принимает False, то на выходе будет False:

all([True, True, False, True])

Но, как вы понимаете, значения в списках могут быть любыми, например, такими:

a = [0, 1, 2.5, "", "python", [], [1, 2], {}]

И к нему тоже можно применить функцию all():

all(a)

Как она работает? Помните, когда мы говорили о типе bool, то говорили, что любое значение можно привести к этому типу? В частности:

bool(0)

даст False, так как 0 воспринимается, как пустое значение. По тем же причинам False получается и для:

bool("")
bool([])
bool({})

А вот все, что не пустое, превращается в True:

bool(1)
bool("python")

Именно так вначале происходит преобразование списка, а затем, применяется функция all(). И, так как список содержит значения False, то и результат равен False.

Работу этой функции можно повторить с помощью обычных булевых операций. Если вначале объявить некую переменную со значением True:

all_res = True
for x in a:
    all_res = all_res and bool(x)
 
print(all_res)

А, затем, в цикле для каждого элемента выполнять оператор and, то эта переменная сохранит начальное значение True только в том случае, если не встретится ни один False. Я вам показал этот способ, чтобы вы знали как действовать в других языках программирования, где нет уже готовой функции all(). В Python, конечно, следует использовать эту функцию – это и удобнее и быстрее.

Вторая функция any() работает похожим образом, но возвращает True, если встретилось хотя бы одно такое значение. Например, для списка:

any(a)

мы увидим значение True. А вот если передать список со всеми False:

any([False, False, False, False])

то только в этом случае она вернет False.

Повторим также работу этой функции через булевы операции. Начальное значение переменной здесь нужно присвоить False:

any_res = False
for x in a:
    any_res = any_res or bool(x)
 
print(any_res)

А, затем, в цикле с помощью оператора or (или) корректировать это значение текущей булевой величиной. Если встретится хотя бы один True, то оператор or вернет True и оно сохранится в переменной any_res, что бы в дальнейшем не появлялось.

Вот принцип работы этих двух функций. Ну и, наверное, самый главный вопрос, где это имеет смысл применять? Давайте представим, что мы делаем игру «Крестики-нолики» и хотели бы на каждом шаге определять, есть ли выигрышная позиция, например, у крестиков? Для простоты сделаем это следующим образом. Все поле из девяти клеток я представлю одномерным списком (сейчас вы узнаете, зачем):

P = ['x', 'x', 'o', 'o', 'x', 'o', 'x', 'x', 'x']

Иллюстрация к уроку

Тогда, чтобы проверить выигрышные ситуации по строкам, можно воспользоваться функцией all(), следующим образом:

row_1 = all(map(lambda x: x == 'x', P[:3]))
row_2 = all(map(lambda x: x == 'x', P[3:6]))
row_3 = all(map(lambda x: x == 'x', P[6:]))
 
print(row_1, row_2, row_3)

Смотрите, мы здесь используем вложенный вызов функции map(), чтобы правильно преобразовать крестики в True, а нолики – в False, иначе бы все преобразовалось в True. Далее, срез для каждой строки на выходе функции map() обрабатывается функцией all() и получаем результат: True – есть выигрышная комбинация; False – нет выигрышной комбинации.

Кстати, внимательный и грамотный зритель здесь сразу должен возмутиться из-за дублирования кода – три раза записана одна и та же анонимная функция. Действительно, это лучше поправить и использовать свою собственную:

def true_x(a):
    return a == 'x'

И, затем, указать ее в функции map():

row_1 = all(map(true_x, P[:3]))
row_2 = all(map(true_x, P[3:6]))
row_3 = all(map(true_x, P[6:]))

Теперь известный принцип DRY – сохраняется. По аналогии можно сделать проверку выигрыша по столбцам:

col_1 = all(map(true_x, P[::3]))
col_2 = all(map(true_x, P[1::3]))
col_3 = all(map(true_x, P[2::3]))
 
print(col_1, col_2, col_3)

А по диагоналям сделайте самостоятельно – это несложно.

Для второй функции я приведу такой короткий пример. Предположим, мы делаем игру «Сапер» и игровое поле также представлено в виде одномерного списка длиной NxN элементов:

N = 10
P = [0] * (N*N)

Далее, если в этом списке появляется хотя бы одна мина (отметим ее звездочкой):

P[4] = '*'

то игрок проигрывает. Чтобы узнать, наступил ли игрок на мину, удобно воспользоваться функцией any():

loss = any(map(lambda x: x == '*', P))
print(loss)

После запуска программы увидим значение True, то есть, игрок проиграл. А если мину поставить в комментарий и снова запустить, то увидим значение False.

Вот два простых примера, где удобно применять эти две функции any() и all().

Практика 14 · Часть I. Основы Python

Сортировка, типы и предикаты

Задания для закрепления темы · решений нет

Цели обучения

  • Выбирать между list.sort и sorted
  • Сортировать с пользовательскими функциями key
  • Различать isinstance и type
  • Выражать универсальные/экзистенциальные проверки через all / any

Задания

Задание 1. Отсортированная копия

Сложность: лёгкое

Реализуйте sorted_desc(nums: list[int]) -> list[int]: вернуть новый список, отсортированный по убыванию; исходный не менять.

Требования:

  • Использовать sorted, не in-place sort

Пример:

a = [3, 1, 2]
sorted_desc(a)  # [3, 2, 1]
a               # [3, 1, 2]

Задание 2. Сортировка записей по полю

Сложность: лёгкое

Реализуйте sort_by_age(people: list[dict]) -> list[dict]: новый список, отсортированный по "age" по возрастанию, затем по "name" по возрастанию.

Требования:

  • key, возвращающий кортеж
  • Исходный список не менять

Пример:

sort_by_age([
    {"name": "Bob", "age": 30},
    {"name": "Ann", "age": 30},
    {"name": "Zoe", "age": 20},
])
# Zoe, Ann, Bob

Задание 3. Только числа

Сложность: среднее

Реализуйте only_numbers(items: list) -> list: оставить элементы, где isinstance(x, (int, float)) и не bool (учтите: bool — подкласс int).

Требования:

  • Использовать isinstance
  • Сохранять порядок

Пример:

only_numbers([1, True, 2.5, "x", False])  # [1, 2.5]

Задание 4. Один и тот же точный тип

Сложность: среднее

Реализуйте all_same_type(items: list) -> bool: True, если у каждого элемента точно тот же тип, что у первого (type(x) is type(items[0])). Пустой список → True.

Требования:

  • Использовать type, не только isinstance
  • Предпочтительно all(...)

Пример:

all_same_type([1, 2, 3])      # True
all_same_type([1, True])      # False
all_same_type([])             # True

Задание 5. Предикаты валидации

Сложность: среднее

Реализуйте:

  • all_positive(nums: list[float]) -> bool через all
  • any_negative(nums: list[float]) -> bool через any
  • Пустой список: all_positive → True, any_negative → False

Требования:

  • Без явных циклов for (выражения-генераторы внутри all/any допустимы)

Пример:

all_positive([1, 2, 3])   # True
any_negative([1, -1, 2])  # True

Задание 6. Глубокий сбор ключей

Сложность: сложное

Реализуйте sorted_keys_nested(data: dict) -> list[str]: вернуть отсортированный список всех ключей на любом уровне вложенности словарей. Вложенные значения-словари обходятся; не-словари игнорируются. Дубликаты ключей — один раз.

Требования:

  • Рекурсия или явный стек
  • Для вложенности использовать isinstance(v, dict)
  • Итоговый список отсортирован по алфавиту (предполагать строковые ключи)

Пример:

sorted_keys_nested({"b": 1, "a": {"c": 2, "a": 3}})
# ["a", "b", "c"]

Глава 15

Системы счисления, биты и random

Урок 63 · Часть I. Основы Python

Расширенное представление чисел. Системы счисления

Источник: python3-rasshirennoe-predstavlenie-chisel-sistemy-schisleniya

На этом занятии мы поговорим о различных форматах представления чисел в Python. Мы с вами неоднократно записывали в программе целые и вещественные значения в виде:

a = 500
b = 0.01

Это классическая запись. Еще существует экспоненциальная, когда числа записываются через степень десятки. Например, число:

500 = 5e2

Здесь e2 – это 10 в квадрате, то есть, 100 и оно умножается на 5, получаем 500. Причем, обратите внимание, число 500 представляется как вещественное, а не целое.

Аналогичным образом можно задать и второе значение 0,01 как:

0.01 = 1e-2

Здесь e-2 – это 10 в минус второй степени, то есть, 0,01 и все умножается на 1. Причем, единичка вначале строго обязательна – это формат записи чисел: сначала идет число, которое умножается на степень десятки.

Зачем это может понадобиться? Часто в инженерных задачах оперируют очень большими или очень малыми числами. Например, мы хотим указать шаг сходимости градиентного алгоритма как 10^-8. Записывать это число в классическом виде:

0,00000001

не очень удобно, да и легко ошибиться в количестве нулей. А вот в экспоненциальной форме все очень удобно и наглядно:

1e-8

И то же самое с очень большими числами, например, число Авогадро (примерно):

6,02 * 10^23 = 6.02e23

Прописывать такое число в классическом виде было бы совсем уж неудобно. Причем, вначале указано вещественное число 6,02, а затем, степень десятки. Так тоже можно делать.

Думаю, вы теперь знаете и сможете применять в своих программах экспоненциальную запись для чисел. Далее, мы с вами посмотрим, как можно представлять числа не только в десятичном формате, как это делали до сих пор, но и в других системах счисления: двоичной, шестнадцатеричной, восьмеричной. На самом деле их бесконечно много, так как можно придумать любую свою систему, скажем 132-ричную или еще какую, но на практике в 99% случаях ограничиваются именно такими.

Вкратце я напомню, что в десятичной системе счисления все цифры умножаются на степени десяток, в зависимости от позиции их написания. Например:

123 = 110^2 + 210^1 + 3*10^0

При этом, нам достаточно иметь десять различных цифр для представления любого числа.

Если же переходим к двоичной системе счисления, что все числа кодируются двумя символами: 0 и 1 – это все цифры двоичной системы (они называются битами). В результате, получаем, например, такие записи чисел в этой системе счисления:

001 = 02^2 + 02^1 + 12^0 = 1
1101 = 12^3 + 12^2 + 02^1 + 12^0 = 13
10001101 = 12^7 + 12^3 + 12^2 + 1*2^0 = 141

Я здесь сразу привел их перевод в десятичную систему счисления, учитывая, что все позиции цифр – это соответствующие степени двойки. Так вот, в Python мы можем записывать числа непосредственно в двоичной системе, следующим образом:

a = 0b001
b = 0b1101
c = 0b10001101

Причем, все числа получаются целыми. Если нужно определить отрицательное значение в двоичной записи, то проще всего перед его определением поставить унарный минус:

d = -0b1111

Конечно, первая реакция человека, впервые столкнувшегося с двоичным представлением чисел, зачем это нужно? Куда привычнее использовать десятичную запись. Да, и часто именно ее применяют. Но бывают ситуации, например, работа с числами на уровне бит, когда нам требуется включить или выключить отдельный бит числа, или проверить является ли текущий бит равным 1 (то есть включенным) или 0 (выключенным). Здесь двоичное представление нам помогает визуализировать такой процесс.

Следующая часто используемая система счисления – шестнадцатеричная. Здесь уже используется 16 различных обозначений. Для этого берут десять цифр из десятичной системы и еще первые шесть букв латинского алфавита:

0-9, A, B, C, D, E, F

Числа принимают уже такой вид:

1A, FB, C2DE

и т.п. Для перевода их в привычную нам десятичную систему, используется тот же принцип. Распишем их в виде:

1A = 116^1 + A16^0 = 26
FB = F16^1 + B16^0 = 240 + 11 = 251
C2DE = C16^3 + 216^2 + D16^1 + E16^0 = 49886

Здесь буква A соответствует значению 10 в десятичной системе, поэтому получаем значение 26. Буква F = 15, B = 11, поэтому имеем значение 251. А последнее число расшифруйте самостоятельно, должно получиться значение 49886.

В чем ценность шестнадцатеричной системы счисления? Она получила широкое распространение благодаря удобному представлению байтовых данных. Один байт – это восемь бит. Если разделить байт на две части, то получим по четыре бита. В эти четыре бита можно записать одно из шестнадцати значений, то есть, одно из значений шестнадцатеричной системы счисления:

0 – F

Получается, что два символа шестнадцатеричной системы, как раз описывают один байт. Причем, делают это независимо друг от друга.

Иллюстрация к уроку

При определенной тренировке, глядя на шестнадцатеричную запись, мы легко можем ее перевести и в десятичную и в двоичную системы.

В Python можно записывать числа сразу в шестнадцатеричной системе, например:

a = 0x1A

Причем, можно использовать не только заглавные, но и малые латинские буквы:

b = 0xde
c = 0xaa3f

Везде получаем целые положительные значения. Для определения отрицательных чисел можно вначале указать унарный минус:

d = -0x342

Последняя восьмеричная система, которую мы рассмотрим, работает по аналогии с предыдущими, только используется основания для восьмерки. Соответственно, для определения чисел достаточно восемь различных обозначений – используют первые восемь цифр десятичной системы. Сами числа записываются в виде:

27 = 28^1 + 78^0 = 23
54 = 58^1 + 48^0 = 44
775 = 78^2 + 78^1 + 5*8^0 = 509

Здесь я сразу перевел их в десятичный вид. Если нам нужно определить число в восьмеричной системе, то в Python используется следующая запись:

a = 0o27
b = 0o54
c = -0o775

Вот такие базовые системы счисления можно использовать в Python для определения чисел, а также применять экспоненциальную форму их представления.

Урок 64 · Часть I. Основы Python

Битовые операции И, ИЛИ, НЕ, XOR. Сдвиговые операторы

Источник: python3-bitovye-operacii-i-ili-ne-xor-sdvigovye-operatory

На этом занятии речь пойдет о битовых операциях над целыми числами. Начнем с самой простой битовой операции НЕ, которая выполняет инверсию бит в соответствии с такой табличкой:

x НЕ
0 1
1 0

Например, возьмем целое число:

a = 121

Чтобы посмотреть его битовое (двоичное) представление, можно воспользоваться функцией bin():

bin(a)

На выходе будет строка с битами этого десятичного числа. А теперь выполним инверсию его бит. Для этого в Python используется оператор ~ (тильда), которая записывается перед числом или переменной:

b = ~a

В результате переменная b стала отрицательной и принимает значение -122. Почему значение стало отрицательным и уменьшилось на -1? Смотрите, любое число кодируется набором бит. В Python – это довольно длинная последовательность:

0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 … 0 0 0 0 0 0 0 0

Самый старший бит отвечает за знак числа: 0 – положительное; 1 – отрицательное. Так вот, если взять десятичное число 0:

d = 0

и инвертировать все его биты:

~d

то мы получим число, состоящее из всех битовых единиц, а это есть не что иное, как десятичное значение -1. Мы здесь наглядно видим, как операция отрицания превращает число 0 в отрицательное и уменьшает его на -1. Так происходит со всеми целыми положительными числами:

d = 10
~d

И с отрицательными:

d = -10
~d

За счет инвертирования всех бит числа.

Битовая операция И

Следующая битовая операция И применяется уже к двум операндам (переменным или числам) со следующей таблицей истинности:

x1 x2 И
0 0 0
0 1 0
1 0 0
1 1 1

и реализуется через оператор & (амперсанд). Например, представим, что у нас есть два числа (две переменные):

flags = 5
mask = 4

Выполним для них битовую операцию И:

res = flags & mask

Переменная res ссылается на значение 4. Давайте посмотрим, почему получился такой результат. В соответствии с таблицей истинности результирующие биты будут следующими (перечислить). В итоге, переменная res получается равной 4.

flags 0 0 0 0 0 1 0 1
mask 0 0 0 0 0 1 0 0
res 0 0 0 0 0 1 0 0

Ну хорошо, разобрались, но зачем все это надо? Смотрите, если нам нужно проверить включен ли какой-либо бит числа (то есть установлен в 1), то мы можем это сделать с помощью битовой операции И, следующим образом:

if flags & mask == mask:
         print("Включен 2-й бит числа")
else:
         print("2-й бит выключен")

То есть, из-за использования операции И мы в переменной flags обнуляем все биты, кроме тех, что совпадают с включенными битами в переменной mask. Так как mask содержит только один включенный бит – второй, то именно проверку на включенность этого бита мы и делаем в данном случае.

Чтобы убедиться, что все работает, присвоим переменной flags значение 1:

flags = 1

и запустим программу. Теперь, видим сообщение, что 2-й бит выключен, что, в общем то, верно. Вот так, с помощью битовой операции И можно проверять включены ли определенные биты в переменных.

Также битовую операцию И используют для выключения определенных битов числа. Делается это, следующим образом:

flags = 13
mask = 5
flags = flags & ~mask

Что происходит здесь? Сначала выполняется инверсия бит маски, так как операция НЕ имеет более высокий приоритет, чем операция И. Получаем, что маска состоит из вот таких бит. Затем, идет операция поразрядное И, и там где в маске стоят 1 биты переменной flags не меняются, остаются прежними, а там где стоят в маске 0 – эти биты в переменной flags тоже становятся равными 0. За счет этого происходит выключение 2-го и 0-го битов переменной flags.

Кстати, последнюю строчку можно переписать и короче:

flags &= ~mask

Это будет одно и то же.

Битовая операция ИЛИ

Следующая битовая операция ИЛИ определяется оператором | и ее таблица истинности выглядит следующим образом:

x1 x2 ИЛИ
0 0 0
0 1 1
1 0 1
1 1 1

Обычно ее применяют, когда нужно включить отдельные биты переменной. Рассмотрим такую программу:

flags = 8
mask = 5
flags = flags | mask

Операция поразрядное ИЛИ, как бы собирает все единички из обеих переменных и получается такое своеобразное сложение (объединение).

flags 0 0 0 0 1 0 0 0
mask 0 0 0 0 0 1 0 1
flags 0 0 0 0 1 1 0 1

Кстати, в этом случае действительно получилось 8+5=13. Но это будет не всегда так, например, если:

flags = 9
flags |= mask

то результат тоже будет 13, так как операция ИЛИ включает бит вне зависимости был ли он уже включен или нет, все равно на выходе будет единица.

Битовая операция исключающее ИЛИ (XOR)

И последняя базовая операция работы с битами – исключающее ИЛИ (ее еще называют XOR). Она задается оператором ^ и имеет такую таблицу истинности:

x1 x2 XOR
0 0 0
0 1 1
1 0 1
1 1 0

Из нее видно, что данная операция позволяет переключать биты числа, то есть, если они были равны 0, то станут 1 и, наоборот, если были 1 – станут 0. Продемонстрируем это на таком примере:

flags = 9
mask = 1
flags = flags ^ mask

Здесь сначала получим значение 8, так как 0-й бит будет выключен.

flags 0 0 0 0 1 0 0 1
mask 0 0 0 0 0 0 0 1
flags 0 0 0 0 1 0 0 0

Но если повторить последнюю строчку:

flags ^= mask

то нулевой бит снова включится и переменная flags примет прежнее значение 9. Вот так, с помощью операции XOR можно переключать отдельные биты переменных.

Интересной особенностью операции XOR является отсутствие потерь данных при ее работе. Что это значит? Смотрите, какую бы маску мы не взяли, дважды примененная маска дает исходное число:

flags = 9
mask = 111
flags ^= mask
flags ^= mask

Этот эффект часто используют для шифрования информации. Например, так работает пароль архиватора zip. В нем пароль – это маска, которая накладывается на заархивированные данные. Чтобы восстановить их, необходимо ввести пароль и повторить наложение этой маски.

Вот мы с вами рассмотрели основные битовые операции, и обратите внимание, что все их можно записывать в таком виде:

Полная форма Краткая форма Приоритет
a = a & b a &= b 2 (И)
a = a b a
a = a ^ b a ^= b 1 (XOR)
~a 3 (НЕ)

Операторы смещения бит

И в заключение занятия рассмотрим еще два распространенных битовых оператора:

смещение бит вправо
<< смещение бит влево

Предположим, у нас имеется переменная:

x = 160

Ее битовое представление:

bin(x) # 10100000

Давайте сдвинем все эти биты вправо на один бит. Сделать это можно, следующим образом:

x = x >> 1

Теперь битовое представление числа:

bin(x) # 1010000

А значение равно 80. То есть, сдвигая биты вправо на один бит, мы разделили число на 2. Если сдвинуть на два бита вправо:

x = x >> 2

то это уже эквивалентно делению на 4. Давайте еще раз сдвинем на бит вправо:

x = x >> 1

будет пять, но 5 не делится на 2 нацело. Что же получится при смещении бит вправо? Смотрим:

x = x >> 1

Получаем значение 1. То есть, здесь, как бы дробная часть была отброшена. Действительно, один из битов был просто потерян, это и объясняет данный эффект.

По аналогии можно делать смещения влево:

x = x << 1

Это уже будет эквивалентно умножению на два. Или, так:

x = x << 3

Это эквивалентно умножению на 8 (два в кубе). И так далее. Операции смещения бит влево и вправо выполняют целочисленное умножение и деление кратное двум. Причем эти операции умножения и деления работают значительно быстрее, чем традиционные арифметические операции умножения и деления. Поэтому, разработчики различных алгоритмов для маломощных компьютеров стараются составить вычисления так, чтобы они базировались на сдвиговых операциях, исключая прямое умножение и деление.

Надеюсь, из этого занятия вы поняли, как работают битовые операции И, ИЛИ, НЕ, XOR, а также битовые операции сдвигов.

Урок 65 · Часть I. Основы Python

Модуль random стандартной библиотеки

Источник: python3-modul-random-standartnoy-biblioteki

На этом занятии речь пойдет о модуле random стандартной библиотеки. Еще раз отмечу, что в Python имеется множество предустановленных модулей, которые поставляются вместе с интерпретатором языка. Подробно обо всех их можно почитать на странице официальной документации:

https://docs.python.org/3/library/index.html

Здесь много разных модулей и, программируя на Python, вы так или иначе будете с ними знакомиться. Среди них есть и модуль random. Откроем страницу с его описанием и видим здесь множество различных функций для генерации случайных значений (а точнее, псевдослучайных, то есть, их, все же можно просчитать). Я расскажу о некоторых из функций этого модуля, которые наиболее часто используются на практике.

Вначале, для использования этого модуля, его нужно импортировать. Как это делать мы с вами уже подробно говорили. В самом простом случае, можно записать:

import random

И, далее, из пространства имен random можно выбирать самые разные функции этого модуля. Вначале я воспользуюсь функцией random():

a = random.random()
print(a)

Она при каждом вызове выдает случайное значение в диапазоне [0.0; 1.0). Обратите внимание, что числа подчиняются равномерному закону распределения, то есть, в диапазоне [0.0; 1.0) они могут принимать любое значение с равной вероятностью.

Иллюстрация к уроку

Другая похожая функция uniform(a, b) также генерирует случайные значения по равномерному закону, но в диапазоне от a до b:

a = random.uniform(1, 5)

Если нам нужно моделировать целочисленные случайные значения с тем же равномерным распределением, то можно использовать или функцию:

a = random.randint(-3, 7)   # [-3; 7]

или функцию randrange:

a = random.randrange(5)
b = random.randrange(-3, 10, 2)

Иллюстрация к уроку

Однако часто на практике требуются случайные величины с другим законом распределения – гауссовским (или, еще говорят, нормальным). Закон распределения имеет следующий вид и определяется двумя параметрами: математическим ожиданием (средним значением) и среднеквадратическим отклонением (мерой разброса относительно МО).

Иллюстрация к уроку

Особенность этих величин в том, что они чаще появляются в области МО и реже на более дальних расстояниях. Ценность этого распределения в том, что ему часто подчиняются многие реальные события: колебания цен на нефть, и различных товаров, шумы при радиопередачах, погрешности измерений различных значений и т.п. Это распределение окружает нас повсюду! И, конечно же, нужно уметь его моделировать. Для этого в Python существует функция gauss(mu, sigma):

a = random.gauss(0, 3.5)

Во второй части этого занятия я расскажу о функциях модуля random при работе с последовательностями. Предположим, у нас имеется список:

lst = [4, 5, 0, -1, 10, 76, 3]

и мы хотим выбрать из него один элемент случайным образом. Для этого можно воспользоваться функцией:

a = random.choice(lst)
print(a)

После запуска видим случайно выбранное значение из списка lst.

Следующая функция shuffle() перемешивает элементы списка случайным образом:

random.shuffle(lst)
print(lst)

Причем, меняет сам список, поэтому работает только с изменяемыми коллекциями.

Третья функция sample() возвращает новый список с указанным числом неповторяющихся элементов, выбранных случайным образом из списка:

a = random.sample(lst, 3)
print(a)

Разумеется, максимальное число элементов не может превышать число элементов в списке lst.

И последнее, что я хочу отметить в работе с псевдослучайными величинами, это возможность формировать одинаковые случайные последовательности чисел при каждом новом запуске программы. О чем здесь речь? Смотрите, если мы, например, генерируем несколько целочисленных случайных величин:

a = [random.randint(0, 10) for i in range(20)]
print(a)

То, запуская программу снова и снова, будем видеть разные случайные значения в списке a. Часто именно так и должен работать генератор случайных величин. Но иногда требуется, чтобы каждый запуск программы приводил к одной и той же последовательности случайных чисел. Например, для повторяемости результатов экспериментов на разных компьютерах. Для этого нужно зафиксировать, так называемое, зерно генератора случайных чисел с помощью функции seed(), следующим образом:

random.seed(123)

Здесь число 123 – это, как раз и есть значение зерна. Оно задает начальное состояние датчика чисел, поэтому, запуская программу, каждый раз будем видеть одни и те же случайные числа в списке a.

Если выбрать другое значение зерна, то изменится и последовательность СВ. Это бывает очень удобно, не сохраняя последовательность случайных чисел, указывать только значение зерна для их генератора.

Вот такие возможности существуют в библиотеке random, которые следует знать и, по мере необходимости, применять на практике.

Практика 15 · Часть I. Основы Python

Системы счисления, биты и random

Задания для закрепления темы · решений нет

Цели обучения

  • Переводить между основаниями (bin, hex, int(s, base))
  • Осознанно использовать & | ^ ~ << >>
  • Генерировать воспроизводимую случайность через random.seed

Задания

Задание 1. Разбор int из заданного основания

Сложность: лёгкое

Реализуйте parse_int(text: str, base: int) -> int как обёртку над int(text, base). Возбудить ValueError, если base не в 2..36.

Требования:

  • Проверять основание до вызова int
  • Префиксы принимать только если задокументируете; для ясности предпочтительны «голые» цифры

Пример:

parse_int("ff", 16)  # 255
parse_int("1010", 2) # 10

Задание 2. Формат тройки оснований

Сложность: лёгкое

Реализуйте format_bases(n: int) -> tuple[str, str, str]: вернуть строки (bin, oct, hex) без префиксов 0b/0o/0x, hex в нижнем регистре. При отрицательном n возбудить ValueError.

Требования:

  • Использовать bin, oct, hex и срезать префиксы
  • n == 0 → ("0", "0", "0")

Пример:

format_bases(255)  # ("11111111", "377", "ff")

Задание 3. Флаги через биты

Сложность: среднее

Определите константы: READ = 1, WRITE = 2, EXEC = 4.

Реализуйте:

  • add_flag(mask: int, flag: int) -> int
  • remove_flag(mask: int, flag: int) -> int
  • has_flag(mask: int, flag: int) -> bool

Требования:

  • Использовать |, & и ~ / очистку в стиле XOR (mask & ~flag)
  • Не использовать списки прав

Пример:

m = add_flag(0, READ | WRITE)
has_flag(m, READ)   # True
m = remove_flag(m, WRITE)
has_flag(m, WRITE)  # False

Задание 4. Степень двойки

Сложность: среднее

Реализуйте is_power_of_two(n: int) -> bool с помощью битового приёма (n > 0 and n & (n - 1) == 0).

Требования:

  • Обязательна битовая проверка (без циклов с делением)

Пример:

is_power_of_two(8)  # True
is_power_of_two(12) # False

Задание 5. Упаковка / распаковка RGB

Сложность: среднее

Реализуйте:

  • pack_rgb(r: int, g: int, b: int) -> int — упаковать в 0xRRGGBB (r,g,b в 0..255)
  • unpack_rgb(color: int) -> tuple[int, int, int]

Требования:

  • Использовать сдвиги и маски (<<, >>, & 0xFF)
  • Проверять диапазоны каналов; при выходе за диапазон возбуждать ValueError

Пример:

pack_rgb(255, 0, 128)           # 0xFF0080
unpack_rgb(0xFF0080)            # (255, 0, 128)

Задание 6. Воспроизводимый пароль

Сложность: сложное

Реализуйте generate_password(length: int, seed: int | None = None) -> str:

  • Алфавит: заглавные, строчные, цифры
  • Если seed не None, сначала вызвать random.seed(seed)
  • Использовать random.choice

Также реализуйте estimate_collision(n_bits: int) -> int: приблизительная оценка числа выборок по birthday bound int(2 ** (n_bits / 2)) для демонстрации случайности vs битового пространства (чистая математика, без random).

Требования:

  • length >= 1, иначе ValueError
  • Одинаковые (length, seed) → одинаковый пароль

Пример:

generate_password(8, seed=42)  # deterministic string of len 8
estimate_collision(32)         # 65536

Глава 16

Аннотации типов

Урок 66 · Часть I. Основы Python

Аннотация базовыми типами

Источник: python3-annotaciya-bazovymi-tipami

На нескольких последующих занятиях мы поговорим об аннотации типов. Что это такое и зачем это нужно? Я напомню, что в Python тип переменной (ссылки) определяется типом объекта, на который она ссылается. То есть, динамически. Отсюда и пошло название динамическая типизация. Например:

cnt = 0             # тип int
msg = "hello"       # тип str
lst = [1, 2, 3]     # тип list

Мало того, мы можем запросто присваивать другие типы данных этим же переменным:

cnt = -5.3          # тип float
msg = 0             # тип int

и никаких ошибок не будет. Все благодаря тому, что переменные – это ссылки на другие объекты, сами по себе они не хранят присваиваемые данные. Но что если в программе мы хотим явно указать, что, например, переменная cnt работает исключительно с целыми значениями? С типом int. Как это сделать? Очень просто. Если мы после переменной cnt поставим двоеточие, а затем укажем ожидаемый тип данных, на который она должна ссылаться по программе, например, int:

cnt: int
cnt = 0

то в строчке программы, где происходит присвоение не целого значения:

cnt = -5.3          # тип float

интегрированная среда подсветит число -5.3. Это и есть пример аннотации типов и работы статического анализатора , который проверяет на соответствие указанным типам. При наведении курсора на подсветку увидим сообщение:

Expected type ‘int’, got ‘float’ instead

Но обратите внимание, программа при этом выполнится без ошибок. То есть, аннотация типов носит информационный характер, на ход выполнения программы она никак не влияет.

Так все же, для чего была придумана аннотация типов и с какой версии языка Python ее можно использовать? Сначала отвечу на вторую часть вопроса. Активно аннотации стали внедряться, начиная с версии Python 3.5, и продолжают совершенствоваться до сих пор (на момент записи видео – это версия Python 3.10). А теперь каким целям она служит?

  • Для удобства восприятия стороннего кода.
  • Для удобства редактирования кода, когда IDE «подсказывает» атрибуты указанного типа переменных.
  • Для отслеживания некоторых явных ошибок на уровне несоответствия типов.

Вообще, тема аннотаций гораздо объемнее, чем может показаться на первый взгляд. Поэтому мы затронем лишь базовые моменты, которые используются примерно в 90% случаях. Ну а за деталями, как всегда, можно обратиться к официальной документации:

https://docs.python.org/3/library/typing.html

Вернемся к строчкам аннотирования переменной cnt. Здесь можно сразу выполнять инициализацию после указания желаемого типа:

cnt: int = 0

Если присвоить другой тип данных:

cnt: int = 0.5

то значение 0.5 будет подсвечено, но программа, по-прежнему, выполнится без ошибок. И так мы можем делать с любыми переменными и любыми типами данных, включая и свои собственные (например, классы).

Аннотация типов в функциях

Конечно, для отдельных переменных программы аннотация применяется не часто. Обычно ее можно встретить при объявлении функций. Давайте посмотрим, как это делается.

Предположим, мы определяем функцию для умножения некоторого числа на два, следующим образом:

def mul2(x):
    return x * 2

И, затем, разумеется, можем вызвать эту функцию:

res = mul2(5)
print(res)

Но здесь в качестве аргумента можно передать не только число, а, например, список:

res = mul2([5])

или строку:

res = mul2("5")

При этом программа никаких ошибок выдавать не будет, но вместо умножения числа на два, увидим размножение элементов списка или символов строк. Если предполагается в качестве аргументов этой функции передавать только числа, то как раз это можно описать с помощи аннотации параметров функции, например, так:

def mul2(x: int):
    return x * 2

Смотрите, теперь в вызове:

res = mul2("5")

интегрированная среда нам подсвечивает аргумент “5”. Конечно, программа по-прежнему выполнится без ошибок, но теперь программист видит, что с аргументом функции что то не так. Если же записать целое число:

res = mul2(5)

то подсветка пропадет, т.к. типы совпадают.

Еще один плюс такого аннотирования – это подсказки интегрированной среды в виде набора атрибутов, присущих тому или иному типу. Например, если оставить только объявление функции без аннотирования:

def mul2(x):
    return x * 2

То, записывая внутри функции «x.», мы увидим лишь общие атрибуты. Если же добавить аннотацию:

def mul2(x: float):
    return x * 2

то появятся атрибуты для типа float. Это дополнительное удобство, который дает анализатор IDE.

Кстати, если нужно посмотреть, какие параметры функции как аннотированы, то можно обратиться к магической коллекции annotations, которая теперь есть у каждой функции:

print(mul2.__annotations__)

Увидим в консоли следующий словарь:

{‘x’: <class ‘float’>}

Если в функцию mul2 добавить еще один параметр, например, так:

def mul2(x: float, y):
    return x * y

то словарь annotations не изменится, так как второй параметр не аннотирован. Давайте добавим аннотацию и для него:

def mul2(x: float, y: int):
    return x * y

Теперь видим два ключа и два значения:

{‘x’: <class ‘float’>, ‘y’: <class ‘int’>}

Причем аннотации не мешают нам определять параметры со значениями по умолчанию. Мы по-прежнему можем использовать запись вида:

def mul2(x: float, y: int = 2):
    return x * y

Тогда при передаче только одного первого аргумента, значение y будет принимать число 2, прописанное по умолчанию.

Последнее, что осталось – это определить аннотацию для возвращаемого значения. Для этого после круглой скобки ставится стрелочка -> и указывается возвращаемый тип:

def mul2(x: float, y: int) -> float:
    return x * y

В результате в коллекции annotations появился ключ ‘return’ со значением float:

{‘x’: <class ‘float’>, ‘y’: <class ‘int’>, ‘return’: <class ‘float’>}

Если же функция ничего не возвращает (на самом деле она будет возвращать None), то указывается значение None:

def show_x(x: float) -> None:
    print(f"x = {x}")

Вот так в самом простом варианте с использованием базовых типов выполняется аннотирование либо для отдельных переменных, либо для параметров функции и возвращаемого значения.

Модуль typing и типы Union, Optional, Any, Final

Если внимательно посмотреть на нашу функцию mul2(), то по идее вполне допустимо, чтобы параметры x и y принимали как тип int, так и тип float. Как сделать такую составную, более сложную аннотацию типов? Для этого можно воспользоваться специальными типами из модуля typing:

from typing import Union, Optional, Any, Final

Давайте рассмотрим их по порядку. Первый тип Union позволяет комбинировать несколько разных типов в один, образуя составной тип. Например, это можно сделать так:

def mul2(x: Union[int, float], y: Union[int, float]) -> Union[int, float]:
    return x * y

То есть мы в квадратных скобках прописываем через запятую те типы, которые ожидаем увидеть у параметров x, y, а также у возвращаемого значения функции.

Сразу отмечу, что с версии Python 3.10 такое объединение типов в аннотациях можно записывать с новым синтаксисом:

def mul2(x: int | float, y: int | float) -> Union[int, float]:
    return x * y

Но вернемся к прежней записи и здесь:

Union[int, float]

фактически, определяет новый объект – новый тип данных. А раз это так, то мы можем сформировать переменную на этот объект следующим образом:

Digit = Union[int, float]

и, затем использовать при типизации:

def mul2(x: Digit, y: Digit) -> Digit:
    return x * y

В ряде случаев, такой текст программы становится более читабельным. Хотя, усердствовать в этом тоже не стоит, т.к. программисту придется искать определение Digit и понимать, что оно означает.

Следующий тип Optional позволяет указать один какой-либо тип данных и еще автоматически добавляется тип None. Например:

Str = Optional[str]

эквивалентно

StrType = Union[str, None]

Этот случай выделили отдельно в тип Optional, т.к. такая комбинация с None довольно часто используется на практике. Например, объявим функцию show_x, у которой второй параметр descr по умолчанию будет принимать значение None:

def show_x(x: float, descr: Optional[str] = None) -> None:
    if descr:
        print(f"{descr} {x}")
    else:
        print(f"x = {x}")

Если теперь при вызове функции show_x() указать один аргумент:

show_x(55.6768)

то отработает блок else, а если указать два аргумента:

show_x(55.6768, 'x:')

то отработает первый блок по условию. Если же во втором аргументе указать не строку, а число:

show_x(55.6768, 10)

то интегрированная среда подсветит его из-за несоответствия ожидаемого типа данных. То есть, Optional введен для удобства, чтобы в Union не писать два типа, один из которых None.

Следующий тип Any означает буквально любой тип данных. Он используется, если параметр или переменная или возвращаемое значение функции может принимать любой тип. Или же, мы попросту не можем указать какой-либо конкретный тип данных, т.к. он нам неизвестен. Записывается такая нотация следующим образом:

def show_x(x: Any, descr: Optional[str] = None) -> None:
    if descr:
        print(f"{descr} {x}")
    else:
        print(f"x = {x}")

И, по сути, она эквивалентна поведению по умолчанию, когда мы не прописываем совсем никаких типов.

Наконец, последний тип Final появился в версии Python 3.10 и служит для отметки констант в программе. Например, если прописать:

MAX_VALUE: Final = 1000

то при попытке позже поменять это значение:

MAX_VALUE = 2000

интегрированная среда нам подсветит эту переменную с указанием, что идет попытка изменить константную переменную. При этом программа отработает без ошибок.

На этом мы завершим первое занятие по аннотации типов. На следующем продолжим эту тему и посмотрим, как описывать типы для различных коллекций языка Python.

Урок 67 · Часть I. Основы Python

Аннотации типов коллекций

Источник: python3-annotacii-tipov-kollekciy

На предыдущем занятии мы с вами увидели, как можно аннотировать отдельные переменные и функции простыми базовыми типами:

int, float, str, bool и т. п.

Давайте теперь посмотрим, как делать аннотацию для коллекций языка Python:

list, tuple, dict, set

Аннотация списков

Казалось бы, нет ничего проще. Достаточно также указать нужный нам тип, например, у переменной:

lst: list = [1, 2, 3]

и аннотация готова. И в целом да. В самом простом варианте мы так вполне можем сделать. Но обратите внимание, в этой аннотации нет никаких указаний на тип элементов списка. Поэтому можно прописать и числа, и строки:

lst_str: list = ['1', '2', '3']

и вообще любые типы данных. Интегрированная среда нам не выдаст никаких предупреждений. А вот если вместо списка записать, например, кортеж:

lst: list = (1, 2, 3)

то тогда уже увидим подсветку с предупреждением. То есть, тип list в аннотации отвечает только за определение списка. Типы элементов, при этом, могут быть любыми.

Но что если нам нужно дополнительно в аннотации указать и тип элементов списка? Начиная с версии Python 3.9, это можно сделать с помощью все того же базового типа list следующим образом:

lst: list[int] = [1, 2, 3]

Здесь в квадратных скобках указывается тип элементов списка. Подразумевается, что все элементы списка имеют единый тип данных. Так чаще всего предполагается использование списков в языке Python.

Если указать другой тип, например, str:

lst: list[str] = [1, 2, 3]

Увидим подсветку кода. Но, как только в списке оказывается хотя бы один строковый элемент:

lst: list[str] = ['1', 2, 3]

подсветка пропадает. Вот это особенность работы данной аннотации в PyCharm. Но, забегая вперед, скажу, что для языка Python есть довольно полезный модуль mypy, с помощью которого можно строже оценивать корректность программы для приведенной аннотации типов. И он находит все несоответствия. О модуле mypy речь пойдет в следующем занятии.

Вернемся к нашей нотации списка list[str]. Записывать ее в таком виде можно только, начиная с версии Python 3.9 и выше. Если версия вашего интерпретатора ниже, то для достижения того же результата придется импортировать из модуля typing следующие типы:

List, Tuple, Dict, Set

from typing import List, Tuple, Dict, Set

а, затем, вместо list прописать List:

lst: List[str] = [1, 2, 3]

Эта конструкция работает абсолютно так же, как и типизация через list. Но List и другие подобные типы считаются устаревшими и в новых версиях лучше избегать такого способа обозначения.

Аннотация кортежей

С кортежами все в целом так же, как и со списками. Единственное ключевое отличие – это независимое указание типов для всех элементов кортежа. Например:

address: tuple[int, str] = (1, 'proproprogs.ru')

Возможно, здесь у вас возникает вопрос: почему у списка мы указываем один тип для всех элементов, а у кортежа для каждого? Как вы помните, кортеж – это неизменяемый тип данных. В частности, мы не можем добавлять или удалять элементы. Поэтому их число полагается известным и фиксированным. Часто кортежи в Python используются для группировки каких-либо данных в единый объект. Например, информация по книге может быть представлена в виде кортежа:

book: tuple[str, str, int]
book = ('Балакирев С.М.', 'Аннотация типов', 2022)

И мы наперед знаем какие данные и в каком порядке предполагается хранить. Поэтому прописать аннотацию для всех его элементов не представляет особого труда. И в дальнейшем она будет служить хорошей подсказкой для программиста.

Конечно, если вам понадобится аннотировать кортеж с произвольным числом элементов, то это можно сделать так:

elems: tuple[int, ...]

И тогда все следующие строчки:

elems = (1,)
elems = (1, 2)
elems = (1, 2, 3)

будут корректны для этой аннотации.

Я думаю, вы уже догадались, что для версий языка Python ниже 3.9 следует вместо tuple использовать тип Tuple, если мы хотим дополнительно указывать тип данных:

book: Tuple[str, str, int]
book = ('Балакирев С.М.', 'Аннотация типов', 2022)

Но с версии 3.9 лучше использовать стандартный тип tuple с квадратными скобками.

Аннотация словарей и множеств

Аналогичным образом выполняется аннотация словарей. Так как словари – изменяемый тип данных и число их элементов наперед не определено, то при аннотировании указываются лишь тип ключа и тип значения. Например:

words: dict[str, int] = {'one': 1, 'two': 2}

Или, для версий Python ниже 3.9:

words: Dict[str, int] = {'one': 1, 'two': 2}

То есть, эта аннотация ведет себя так же, как и при аннотировании списков.

И то же самое для множеств:

persons: set[str] = {'Сергей', 'Михаил', 'Наталья'}

или для Python ниже 3.9:

persons: Set[str] = {'Сергей', 'Михаил', 'Наталья'}

Здесь также указывается единый тип для всех элементов множества. Хотя подсветка будет появляться только тогда, когда все элементы множества или словаря не соответствуют указанному типу. Но модуль mypy находит все эти несоответствия.

Комбинирование типов

Разумеется, все приведенные способы типизации можно использовать не только для отдельных переменных, но и при объявлении функций. Например, так:

def get_positive(digits: list[int]) -> list[int]:
    return list(filter(lambda x: x > 0, digits))
 
 
print(get_positive([1, -2, 3, 4, -5]))

И, смотрите, в аннотации указан один тип данных int, который ожидается увидеть у элементов списка. А что если мы собираемся хранить в списке и целые и вещественные числа. Как тогда определить аннотацию? Все очень просто. Для этого нам понадобится определить составной тип, используя Union из модуля typing:

def get_positive(digits: list[Union[int, float]]) -> list[Union[int, float]]:
    return list(filter(lambda x: x > 0, digits))

То есть, внутри квадратных скобок можно прописывать любые типы, образуя вложенные конструкции. Я напомню, что начиная с версии Python 3.10, эту же нотацию можно определить и так:

list[int | float]

Такой вариант рекомендуемый, если позволяет версия.

Давайте еще немного усложним аннотацию. Предположим, что по умолчанию параметр digits должен принимать значение None. Мы уже знаем, что для этого следует воспользоваться типом Optional модуля typing. Получим:

def get_positive(digits: Optional[list[Union[int, float]]] = None) -> list[Union[int, float]]:
    return list(filter(lambda x: x > 0, digits))

И такие комбинации можно делать сколь угодно глубокие. Только здесь возникает проблема с визуальным восприятием таких конструкций. Чтобы было нагляднее можно воспользоваться алиасами (переменными на те или иные типы). Например, вначале объявить алиас:

Digit = Union[int, float]

А, затем, прописать его при аннотировании:

def get_positive(digits: Optional[list[Digit]] = None) -> list[Digit]:
    return list(filter(lambda x: x > 0, digits))

Так воспринимается гораздо лучше. Разумеется, алиасы можно было бы и дальше определять, например:

def get_positive(digits: Optional[ListDigits] = None) -> ListDigits:
    return list(filter(lambda x: x > 0, digits))

Но увлекаться этим не стоит. Иначе, программисту постоянно придется искать определения алиасов и смотреть, что за типы в них прописаны. Во всем должна быть мера.

Аннотации вызываемых объектов (Callable)

В заключение этого занятия отмечу еще один тип Callable из модуля typing, который позволяет аннотировать вызываемые объекты. Часто это обычные функции, которые передаются как параметры. Давайте я приведу следующий пример. Пусть у нас имеется функция, которая из ряда целых чисел указанного диапазона выбирает числа по заданному критерию и формирует список:

def get_digits(flt: Callable[[int], bool], lst: Optional[list[int]] = None) -> list[int]:
    if lst is None:
        return []
 
    return list(filter(flt, lst))

Здесь первый параметр отмечен как вызываемый тип (Callable), у которого ожидается целочисленный аргумент и булево возвращаемое значение. Затем, мы можем воспользоваться этой функцией следующим образом:

def even(x):
    return bool(x % 2 == 0)
 
 
print(get_digits(even, [1, 2, 3, 4, 5, 6, 7]))

Увидим отображение списка только из четных значений. Но если поменять функцию even так, чтобы она возвращала не булево значение, а строку:

def even(x):
    return str(x % 2 == 0)

То появится подсветка кода из-за несоответствия возвращаемого типа и того, что указан в аннотации.

В общем случае тип Callable описывается по синтаксису:

Callable[[TypeArg1, TypeArg2, …], ReturnType]

Например, если нужно аннотировать функцию, у которой нет параметров и она ничего не возвращает:

def hello_callable():
    print("Hello Callable")

То это будет выглядеть так:

Callable[[], None]

Надеюсь, из этого занятия вы поняли, как выполнять аннотирование различных коллекций языка Python.

Урок 68 · Часть I. Основы Python

Аннотации типов на уровне классов

Источник: python3-annotacii-tipov-na-urovne-klassov

На предыдущем занятии мы с вами в целом рассмотрели различные способы аннотаций отдельных переменных и функций. Здесь же посмотрим на аннотацию на уровне классов.

Если вы пока еще не знакомы с классами языка Python, то советую прежде изучить курс по ООП на Python, а потом вернуться к этому занятию. Этот материал будет интересен тем, кто уже знает, что такое классы и объекты.

https://www.youtube.com/playlist?list=PLA0M1Bcd0w8zPwP7t-FgwONhZOHt9rz9E

Итак, давайте рассмотрим простую аннотацию, например, типом dict:

tr: dict = {'car': 'машина'}

В действительности, здесь dict – это класс, который определяет работу со словарем. А имя класса воспринимается, как название типа. Значит, при аннотации мы можем указывать любые классы в том числе и object – класс, от которого неявно наследуются все классы в Python 3. Давайте это сделаем и посмотрим к чему приведет:

x: object = None
x = "123"
x = 123

Смотрите, мы совершенно спокойно можем прописывать любые типы данных, унаследованные от object, и интегрированная среда нам не выдаст никаких предупреждений. Почему так произошло? Дело в том, что к базовому типу object можно привести любой другой тип, который от него наследуется. А это практически все типы данных в Python. Поэтому строки, числа и любые другие стандартные объекты допускается присваивать переменной x без нарушения данной аннотации.

Или такой пример. Объявим два класса:

class Geom: pass
class Line(Geom): pass

и аннотируем переменную типом Geom:

g: Geom

Далее, присвоим этой переменной объект класса Line:

g = Line()

Как видите интегрированная среда не подсвечивает код, значит, данные соответствуют типу, указанному при аннотации – базовому классу Geom. А если убрать наследование у класса Line:

class Line: pass

то сразу появляется подсветка, т.к. теперь типы Line и Geom независимы.

Все эти примеры показывают, как именно аннотация типов учитывает иерархию наследования классов при проверке корректности присваиваемых данных.

Отличие между object и typing.Any

Учитывая все сказанное, внимательный слушатель может спросить: а в чем отличия между типом object и типом Any из модуля typing? Если все типы данных в Python наследуются от object, значит это эквивалентно использованию типа Any? Почти. Но есть один нюанс. Его можно сформулировать так:

Тип Any совместим с любым другим типом, а тип object – ни с каким другим.

Давайте я поясню смысл этой фразы на конкретном примере. Допустим, у нас имеется некая переменная аннотированная типом Any:

a: Any = None

А, затем, мы определим еще одну переменную с аннотацией типа str:

s: str

После этого можно совершенно спокойно присвоить первую переменную второй:

s = a

Подсветки кода, т.е. каких-либо предупреждений не будет. Но, если вместо Any прописать object:

a: object = None

то появляется подсветка, т.к. тип object не совместим с типом str. То есть, с точки зрения приведенной аннотации будет неверным присваивать переменной типа str переменную типа object. Потому что str наследуется от object, а не наоборот. А вот если бы типы были записаны в другом порядке:

a: str = '123'
s: object
s = a

то никаких предупреждений не возникало бы. Когда же мы указываем Any, то совершенно не имеет значения какой тип будет присвоен этой переменной или куда она далее будет присваиваться:

a: Any = '123'
s: object
s = a

Any – это эквивалент отключения проверки типов, то есть, поведение статического анализатора по умолчанию, словно никакая типизация не была указана. Однако, через Any мы явно показываем, что переменная может ссылаться на произвольный тип данных. Вот в этом отличие между Any и object.

Модуль mypy

До сих пор мы непосредственно в интегрированной среде смотрели на подсветку кода и понимали, что где то нарушили аннотацию типов. Но доверять целиком и полностью такой анализ интегрированной среде неправильно. Вполне могут возникать случаи, когда она не подсвечивает нарушения типов и я вам это уже демонстрировал. Чтобы строже оценивать корректность программы с точки зрения аннотации типов, часто на практике используют специальный модуль:

mypy

Мало того, этим модулем можно воспользоваться, если под рукой нет интегрированной среды, а неточности как-то выявить нужно. Подробнее о нем можно почитать на странице официальной документации:

https://mypy.readthedocs.io/en/stable/

Чтобы воспользоваться этим модулем его нужно вначале установить. Делается это уже известной вам командой:

pip install mypy

После установки в терминале достаточно записать команду:

mypy <имя файла>

В моем случае программа находится в файле main.py, а сам файл хранится в текущем рабочем каталоге. Поэтому команда примет вид:

mypy main.py

Если нужно анализировать сразу несколько файлов, то они прописываются через пробел.

После запуска команды здесь же в терминале видим строчки, в которых нарушена типизация. Все достаточно просто и удобно.

Аннотация с помощью Type и TypeVar

Но давайте вернемся непосредственно к теме «аннотация типов» и предположим, что у нас объявлены два класса:

class Geom: pass
class Point2D(Geom): pass

и некая функция, которая должна создавать экземпляры переданных ей классов, унаследованных от Geom:

def factory_point(cls_geom):
    return cls_geom()

Обратите внимание, здесь предполагается, что параметр cls_geom будет ссылаться на сам класс, а не объект класса. Почему это важно, вы сейчас увидите. Используя текущие знания по аннотации типов, первое, что приходит в голову – это прописать в функции следующие определения:

def factory_point(cls_geom: Geom) -> Geom:
    return cls_geom()

Но нам здесь интегрированная среда сразу подсвечивает фрагмент cls_geom(). Почему это произошло? Как раз по той причине, что аннотация :Geom подразумевает, что параметр cls_geom будет ссылаться на объекты класса Geom, а не на сам класс Geom. Вот это очень важно понимать, когда вы прописываете аннотации типов. Везде подразумеваются объекты тех типов, которые указываются. Но как тогда поправить эту ситуацию? Очень просто. Для этого существует специальный тип Type из модуля typing. Если мы перепишем аннотацию в виде:

def factory_point(cls_geom: Type[Geom]) -> Geom:
    return cls_geom()

то никаких нарушений уже не будет. Тем самым мы указали, что параметр cls_geom будет ссылаться непосредственно на класс Geom, а не его объекты. А далее, используя переменную cls_geom, создается объект этого класса и возвращается функцией.

Давайте теперь воспользуемся этой функцией. Если ее вызвать так:

geom = factory_point(Geom)
point = factory_point(Point2D)

то с аннотациями никаких конфликтов не будет. Но, если мы дополнительно аннотируем и переменные geom и point соответствующими типами:

geom: Geom = factory_point(Geom)
point: Point2D = factory_point(Point2D)

то во второй строчке появится подсветка кода. Очевидно это из-за того, что мы явно указываем ожидаемый тип Point2D, а в определении функции прописан тип Geom. И, так как Geom – базовый класса для Point2D, то возникает конфликт аннотаций.

Для исправления таких ситуаций в Python можно описывать некие общие типы с помощью класса TypeVar. Например:

T = TypeVar("T", bound=Geom)

Мы здесь объявили универсальный тип с именем T и сказали, что он должен быть или классом Geom или любым его дочерним классом. Далее, в самой функции, достаточно прописать этот тип:

def factory_point(cls_geom: Type[T]) -> T:
    return cls_geom()

и он будет автоматически вычисляться при вызове функции. Когда передается класс Geom, то T будет соответствовать этому типу, а когда передается Point2D – то тип T будет Point2D. И так далее. Вот смысл универсальных типов при формировании аннотаций.

Для полноты картины сразу отмечу здесь, что класс TypeVar можно использовать и в таких вариациях:

T = TypeVar("T")   # T – произвольный тип без ограничений
T = TypeVar("T", int, float)   # T – тип связанный только с типами int и float

Подробнее обо всем этом можно почитать в официальной документации. Но я не вижу большого смысла глубоко погружаться в эту тему, т.к. различные вариации данного класса используются на практике не часто.

Аннотация типов в классах

В заключение этой темы добавлю пару слов об аннотации типов внутри классов. В целом все делается практически также как и в случае с переменными и функциями. Давайте распишем класс Point2D следующим образом:

class Point2D:
    def __init__(self, x: int, y: int) -> None:
        self.x = x
        self.y = y

Обратите внимание, что параметр self не принято аннотировать. Также метод init всегда возвращает значение None.

Воспользоваться этим классом можно так:

p = Point2D(10.5, 20)

В этом случае первый аргумент будет подсвечен, т.к. не соответствует целому типу. Но программа отработает без ошибок. Главный вопрос здесь: существует ли аннотация типов у локальных атрибутов x, y объекта класса Point2D? Давайте проверим. Запишем команду:

p.x = '10'

и интегрированная среда нам не выдает никакой подсветки. Но если перейти в терминал и выполнить команду:

mypy main.py

то статический анализатор модуля mypy отметит две строчки. То есть, с точки зрения mypy в локальных атрибутах x, y ожидаются целые значения. Однако если нужно аннотировать атрибуты класса или его объектов, то лучше это явно прописать непосредственно в самом классе следующим образом:

class Point2D:
    x: int
    y: int
 
    def __init__(self, x: int, y: int) -> None:
        self.x = x
        self.y = y

В заключение этого занятия покажу еще одну особенность аннотации типов в классах. Объявим метод с именем copy():

class Point2D:
    x: int
    y: int
 
    def __init__(self, x: int, y: int) -> None:
        self.x = x
        self.y = y
 
    def copy(self) -> Point2D:
        return Point2D(self.x, self.y)

Предполагается, что он должен возвращать копию объекта класса Point2D. Однако просто так записать имя класса внутри самого класса не получится. Здесь есть два способа обойти этот момент. Первый (устаревший), заключить имя класса в кавычки, прописать его как строку:

    def copy(self) -> 'Point2D':
        return Point2D(self.x, self.y)

Но можно сделать лучше. Если импортировать из модуля future объект annotations:

from __future__ import annotations

то после этого можно убрать кавычки у имени класса:

    def copy(self) -> Point2D:
        return Point2D(self.x, self.y)

Вы спросите почему это явно не внедрили в новых версиях языка Python? Зачем требуется что то дополнительно импортировать? Ответ прост. Это сделано специально для обратной совместимости с более ранними версиями. Разработчики языка решили, что это важно. По крайней мере пока. Поэтому просто запомните этот обстоятельство.

Следует ли использовать аннотацию типов

На данный момент мы с вами рассмотрели основные возможности типизации данных в языке Python. Конечно, это далеко не все, что существует по этой теме, но в большинстве случаев данного материала вполне достаточно, чтобы описывать типы в ваших программах. И завершить я бы хотел краткими указаниями, когда и для чего следует вообще использовать инструмент аннотации типов.

Если вы пишите небольшие короткие программы, которые достаточно просто охватить взглядом, то как таковая аннотация мало чего добавляет в текст программы. Программист и так легко сможет понять какие данные куда передаются. Поэтому излишняя аннотация может даже ухудшить восприятие кода. На мой взгляд для небольших программ достаточно аннотировать ключевые функции или даже совсем ее не делать, как это было в ранних версиях языка и при этом программы воспринимались вполне нормально.

Если же пишется более-менее крупный проект, состоящий из нескольких модулей, то здесь грамотное аннотирование заметно упрощает понимание кода сторонними программистами. Да и сам автор программы спустя продолжительное время сможет быстро восстановить в памяти все нюансы ее работы. Здесь аннотация типов действительно играет положительную роль и ее стоит использовать. Однако во всем должна быть мера. Можно аннотациями так замусорить текст программы, что получим обратный эффект. Всегда следует помнить, что цель аннотирования – это упрощение восприятия текста программы. И, как только, аннотации начинают мешать – это верный признак усмирить свой энтузиазм и вернуться непосредственно к написанию кода. Увлекаться аннотацией типов не стоит.

Я думаю, что приведенный материал позволит вам теперь грамотно применять аннотацию типов в своих программах и будет действительно помогать лучше понимать программный код.

Практика 16 · Часть I. Основы Python

Аннотации типов

Задания для закрепления темы · решений нет

Цели обучения

  • Аннотировать параметры и возвращаемые типы встроенными типами
  • Аннотировать списки, словари, кортежи, optional и union
  • Добавлять простые аннотации атрибутов класса

Задания

Задание 1. Аннотированная арифметика

Сложность: лёгкое

Реализуйте с полными аннотациями:

def add(a: int, b: int) -> int: ...
def concat(a: str, b: str) -> str: ...

Требования:

  • Аннотации на параметрах и возвращаемых значениях
  • Поведение — обычный +

Задание 2. Приветствие с Optional

Сложность: лёгкое

Реализуйте greet(name: str, title: str | None = None) -> str:

  • Если title — None → "Hello, {name}"
  • Иначе → "Hello, {title} {name}"

Требования:

  • Использовать str | None (Python 3.10+) или Optional[str] из typing

Пример:

greet("Ann")             # "Hello, Ann"
greet("Ann", "Dr.")      # "Hello, Dr. Ann"

Задание 3. Сигнатуры коллекций

Сложность: среднее

Реализуйте аннотированные функции:

  • head(items: list[int]) -> int — первый элемент; пустой → возбудить ValueError
  • zip_dict(keys: list[str], values: list[int]) -> dict[str, int] — обрезать по меньшей длине
  • pair(a: int, b: str) -> tuple[int, str]

Требования:

  • Использовать встроенные дженерики (list[int] и т.п.)
  • Сигнатуры должны совпадать точно

Задание 4. Типизированный класс статистики

Сложность: среднее

Определите:

class RunningStats:
    count: int
    total: float

    def __init__(self) -> None: ...
    def add(self, value: float) -> None: ...
    def mean(self) -> float: ...  # ValueError if count == 0

Требования:

  • Аннотировать атрибуты на уровне класса и все методы
  • add обновляет count и total

Пример:

s = RunningStats()
s.add(2.0)
s.add(4.0)
s.mean()  # 3.0

Задание 5. Вложенный тип конфигурации

Сложность: среднее

Определите псевдонимы типов (или аннотированные структуры) и функцию:

UserId = int
User = dict[str, str | int]  # keys include at least "id", "name"

def index_users(users: list[User]) -> dict[UserId, User]:
    ...

Сопоставить "id" каждого пользователя со словарём пользователя. При дубликатах id побеждает последний.

Требования:

  • Явные аннотации на функции
  • Предполагать у каждого пользователя int "id" и str "name"

Задание 6. Мини-проверка с аннотациями

Сложность: сложное

Создайте модуль inventory.py:

class Item:
    sku: str
    qty: int
    price: float

    def __init__(self, sku: str, qty: int, price: float) -> None: ...
    def line_total(self) -> float: ...

def inventory_value(items: list[Item]) -> float: ...
def skus_in_stock(items: list[Item]) -> set[str]: ...  # qty > 0

Требования:

  • Все публичные API полностью аннотированы
  • Проверка типов в runtime не требуется (только аннотации)
  • Бонус: убедиться, что файл чист под уже используемым проверщиком типов (mypy/pyright), если он есть — устанавливать не обязательно

Глава 17

Match / case

Урок 69 · Часть I. Основы Python

Конструкция match/case. Первое знакомство

Источник: python3-konstrukciya-matchcase-pervoe-znakomstvo

В Python версии 3.10 появилась новая конструкция под названием match/case, которая позволяет достаточно гибко анализировать переменные на соответствие шаблонов и для найденного совпадения выполнять некоторые заданные операции. Данный оператор имеет следующий синтаксис:

match <переменная>:
case <шаблон_1>:
операторы
…
case < шаблон_n>:
операторы
case _:
иначе (default)

На первый взгляд, вроде понятно, только что означает здесь слово «шаблон»? Это и некоторые другие моменты мы, как раз, и будем постепенно раскрывать на занятиях по оператору match/case.

Давайте вначале запишем эту конструкцию в очень простом варианте:

cmd = "top"
 
match cmd:
    case "top":
        print("вверх")
    case "left":
        print("влево")
    case "right":
        print("вправо")
    case _:  # wildcard
        print("другое")
 
print("проверки завершены")

Смотрите, здесь есть некая переменная cmd на строку «top», затем, она указывается после оператора match, внутри которого записаны блоки case. После каждого case указано значение в виде строки. Как только значение переменной оказывается равным значению после case, то выполняются операторы внутри этого блока case и далее выполнение программы переходит к следующей строчке после match – функции print(“проверки завершены”).

То есть, как только выполняется один из блоков case, оператор match завершает свою работу. Соответственно, внутри match обязательно должен быть записан хотя бы один оператор case. А общее число блоков case может быть произвольным. Конечно, всегда следует помнить о читабельности программы и удобстве ее последующего редактирования.

Внутри каждого блока case должен быть хотя бы один оператор. Например, запись вида:

match cmd:
    case "top":
    case "left":
    case "right":
        print("вверх, влево или вправо")
    case _:  # wildcard
        print("другое")

приведет к синтаксической ошибке. Если нужно в одном блоке case учесть сразу несколько констант, это можно сделать с помощью оператора ‘|’ следующим образом:

match cmd:
    case "top" | "left" | "right":
        print("вверх, влево или вправо")
    case _:  # wildcard
        print("другое")

Обратите внимание на последний блок case с символом подчеркивания. Это, так называемый, wildcard символ. В Python мы его обычно используем, если по синтаксису нужно прописать переменную, но в программе она нам не нужна. В частности здесь блок case с переменной _ будет отрабатывать всегда, если не отработали все предыдущие блоки. То есть, это некий аналог условного оператора else в if. Например, если переменная:

cmd = "top2"

то мы увидим сообщения:

другое
проверки завершены

Как раз здесь отработал последний блок case.

Те из вас, кто знаком с другими языками программирования, например, С++ или Java, возможно сейчас смотрят на эту программу и думают, ага, так это же аналог конструкции switch/case для проверки переменных на равенство заданных констант. Но не спешите с выводами. В действительности оператор match/case гораздо более гибкий, чем switch/case и гибкость определяется тем, что после case прописывается не просто константа, а шаблон проверки. Сейчас используется простейший шаблон, когда мы сравниваем переменную cmd на равенство указанным после case значениям. Но вариаций здесь гораздо больше и об это мы сейчас пойдет речь.

Шаблоны сравнений оператора case

Вместо конкретных значений после оператора case можно записывать переменные. Например, так:

cmd = "top"
 
match cmd:
    case command:
        print(f"команда: {command}")

В результате при выполнении блока case будет создана переменная command (если ранее ее не было в программе) и ссылаться на то же значение, что и переменная cmd, то есть, на строку «top». Поэтому при выполнении программы увидим на экране сообщение:

команда: top

То есть, фактически, в блоке case выполняется присваивание:

command = cmd

и выводится значение переменной command в консоль. Причем, этот блок case будет выполняться всегда при любых значениях переменной cmd. Потому что такой шаблон не делает никаких проверок, он просто создает переменную command и присваивает значение переменной, указанной после оператора match. Причем, если после этого case прописать еще какой-либо, например:

match cmd:
    case command:
        print(f"команда: {command}")
    case "top":
        print("top")

то возникнет синтаксическая ошибка, связанная с тем, что первым указан блок case, перехватывающий все возможные варианты, и все другие case просто игнорируются. Поэтому такой общий шаблон можно указывать только последним:

match cmd:
    case "top":
        print("top")
    case command:
        print(f"команда: {command}")

И если здесь вместо переменной command прописать нижнее подчеркивание, то получим уже знакомый нам блок default (отбойник), который перехватывает все, что не вошло в предыдущие блоки:

match cmd:
    case "top":
        print("top")
    case _:
        print(f"другая команда")

Шаблоны проверки типов

Давайте теперь усложним наш шаблон и в первом блоке case будем перехватывать все строковые команды, то есть, те, которые записаны в виде строки. Сделать это можно следующим образом:

cmd = "top"
 
match cmd:
    case str() as command:
        print(f"строковая команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

Смотрите, после case записано str(). Мы привыкли такую запись воспринимать как создание или пустой строки или преобразование объекта в строку. Здесь же это не что иное, как проверка переменной cmd строковому типу. То есть, если переменная cmd является строкой, то только в этом случае выполнится этот блок case и будет создана переменная command, которая, как и ранее, ссылается на значение переменной cmd.

Обратите еще раз внимание на конструкцию «str() as command». Вначале идет проверка строкового типа переменной cmd, и если это так, то после ключевого слова as можно указать переменную, которая будет ссылаться на эту строку. Кстати, если нам нужна только проверка на строковый тип данных, то фрагмент «as command» можно не писать, например:

match cmd:
    case str():
        print(f"строковая команда")
    case _:  # wildcard
        print(f"другая команда")

Или, вместо «as command» можно написать:

match cmd:
    case str(command):
        print(f"строковая команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

Но выглядит это несколько путанно, так как в Python мы привыкли воспринимать такую конструкцию «str(command)», как преобразование объекта в строку. Поэтому предпочтительнее, на мой взгляд, использовать ключевое слово as.

По аналогии можно проверять и другие типы данных, например:

cmd = 10
 
match cmd:
    case str() as command:
        print(f"строковая команда: {command}")
    case int() as command:
        print(f"целочисленная команда: {command}")
    case bool() as command:
        print(f"булева команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

При выполнении этой программы будет выполнен второй блок case, так как переменная cmd целочисленная. Однако, если мы ей присвоим булево значение, например:

cmd = True

то снова отработает второй блок case, а не третий, как этого можно было бы ожидать. Почему так произошло? Я думаю, что многие из вас уже догадались, что проверка на тип данных в операторах case выполняется по принципу функции isinstance(), то есть, с учетом цепочки наследования типов. В частности, булевый тип наследуется от целочисленного, поэтому isinstance() и для целых чисел и для булевых значений возвращает True.

Разрешить эту проблему очень просто. Так как шаблоны в операторах case проверяются по порядку (сверху-вниз), то сначала следует поставить проверку на булевый тип, а потом на целочисленный:

match cmd:
    case str() as command:
        print(f"строковая команда: {command}")
    case bool() as command:
        print(f"булева команда: {command}")
    case int() as command:
        print(f"целочисленная команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

Тогда все проверки на тип данных будут проходить корректно. По аналогии мы можем делать проверку на любые типы данных, которые имеются в языке Python.

Guard (защитник)

Давайте сделаем еще один шаг усложнения наших шаблонов и предположим, что для целочисленных команд дополнительно нужно проверять, чтобы они были в диапазоне от 0 до 9 включительно. Для этого после определения переменной command можно прописать ключевое слово if и указать дополнительное условие. В нашем случае оно будет выглядеть так:

match cmd:
    case str() as command:
        print(f"строковая команда: {command}")
    case bool() as command:
        print(f"булева команда: {command}")
    case int() as command if 0 <= command <= 9:
        print(f"целочисленная команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

Теперь блок «case int() as command if 0 <= command <= 9» отработает только в том случае, если переменная cmd является целочисленной и значение переменной command (которая ссылается на переменную cmd) лежит в диапазоне [0; 9]. Причем, обратите внимание, оператор if будет отрабатывать после команды int(), то есть, после проверки на целый тип данных и после формирования переменной command. Поэтому если проверка дошла до if, то мы точно знаем, что определена переменная command и она имеет целочисленный тип. Проверка шаблона в case всегда выполняется строго слева-направо.

В конструкции match/case оператор if получил название guard (то есть, защитник). Условия в этом операторе можно прописывать по тем же правилам, что и в условных операторах if языка Python.

По аналогии можно прописать guard и для строковых команд, например, так:

cmd = "c_top"
 
match cmd:
    case str() as command if len(command) < 10 and command[0] == 'c':
        print(f"строковая команда: {command}")
    case bool() as command:
        print(f"булева команда: {command}")
    case int() as command if 0 <= command <= 9:
        print(f"целочисленная команда: {command}")
    case _:  # wildcard
        print(f"другая команда")

Если же какая-либо переменная может принимать несколько разных типов, например, int и float, то их можно записать через оператор ‘|’ следующим образом:

case int() | float() as command if 0 <= command <= 9:

И так далее, то есть здесь мы можем определять любые нужные нам условия в шаблонах оператора case.

Возможно, некоторым из вас на протяжении всего занятия не давал покоя вопрос, зачем все это нужно. У нас же в Python есть условные операторы if/elif/else и через них можно делать все те же самые проверки? Все верно. Конструкция match/case не дает нам ничего принципиально нового. Она лишь может упростить написание программного кода (при ее грамотном использовании), а также повысить читаемость текста программы. Это, наверное, главные причины, по которым данные операторы были добавлены в язык Python. Как мы дальше увидим, шаблоны в операторах case позволяют очень гибко, просто и удобно обрабатывать коллекции с данными, но об этом речь пойдет уже на следующем занятии.

Урок 70 · Часть I. Основы Python

Конструкция match/case с кортежами и списками

Источник: python3-konstrukciya-matchcase-s-kortezhami-i-spiskami

На предыдущем занятии был рассмотрен шаблон, содержащий константу, либо одну переменную. Часто этого бывает достаточно, если мы анализируем отдельные объекты, а не коллекции данных. Но давайте представим, что хотели бы обрабатывать информацию, представленную в виде кортежа или списка. Как в этом случае можно строить шаблоны в операторах case?

Для простоты определим кортеж из трех элементов, содержащий информацию о книге, например, такой:

cmd = ("Балакирев С.М.", "Python", 2000.78)

Здесь первые две строки – это автор и название книги, а последнее число – цена книги. Если сейчас прописать в операторе case одну переменную с проверкой на тип данных, например, так:

match cmd:
    case tuple() as book:
        print(f"кортеж: {book}")
    case _:  # wildcard
        print("непонятный формат данных")

то у нас отобразится в консоли строка:

кортеж: (‘Балакирев С.М.’, ‘Python’, 2000.78)

То есть, пока все работает ровно так, как на предыдущем занятии: формируется новая переменная book, которая ссылается на кортеж с данными о книге. Но, так как кортеж относится к упорядоченным типам данных (Sequence Types), то его можно распаковывать непосредственно в шаблонах следующим образом:

match cmd:
    case author, title, price:
        print(f"Книга: {author}, {title}, {price}")
    case _:  # wildcard
        print("непонятный формат данных")

Фактически, здесь используется уже знакомая нам конструкция распаковки последовательностей вида:

author, title, price = cmd

Причем, этот шаблон сработает только в том случае, если кортеж содержит ровно три элемента. Давайте ради интереса добавим четвертое значение – год издания:

cmd = ("Балакирев С.М.", "Python", 2000.78, 2022)

После запуска программы увидим строчку:

непонятный формат данных

то есть, шаблон не сработал. В нем мы явно прописали три элемента, а в переданном оказалось четыре. Поэтому перешли в блок default (отбойник).

Но как можно было бы сделать так, чтобы вне зависимости от числа элементов кортежа брать только первые три элемента? Очень просто! Снова вспоминаем правила распаковки последовательностей, где мы с вами использовали оператор * для чтения всех остальных элементов, если они есть:

match cmd:
    case author, title, price, *_:
        print(f"Книга: {author}, {title}, {price}")
    case _:  # wildcard
        print("непонятный формат данных")

То есть в *_ будут попадать все элементы, начиная с четвертого. Если же в кортеже всего три элемента, то шаблон также сработает, только в *_ не будет ни одного элемента.

Сразу отмечу, что все то же самое будет работать и со списками. Если вместо кортежа указать список:

cmd = ["Балакирев С.М.", "Python", 2000.78, 2022]

то на работе рассматриваемых шаблонов это никак не отразится, т.к. это все та же упорядоченная коллекция (Sequence Types).

Далее, если, например, дополнительно мы хотим ограничить размер кортежа или списка определенным числом элементов, то для этого можно записать guard, так же, как мы это делали для отдельных переменных:

match cmd:
    case author, title, price, *_ if len(cmd) < 6:
        print(f"Книга: {author}, {title}, {price}")
    case _:  # wildcard
        print("непонятный формат данных")

Но чтобы шаблон выглядел в более читаемом виде, допустимо использовать круглые или квадратные скобки:

case (author, title, price, *_) if len(cmd) < 6:

или

case [author, title, price, *_] if len(cmd) < 6:

Обратите внимание, здесь эти скобки не создают ни кортежей, ни списков. Это группирующие скобки, чтобы часть шаблона воспринималось как единое целое. Позже мы увидим, для чего они нужны.

Давайте теперь предположим, что мы хотели бы еще делать проверку на тип данных элементов списка cmd. Нет ничего проще. Для каждой отдельной переменной можно прописать:

case [str() as author, str() as title, float() as price, *_] if len(cmd) < 6:

Или сделать это только у некоторых переменных, например, у цены:

case [author, title, float() as price, *_] if len(cmd) < 6:

Мало того, если переменная может принимать несколько разных типов, то их можно перечислить через оператор ‘|’ следующим образом:

case [author, title, float() | int() as price, *_] if len(cmd) < 6:

Если нам нужно указать какие-либо ограничения на длину строк автора и заголовка, то это делается в guard, например, так:

case [str(author), str(title), price, *_] if len(cmd) < 6 and len(author) < 50 and len(title) < 100:

И так далее, то есть, здесь с отдельными переменными можно делать все то, что мы рассматривали на предыдущем занятии.

Далее, предположим, что информация о книге может быть представлена в нескольких форматах, например, двух разных:

cmd = ["Балакирев С.М.", "Python", 2000.78]

или

cmd = [1, "Балакирев С.М.", "Python", 2000.78, 2022]

И нам нужно в обоих случаях выделять автора, заголовок и цену. Все остальное не имеет значения. Как сформировать обработку таких данных? Конечно, здесь мы могли бы прописать два отдельных шаблона, но это привело бы к некоторому дублированию кода, что не хорошо. Лучше определить один шаблон, объединяющий эти два варианта. Сделать это можно следующим образом:

match cmd:
    case (author, title, price) | (_, author, title, price, _):
        print(f"Книга: {author}, {title}, {price}")
    case _:  # wildcard
        print("непонятный формат данных")

Смотрите, мы используем группирующие скобки и указываем, как могут быть организованы данные внутри коллекции. На местах тех элементов, что нам не нужны, стоит символ подчеркивания. А оператор ‘|’ означает «или». То есть, может отработать или первый вариант формата, или второй. Причем, обратите внимание, число переменных в группах должно быть одинаковым и их имена совпадать. Это строго обязательно. То есть, мы не можем, например, во второй группе дополнительно выделить год издания:

case (author, title, price) | (_, author, title, price, year):

Будет синтаксическая ошибка. Только одни и те же переменные во всех группах одного и того же шаблона. Если нам нужно во втором варианте дополнительно выделять год издания и с ним что то делать, то тогда вариант с объединением не подойдет и нужно определять два разных оператора case:

match cmd:
    case (author, title, price):
        print(f"Книга: {author}, {title}, {price}")
    case (_, author, title, price, year):
        print(f"Книга: {author}, {title}, {price}, {year}")
    case _:  # wildcard
        print("непонятный формат данных")

И для практики. Если мы бы здесь не хотели обрабатывать данные в виде кортежей, то в первом операторе case следовало бы сделать проверку на этот тип данных, например, так:

match cmd:
    case tuple():
        print("формат кортежа недопустим")
    case (author, title, price):
        print(f"Книга: {author}, {title}, {price}")
    case (_, author, title, price, year):
        print(f"Книга: {author}, {title}, {price}, {year}")
    case _:  # wildcard
        print("непонятный формат данных")

Причем, обратите внимание, проверка на тип tuple должна идти вначале перед распаковкой коллекции. Я, думаю, вы понимаете почему? Тогда если переменная cmd принимает тип tuple, то сразу отработает первый оператор case и все другие будут проигнорированы.

Вот, в целом, такие вариации построения шаблонов проверок возможны при обработке упорядоченных коллекций в конструкции match/case. В заключение лишь отмечу, что обычная строка языка Python не относится к типу Sequence Types, поэтому делать ее распаковку внутри шаблонов не получится. С ней можно только как с единым целым – со строкой целиком.

На следующем занятии мы продолжим эту тему и увидим, как можно строить шаблоны для проверки формата других коллекций, таких как словарей и множеств.

Урок 71 · Часть I. Основы Python

Конструкция match/case со словарями и множествами

Источник: python3-konstrukciya-matchcase-so-slovaryami-i-mnozhestvami

На предыдущих занятиях мы увидели, как можно строить шаблоны проверок для отдельных переменных и упорядоченных коллекций типа list и tuple. Теперь пришло время обработки других коллекций типа dict (словарь) и set (множество). Начнем со словарей.

Давайте предположим, что на вход блока обработки поступает запрос в виде следующего словаря:

request = {'url': 'https://proproprogs.ru/', 'method': 'GET', 'timeout': 1000}

Мы хотим выбрать из него данные по ключам «url» и «method». Шаблон проверки в этом случае будет выглядеть так:

match request:
    case {'url': url, 'method': method}:
        print(f"Запрос: url: {url}, method: {method}")
    case _:  # wildcard
        print("неверный запрос")

Обратите внимание, мы здесь использовали фигурные скобки. Как только мы их прописываем, шаблон сразу ожидает данные в формате «ключ-значение». Далее, мы говорим, что в словаре request должны быть два ключа «url» и «method» с какими то произвольными значениями. Если эти ключи действительно присутствуют, то создаются переменные url и method, которые ссылаются на соответствующие значения ключей. Затем, с помощью print(), мы выводим в консоль строку с этими значениями переменных.

То есть, данный шаблон будет срабатывать всякий раз, как только на вход поступает словарь с ключами «url» и «method». При этом наличие или отсутствие других ключей не играет никакой роли. Например, в словаре request есть еще один ключ «timeout», но, тем не менее, шаблон срабатывает. Это отличает проверку словарей от проверки кортежей и списков, когда мы должны были указывать ровно то число элементов, которые в них ожидаются. Для словарей же достаточно лишь наличие указанных ключей и не более того.

Далее, если мы дополнительно хотим сделать проверку на тип данных в значениях словаря, то это можно сделать следующим образом:

case {'url': str(url), 'method': int() as method}:

Я здесь специально проверку типа записал двумя разными способами, чтобы напомнить о них. В первом ключе мы требуем, чтобы была строка, а во втором – чтобы было целое число. Конечно, сейчас шаблон не сработает, т.к. method является строкой, но если мы его изменим на число:

request = {'url': 'https://proproprogs.ru/', 'method': 1, 'timeout': 1000}

то он среагирует на этот словарь.

Записывая после ключей имена переменных, мы, тем самым, определяем шаблон для произвольных значений заданного типа (или любого типа, если этих проверок нет). Но можно записать ключ с конкретным значением, например, так:

case {'url': url, 'method': method, 'timeout': 1000}:

Тогда оператор case отработает только если ключ ‘timeout’ принимает значение 1000 и будет игнорировать все другие значения. Например, если:

request = {'url': 'https://proproprogs.ru/', 'method': 'GET', 'timeout': 2000}

то перейдем в последний блок case (отбойник). Но, если мы скомбинируем эти два варианта в одном шаблоне:

case {'url': url, 'method': method, 'timeout': 1000} | {'url': url, 'method': method, 'timeout': 2000}:

то сможем отлавливать и значение 1000 и значение 2000 для ключа ‘timeout’. То есть, здесь оператор ‘|’ работает так же, как и с упорядоченными коллекциями.

Также мы, при необходимости, можем прописывать guard (защитника) при обработке словарей. Например, если в запросе request ожидается не более трех ключей, то такой шаблон можно записать в виде:

case {'url': url, 'method': method} if len(request) <= 3:

И так далее, здесь допустимо использовать все те же самые конструкции, которые мы рассматривали на предыдущих занятиях.

Давайте теперь предположим, что нам нужно построить шаблон проверки словаря, в котором есть ключи «url» и «method» и дополнительно может быть еще не более двух ключей. Как это сделать? Для этого следует воспользоваться оператором упаковки ** всех остальных данных словаря, кроме указанных ключей, например, так:

match request:
    case {'url': url, 'method': method, **kwargs} if len(kwargs) <= 2:
        print(f"Запрос: url: {url}, method: {method}")
    case _:  # wildcard
        print("неверный запрос")

В результате в переменной kwargs будут находиться все остальные ключи с их значениями, кроме ключей «url» и «method». А далее, мы просто проверяем, чтобы словарь kwargs содержал не более двух дополнительных ключей.

Теперь, например, для запроса (словаря):

request = {'id': 2, 'url': 'https://proproprogs.ru/', 'method': 'GET', 'timeout': 2000}

шаблон сработает, а для словаря:

request = {'id': 2, 'url': 'https://proproprogs.ru/', 'method': 'GET', 'timeout': 2000, 'date': 100}

не сработает, т.к. дополнительно имеем уже три ключа. Причем расположение ключей в словаре не имеет никакого значения при работе шаблона. Главное, чтобы существовали ключи «url» и «method» и кроме них было не более двух дополнительных ключей.

По аналогии можно организовать проверку на наличие строго двух ключей в словаре:

case {'url': url, 'method': method, **kwargs} if not kwargs:

Мы здесь в защитнике проверяем, чтобы словарь kwargs был пустым.

Давайте теперь несколько усложним структуру словаря и предположим, что на вход поступают следующие данные:

json_data = {'id': 2, 'type': 'list', 'data': [1, 2, 3], 'access': True, 'date': '01.01.2023'}

Здесь множество ключей, причем, один из них (data) может содержать список, если ключ «type» принимает значение «list». Шаблон обработки можно записать в виде:

match json_data:
    case {'type': 'list', 'data': lst}:
        print(f"JSON-данные: type-list: {lst}")
    case _:  # wildcard
        print("неверный запрос")

Первый блок case сработает только в том случае, если ключ «type» имеет значение «list» и имеется еще один ключ «data». Ожидается, что переменная lst в этом случае будет ссылаться на список. Конечно, для надежности, мы можем сделать дополнительную проверку типа данных:

case {'type': 'list', 'data': list() as lst}:

Тогда гарантированно, при срабатывании блока case, переменная lst будет принимать тип list. Видите, как легко, просто и элегантно мы сделали обработку нужного нам формата данных с помощью операторов match/case. Гораздо проще, чем если бы использовали условные операторы if/elif/else. Именно в этом преимущество конструкции match/case перед условными операторами.

Или вот, еще несколько более сложный пример шаблона обработки проверки и обработки входных данных. Пусть имеется словарь вида:

json_data = {'id': 2, 'access': True, 'info': ['01.01.2023', {'login': '123', 'email': 'email@m.ru'}, True, 1000]}

Нам нужно проверить наличие ключей ‘access’ и ‘info’ и выделить значение ключа ‘access’ и email из ключа ‘info’. Сделать это можно следующим образом:

match json_data:
    case {'access': access, 'info': [_, {'email': email}, _, _]}:
        print(f"JSON: access: {access}, email: {email}")
    case _:  # wildcard
        print("неверный запрос")

Смотрите, как красиво все выглядит! Мы буквально берем значение ключа ‘access’ и нужное значение для email из списка ключа ‘info’, попутно проверяя наличие этих ключей и списка в словаре json_data. Причем список обязательно должен содержать четыре элемента и во втором храниться словарь с ключом email. Попробуйте сделать то же самое через операторы if/elif/else и вы увидите, насколько сложнее будет выглядеть эта же программа! Тогда как конструкция match/case с легкостью решает поставленную задачу.

Обработка множеств

Вот в целом так строятся проверки для словарей. Помимо них есть еще одна похожая коллекция – множество (set). Предположим, мы бы хотели выбирать все множества, состоящие из трех элементов, например:

primary_keys = {1, 2, 3}

Как это можно сделать? Если прописать по аналогии со словарем:

match primary_keys:
    case {a, b, c}:
        print(f"Primary Keys: {a}, {b}, {c}")
    case _:  # wildcard
        print("неверный запрос")

то получим синтаксическую ошибку. Для множеств так записывать шаблоны нельзя. Если попробовать убрать фигурные скобки, то будут ожидаться на входе кортежи или списки. Как же быть с множествами? Вариант, фактически, один. Прописать явно тип set и присвоить некоторой переменной ссылку на множество:

match primary_keys:
    case set() as keys:
        print(f"Primary Keys: {keys}")
    case _:  # wildcard
        print("неверный запрос")

А проверку, чтобы множество содержало ровно три элемента, можно сделать с помощью guard:

case set() as keys if len(keys) == 3:

По сути, только так мы можем отбирать множества и через guard записывать некоторые проверки.

На этом мы завершим наше очередное занятие по конструкции match/case. На следующем заключительном занятии по этой теме рассмотрим некоторые ограничения и особенности работы этих операторов, а также посмотрим на некоторые типовые примеры их использования.

Урок 72 · Часть I. Основы Python

Конструкция match/case. Примеры и особенности использования

Источник: python3-konstrukciya-matchcase-primery-i-osobennosti-ispolzovaniya

На предыдущих занятиях мы в целом увидели, как можно прописывать различные шаблоны для проверок отдельных констант и переменных, а также упорядоченных коллекций list, tuple и более сложных – dict, set. На этом занятии посмотрим некоторые реальные приложения конструкции match/case, а также увидим ограничения при использовании этих операторов.

Давайте предположим, что нам нужно организовать подключение к БД. Для этого формируется словарь с необходимыми данными, например, такой:

request = {'server': '127.0.0.1', 'login': 'root', 'password': '1234', 'port': 24}

Затем, с помощью нашей функции connect_db() выполним проверку данных в запросе request и вернем результат подключения:

result = connect_db(request)
print(result)

Саму же функцию запишем в следующем виде:

def connect_db(connect: dict) -> str:
    match connect:
        case {'server': host, 'login': login, 'password': psw, 'port': port}:
            return f"connection: {host}@{login}.{psw}:{port}"
        case {'server': host, 'login': login, 'password': psw}:
            port = 22
            return f"connection: {host}@{login}.{psw}:{port}"
        case _:  # wildcard
            return "error connection"

Здесь сразу бросается в глаза дублирование кода в первых двух блоках case, а именно, строчка с возвращением f-строки. Давайте это поправим. Вынесем ее из блока match и запишем в самом конце функции:

def connect_db(connect: dict) -> str:
    match connect:
        case {'server': host, 'login': login, 'password': psw, 'port': port}:
            pass
        case {'server': host, 'login': login, 'password': psw}:
            port = 22
        case _:  # wildcard
            return "error connection"
 
    return f"connection: {host}@{login}.{psw}:{port}"

Смотрите, в первом блоке case записан оператор pass, который ничего не делает. Но он нужен, т.к. Python не разрешает объявление пустых блоков case, в них обязательно должен быть хотя бы один оператор. Именно поэтому я и прописал pass. Во втором блоке также стоит один оператор, который создает переменную port со значением 22. Если первые два блока case не сработают, то третий отработает в любом случае и функция connect_db() вернет строку “error connection”. Значит, если мы доходим до последней строки функции, то сработал или первый case, или второй. В любом случае у нас будут переменные host, login, psw и port, так как все созданные переменные внутри блока match сохраняются и за его пределами. Поэтому формирование f-строки пройдет без ошибок и будет возвращен требуемый результат. Так мы избавляемся от дублирования кода при одинаковом наборе переменных.

Давайте рассмотрим еще один пример. Предположим, у нас может информация о книгах быть представлена в разных форматах, например:

book_1 = ('Балакирев', 'Python', 2022)
book_2 = ['Балакирев', 'Python ООП', 2022, 3432.27]
book_3 = {'author': 'Балакирев', 'title': 'Нейросети', 'year': 2020}
book_4 = {'author': 'Балакирев', 'title': 'Keras + Tensorflow', 'price': 5430, 'year': 2020}

Наша задача написать функцию, которая бы обрабатывала все эти варианты представления книг и выдавала кортеж в формате:

(автор, название, год, цена)

Пусть эта функция называется book_to_tuple() и вызывается в программе следующим образом:

result = book_to_tuple(book_1)
print(result)

Саму функцию удобно реализовать с помощью операторов match/case, например, так:

def book_to_tuple(data: dict | tuple | list) -> tuple | None:
    match data:
        case author, title, year:
            price = None
        case author, title, year, price, *_:
            pass
        case {'author': author, 'title': title, 'year': year, 'price': price}:
            pass
        case {'author': author, 'title': title, 'year': year}:
            price = None
        case _:  # wildcard
            return None
 
    return author, title, year, price

Смотрите, параметр data может быть разных типов: словарь, кортеж или список. На выходе функция должна выдавать или кортеж, или значение None, если входные данные не соответствуют ожидаемым форматам. Далее, первый блок case распаковывает кортеж или список, состоящий из трех элементов в формате: автор, название, год издания. Если шаблон срабатывает, то формируется четвертая переменная price со значением None. Следующий шаблон ожидает также список или кортеж, состоящий, как минимум из четырех элементов в порядке: автор, название, год издания, цена. Далее могут идти какие-либо другие элементы, мы их просто игнорируем. Следующие два блока проверяют словари. Словарь может содержать или три ключа, тогда формируется четвертая переменная price со значением None, или четыре ключа с полным набором необходимых переменных. Если ни один из шаблонов не срабатывает, то попадаем в последний блок case, который возвращает значение None, то есть, несоответствие форматов. Если же отрабатывает один из предыдущих блоков case, то переходим к последней команде функции, где возвращается кортеж со значениями переменных author, title, year, price.

Как видите, все достаточно просто и очевидно. Но здесь опять же есть небольшое дублирование кода: дважды записана команда price = None. По логике ее можно вынести за пределы оператора match и записать перед ним:

def book_to_tuple(data: dict | tuple | list) -> tuple | None:
    price = None
    match data:
        case author, title, year:
            pass
        case author, title, year, price, *_:
            pass
        case {'author': author, 'title': title, 'year': year, 'price': price}:
            pass
        case {'author': author, 'title': title, 'year': year}:
            pass
        case _:  # wildcard
            return None
 
    return author, title, year, price

Получим абсолютно тот же самый результат. (Операторы pass можно не считать дублированием кода).

Давайте немного усложним задачу и сделаем дополнительную проверку на целочисленный тип переменной year и ее принадлежность диапазону значений (min_year; max_year). Если сделать это «в лоб», то получим что то вроде:

def book_to_tuple(data: dict | tuple | list, min_year=1800, max_year=3000) -> tuple | None:
    price = None
    match data:
        case author, title, int(year) if min_year < year < max_year:
            pass
        case author, title, int(year), price, *_ if min_year < year < max_year:
            pass
        case {'author': author, 'title': title, 'year': int(year), 'price': price} if min_year < year < max_year:
            pass
        case {'author': author, 'title': title, 'year': int(year)} if min_year < year < max_year:
            pass
        case _:  # wildcard
            return None
 
    return author, title, year, price

Видите, здесь идет явное дублирование кода в шаблонах. Оставить так или поправить, конечно, решать разработчику, но, на мой взгляд, здесь целесообразно скомбинировать оператор match с оператором if следующим образом:

def book_to_tuple(data: dict | tuple | list, min_year=1800, max_year=3000) -> tuple | None:
    price = None
    match data:
        case author, title, int(year):
            pass
        case author, title, int(year), price, *_:
            pass
        case {'author': author, 'title': title, 'year': int(year), 'price': price}:
            pass
        case {'author': author, 'title': title, 'year': int(year)}:
            pass
        case _:  # wildcard
            return None
 
    if not (min_year < year < max_year):
        return None
 
    return author, title, year, price

То есть, мы буквально всю проверку вынесли в одну строчку оператора if. Этот пример показывает, что нас никто не ограничивает в различных комбинациях операторов match и if для написания более удобного и читабельного текста программы.

В заключение этого занятия покажу еще одну особенность конструкции match/case. Для простоты предположим, что у нас имеется некая целочисленная переменная:

cmd = 10

и в операторе match хотели бы выделить две ситуации со значениями 3 и 5. Очевидно, сделать это можно следующим образом:

match cmd:
    case 3:
        print("3")
    case 5:
        print("5")

Но опытный разработчик знает, что явно прописывать константы в программе не лучший ход. Правильнее было бы сначала задать константы с числами 3 и 5, а уже потом их использовать в операторах case. Давайте так и сделаем:

CMD_3 = 3
CMD_5 = 5
 
cmd = 3
 
match cmd:
    case CMD_3:
        print("3")
    case CMD_5:
        print("5")

Однако, при запуске обнаруживается синтаксическая ошибка. Почему? Дело в том, что в Python нет констант как таковых. Здесь объявлены две переменные CMD_3 и CMD_5, которые указываются в операторах case. В действительности, это аналогично тому, что мы в case пропишем произвольную переменную, например, такую:

match cmd:
    case _:
        print("3")
    case CMD_5:
        print("5")

Да, принципиально мы ничего не изменили, просто написали другое имя переменной. Но вы помните, что она означает – любые данные, т.е. срабатывает всегда, поэтому второй блок case здесь приводит к ошибке. Если мы его уберем, то программа всегда будет выводить число 3:

match cmd:
    case _:
        print("3")

Но это не то, что нам нужно. Все же, как можно использовать переменные как константы в операторах case? Здесь есть, по крайней мере, два варианта. Если сами константы объявлены в текущем модуле и менять мы этого не хотим, то можно пойти на следующую хитрость:

match cmd:
    case int(cmd) as x if x == CMD_3:
        print("3")
    case int(cmd) as x if x == CMD_5:
        print("5")

Однако, выглядит это слишком громоздко. Тут проще было бы воспользоваться операторами if/elif/else. Во втором случае разработчики разрешают нам использовать переменные как константы, если переменная указана через точку. Но что это значит? Например, мы можем переменные CMD_3 и CMD_5 вынести в отдельный файл (модуль), а потом подключить его через import в текущем модуле:

import consts
 
cmd = 3
 
match cmd:
    case consts.CMD_3:
        print("3")
    case consts.CMD_5:
        print("5")

Тогда никаких проблем не возникнет и программа будет работать, как задумано.

Или, можно пойти на еще одну хитрость и определить константы внутри какого-либо класса, например, так:

class Consts:
    CMD_3 = 3
    CMD_5 = 5
 
 
cmd = 3
 
match cmd:
    case Consts.CMD_3:
        print("3")
    case Consts.CMD_5:
        print("5")

В этом случае тоже все отработает как надо без ошибок.

Вот такие приемы и особенности есть у конструкции match/case, которые мне удалось выяснить. Я думаю, что материал этих занятий по операторам match/case позволит вам достаточно уверенно и легко использовать их в своих программах, там, где они действительно позволят упростить программный код и сделают его более читаемым и удобным для редактирования.

Практика 17 · Часть I. Основы Python

Match / Case

Задания для закрепления темы · решений нет

Цели обучения

  • Заменять многоветвистые цепочки if на match / case
  • Деструктурировать последовательности и отображения в паттернах
  • Осознанно использовать охранные условия и catch-all _

Задания

Задание 1. Метка HTTP-статуса

Сложность: лёгкое

Реализуйте status_label(code: int) -> str через match:

CodeLabel
200ok
301, 302redirect
404not found
500error
otherunknown

Требования:

  • Использовать match / case (объединить 301/302 в одном case)
  • Catch-all _

Пример:

status_label(302)  # "redirect"
status_label(418)  # "unknown"

Задание 2. Разбор команды

Сложность: лёгкое

Реализуйте parse_command(line: str) -> str:

  • Разбить line по пробелам
  • match получившегося списка:

- ["quit"] → "bye"

- ["help"] → "commands: quit, help, echo"

- ["echo", *rest] → " ".join(rest)

- всё остальное → "unrecognized"

Требования:

  • Паттерны последовательностей с захватом/*rest
  • Пустая строка → "unrecognized"

Пример:

parse_command("echo hello world")  # "hello world"
parse_command("quit")              # "bye"

Задание 3. Квадрант точки

Сложность: среднее

Точки как кортежи (x, y). Реализуйте describe_point(p: tuple) -> str через match:

  • (0, 0) → "origin"
  • (x, 0) → "on x-axis"
  • (0, y) → "on y-axis"
  • (x, y) if x > 0 and y > 0 → "Q1"
  • аналогично Q2, Q3, Q4 с охранными условиями

Требования:

  • Использовать охранные условия (case ... if ...)
  • Предполагать ровно два числа

Пример:

describe_point((0, 0))   # "origin"
describe_point((-1, 5))  # "Q2"

Задание 4. Обработка событий

Сложность: среднее

Реализуйте handle_event(event: dict) -> str через паттерны отображений:

  • {"type": "click", "x": x, "y": y} → f"click at ({x}, {y})"
  • {"type": "key", "key": k} → f"key {k}"
  • {"type": "quit"} → "quit"
  • остальные словари → "ignored"

Требования:

  • Паттерны отображений, связывающие x, y, k
  • Лишние ключи в подходящем событии всё ещё могут совпасть (задокументируйте поведение mapping-паттернов Python, на которое опираетесь)

Пример:

handle_event({"type": "click", "x": 10, "y": 20})  # "click at (10, 20)"
handle_event({"type": "resize"})                   # "ignored"

Задание 5. Форма вложенной последовательности

Сложность: среднее

Реализуйте shape_area(shape) -> float через match:

  • ("circle", r) → math.pi r r
  • ("rect", w, h) → w * h
  • ("square", a) → a * a
  • ("triangle", base, height) → 0.5 base height
  • иначе → возбудить ValueError("unknown shape")

Требования:

  • Только паттерны последовательностей (кортежи/списки)
  • Импортировать math для π

Пример:

shape_area(("rect", 3, 4))  # 12.0

Задание 6. Мини-проект: вычислитель выражений

Сложность: сложное

Реализуйте eval_expr(expr), где expr — вложенная структура:

# numbers are ints/floats
# ("+", a, b), ("-", a, b), ("*", a, b), ("/", a, b)
# ("neg", a)

Операнды a и b сами могут быть вложенными выражениями.

Используйте рекурсивный match / case. Деление на ноль → ZeroDivisionError. Неизвестный узел → ValueError.

Требования:

  • Рекурсия + сопоставление с образцом
  • Без eval / exec над строками

Пример:

eval_expr(("+", 1, ("*", 2, 3)))     # 7
eval_expr(("neg", ("-", 5, 8)))      # 3

Подсказки:

  • Сопоставлять кортежи по тегу в начале, затем рекурсивно обрабатывать операнды

Часть II. ООП на Python

Глава 1

Классы, объекты, методы

Урок 1 · Часть II. ООП на Python

Концепция ООП простыми словами

Источник: koncepciya-oop-prostymi-slovami

У многих начинающих программистов концепция ООП вызывает недоумение и вопрос: зачем она нужна? Я же уже умею писать программы: оперировать данными, создавать циклы, прописывать условия, вызывать функции и тем самым писать программы практически любой сложности? Разве этого мало? Этого было достаточно до 1960-x гг. когда, в общем то и зародилась эта концепция ООП. Даже можно сказать, что вплоть до начала 1990-х программисты могли свободно обходиться без ООП, пока оно не стало доминирующим направлением и внедрено в самый популярный (на тот момент) язык программирования С++. Так что же это такое и почему сейчас знать ООП должен каждый, уважающий себя, начинающий программист?

Я постараюсь ответить на все эти вопросы, не прибегая к конкретному языку программирования, то есть, в целом разъяснить концепцию ООП – общую для всех языков программирования. И начну с того, что почти всегда в программах мы оперируем объектами данных. Например, создается программа по учету животных, в частности, котов и кошек. Значит, здесь мы имеем дело с объектом коты (Cats). И было бы хорошо все данные, связанные с котами, представлять в программе как единое целое. Как раз это можно сделать с помощью класса:

Иллюстрация к уроку

Здесь класс можно воспринимать, как шаблон, по которому будут формироваться данные о котах. В этом шаблоне есть три свойства: порода, имя и возраст. Программист сам решает, сколько и какие свойства будет содержать класс. Я решил, для примера, пусть будут такие. А вот конкретные коты – это объекты данного класса:

Иллюстрация к уроку

И таких объектов может быть множество. То есть, объекты создаются по образу и подобию шаблона – класса, в данном случае Cats. Далее в программе мы можем работать с этими объектами-котами, как с единым целым.

Вообще, класс может содержать не только свойства, то есть, данные, но и методы – набор функций, определенные для работы с классом и его объектами. То есть, класс может описывать некий алгоритм, фрагмент программы, присущий именно этому объекту. Например, в классе можно определить метод (функцию), которая бы рисовала кота на экране устройства. Пусть, для примера, она называется draw():

Иллюстрация к уроку

Тогда у каждого объекта этого класса можно будет вызывать метод draw() и на экране будет рисоваться соответствующий кот. Видите, как удобно можно оперировать объектами на уровне классов. И это только начало.

Разумеется, таких методов в классах может быть сколько угодно. И они, как правило, имеют доступ ко всем свойствам текущего класса и объекта. В результате, в рамках одного класса можно сформировать полноценную программу, которая часто работает независимо в каждом объекте этого класса.

Чтобы это было понятнее, приведу пример из своей практики, когда я впервые применил ООП и был этим очень доволен. Как то мне понадобилось вывести в одном окне несколько независимых графиков функций:

Иллюстрация к уроку

Тогда я определил класс Graphs для отображения и манипулирования графиками (перемещение, изменение масштаба и прочее). А, затем, каждый конкретный график стал просто объектом этого класса.

Иллюстрация к уроку

Благодаря этому, у меня в программе один блок кода отвечал за независимое отображение сразу нескольких графиков в окне программы. И это было здорово!

Инкапсуляция

Итак, мы теперь представляем себе, что такое класс и что такое объекты класса. Сделаем следующий шаг и отметим, что класс вообще должен восприниматься как единая, целостная конструкция, все внутренние манипуляции с его данными должны быть сокрыты в этом классе и в идеале недоступны извне. То есть, программисты, использующие его, не могли бы обращаться ко всем его данным и методам, а только к некоторым – разрешенным.

Это, как с реальными вещами. Например, когда мы покупаем автомобиль, то нам важно как им управлять, какие у него характеристики, но совершенно не имеет значения, как работает двигатель, почему крутятся колеса, из чего сделаны стекла, как взаимодействуют между собой все его агрегаты и прочее и прочее. Пользователю автомобиля главное, чтобы он безупречно работал и довозил его с комфортом из п. А в п. Б.

Иллюстрация к уроку

То есть, машина в целом, это некая капсула, которая внутри себя скрывает огромное количество разных узлов, взаимодействующих между собой. И, в идеале, нам совершенно не важен их внутренний алгоритм функционирования. Важен конечный результат – завели и поехали!

Та же идея заложена и в классах. Они вроде капсулы, которая содержит в себе данные и методы, которые и определяют внутренний алгоритм функционирования данного класса:

Иллюстрация к уроку

И чтобы пользователь класса не мог случайно или намеренно вмешаться в его внутреннюю работу, данные и методы можно скрывать. То есть, к скрытым данным и методам нельзя напрямую обращаться извне, только внутри класса. Такой механизм в ООП называется инкапсуляцией. Благодаря инкапсуляции класс становится единым целым, а работа с ним возможна только через разрешенные (публичные) свойства и методы.

Например, в автомобиле такие разрешенные методы – это руль, коробка передач, педали газа и тормоза и прочее, чем мы можем управлять во время движения. А все остальное, лишнее для нас, скрыто внутри. И по большому счету, нам не важно, как именно достигается результат, главное, чтобы ехали! Это и есть идея инкапсуляции в ООП.

Наследование

Следующая важная идея ООП – наследование классов. Наследование позволяет как бы вынести «за скобки» общее для разных классов. Я часто здесь привожу пример с разработкой графического редактора, в котором можно рисовать графические примитивы: линии, прямоугольники, эллипсы и другие фигуры. С точки зрения ООП каждый такой примитив удобно представить своим классом:

Иллюстрация к уроку

Но, очевидно, в этих классах будут общие свойства: coords, width и color. Получаем дублирование кода, то есть, нарушение принципа DRY – не повторяйся. Именно эти общие свойства целесообразно вынести в общий для всех них базовый класс Figure:

Иллюстрация к уроку

Но, чтобы данные и методы класса Figure появлялись в дочерних классах Line, Rect и Ellipse, необходимо унаследовать их от класса Figure. То есть, благодаря механизму наследования классов, мы можем использовать ранее созданные классы и расширять их функциональность. В нашем примере, есть класс Figure, который только хранит данные. А унаследованные, дочерние классы расширяют его функциональность и выполняют рисование конкретных графических примитивов.

Полиморфизм

Наконец, последняя важная концепция ООП – полиморфизм. Это необычное слово, применительно к классам и объектам означает, что мы можем единым образом работать с разными типами данных. Вообще, в программировании различают два вида полиморфизма. Это, так называемый, Ad hoc полиморфизм и параметрический полиморфизм. Первый, Ad hoc существовал еще до появления ООП и реализовывался через перегрузку функций и приведение различных типов данных.

double abs(double x) {
       return (x < 0) ? –x : x 
}
 
int abs(int x) {
       return (x < 0) ? –x : x 
}

Я не буду на нем подробно останавливаться, тем более, что в Python он не используется. А вот второй, параметрический, это очень классная вещь.

Я снова вернусь к примеру с графическим редактором, где у нас было три класса с одним базовым Figure. В базовый класс я также добавил метод draw() и вы сейчас поймете почему. Допустим, что для каждого класса были созданы объекты. И наша задача их нарисовать в окне программы. Для этого есть метод draw(), который существует в каждом дочернем классе: Line, Rect и Ellipse. Так вот, если бы не было полиморфизма, то мы в программе должны были бы сначала перебрать список из объектов Line, затем, список из объектов Rect и наконец, из объектов Ellipse. Очевидно, это не лучший подход. Представьте, что в будущем у нас будут появляться все новые и новые виды графический примитивов, например, треугольник, пятиугольник, трапеция и т.п. Тогда списков разных типов объектов будет все больше и больше, а программа все сложнее и сложнее. Да и, кроме того, появится дублирование кода.

Но, благодаря параметрическому полиморфизму, мы можем оперировать разными типами объектов через их единый базовый класс, в нашем случае Figure. Достаточно создать список, каждый элемент которого будет иметь тип Figure и через ссылку на базовый класс вызывать функцию draw(). Причем автоматически будет вызван метод draw() соответствующего дочернего класса. Так устроено наследование в ООП. В результате, мы имеем единый интерфейс – класс Figure для управления самыми разными типами графических примитивов. Причем, в будущем в программу можно добавлять новые графические классы, просто унаследовав их от Figure и они автоматически будут встраиваться в общую логику работы программы. И это невероятно удобная вещь! Благодаря наследованию и полиморфизму мы можем на уровне ООП описывать общую, абстрактную архитектуру работы программы в целом, а потом, создавая дочерние классы, наполнять эту программу конкретным содержимым, конкретным поведением. Это буквально переносит нас на совершенно другой, более высокий уровень программирования – целостного, абстрактного описания информационных потоков наших приложений. Поэтому не случайно большинство современных паттернов проектирования основаны именно на концепции ООП. Без нее общее описание программных конструкций было бы очень непростым занятием для программистов.

Заключение

Вот что в целом из себя представляет концепция ООП, состоящая из трех главных элементов:

  • инкапсуляция;
  • наследование;
  • полиморфизм.

Все это мы будем подробно рассматривать в курсе по ООП на Python. Познакомимся со способами программной реализации каждого компонента. И в итоге, вы сможете использовать всю мощь ООП в своих реализациях! Поехали!

Урок 2 · Часть II. ООП на Python

Классы и объекты. Атрибуты классов и объектов

Источник: klassy-i-obekty-atributy-klassov-i-obektov

Меня зовут Сергей Балакирев и на этом занятии мы с вами узнаем, как в Python определять классы, создавать объекты (экземпляры) этих классов, а также добавлять и удалять их атрибуты (то есть, данные).

Предположим, мы хотим определить класс для хранения координат точек на плоскости. Для начала я его запишу без какого-либо содержимого, только имя класса Point и все:

class Point:
    pass

Здесь оператор pass указывает, что мы в классе ничего не определяем. Также обратите внимание, что в соответствии со стандартом PEP8 имя класса принято записывать с заглавной буквы. И, конечно же, называть так, чтобы оно отражало суть этого класса. В дальнейшем я буду придерживаться этого правила.

Итак, у нас получилось простейшее определение класса с именем Point. Но в таком виде он не особо полезен. Поэтому я пропишу в нем два атрибута: color – цвет точек; circle – радиус точек:

class Point:
    color = 'red'
    circle = 2

Обратите внимание, переменные внутри класса обычно называются атрибутами класса или его свойствами. Я буду в дальнейшем использовать эту терминологию. Теперь в нашем классе есть два атрибута color и circle. Но, как правильно воспринимать эту конструкцию? Фактически, сам класс образует пространство имен, в данном случае с именем Point, в котором находятся две переменные color и circle. И мы можем обращаться к ним, используя синтаксис для пространства имен, например:

Point.color = 'black'

или для считывания значения:

Point.circle

(В консольном режиме увидим значение 2). А чтобы увидеть все атрибуты класса можно обратиться к специальной коллекции dict:

Point.__dict__

Здесь отображается множество служебных встроенных атрибутов и среди них есть два наших: color и circle.

Теперь сделаем следующий шаг и создадим экземпляры этого класса. В нашем случае для создания объекта класса Point достаточно после его имени прописать круглые скобки:

a = Point()

Смотрите, справа на панели в Python Console у нас появилась переменная a, через которую доступны два атрибута класса: color и circle.

Давайте создадим еще один объект этого класса:

b = Point()

Появилась переменная b, которая ссылается на новый объект (он расположен по другому адресу) и в этом объекте мы также видим два атрибута класса Point. По аналогии можно создавать произвольное количество экземпляров класса.

С помощью функции type мы можем посмотреть тип данных для переменных a или b:

type(a)

Видим, что это класс Point. Эту принадлежность можно проверить, например, так:

type(a) == Point

или так:

isinstance(a, Point)

То есть, имя класса здесь выступает в качестве типа данных. Но давайте детальнее разберемся, что же у нас в действительности получилось?

Иллюстрация к уроку

Во-первых, объекты a и b образуют свое пространство имен – пространство имен экземпляров класса и, во-вторых, не содержат никаких собственных атрибутов. Свойства color и circle принадлежат непосредственно классу Point и находятся в нем, а объекты a и b лишь имеют ссылки на эти атрибуты класса. Поэтому я не случайно называю их именно атрибутами класса , подчеркивая этот факт. То есть, атрибуты класса – общие для всех его экземпляров. И мы можем легко в этом убедиться. Давайте изменим значение свойства circle на 1:

Point.circle = 1

И в обоих объектах это свойство стало равно 1. Мало того, если посмотреть коллекцию dict у объектов:

a.__dict__

то она будет пустой, так как в наших экземплярах отсутствуют какие-либо атрибуты. Но, тем не менее, мы можем через них обращаться к атрибутам класса:

a.color
b.circle

Но, если мы выполним присваивание, например:

a.color = 'green'

То, смотрите, в объекте a свойство color стало ‘green’, а в b – прежнее. Почему? Дело в том, что мы здесь через переменную a обращаемся к пространству имен уже экземпляра класса и оператор присваивания в Python создает новую переменную, если она отсутствует в текущей локальной области видимости, то есть, создается атрибут color уже непосредственно в объекте a:

Иллюстрация к уроку

Мы можем в этом убедиться, если отобразим коллекцию dict этого объекта:

a.__dict__

То есть, мы с вами создали локальное свойство в объекте a. Этот момент нужно очень хорошо знать и понимать. На этом принципе в Python построено формирование атрибутов классов и локальных атрибутов их экземпляров.

Добавление и удаление атрибутов класса

Кстати, по аналогии, мы можем создавать новые атрибуты и в классе, например, так:

Point.type_pt = 'disc'

Или то же самое можно сделать с помощью специальной функции:

setattr(Point, 'prop', 1)

Она создает новый атрибут в указанном пространстве имен (в данном случае в классе Point) с заданным значением. Если эту функцию применить к уже существующему атрибуту:

setattr(Point, 'type_pt', 'square')

то оно будет изменено на новое значение.

Если же мы хотим прочитать какое-либо значение атрибута, то достаточно обратиться к нему. В консольном режиме это выглядит так:

Point.circle

Но, при обращении к несуществующему атрибуту класса, например:

Point.a

возникнет ошибка. Этого можно избежать, если воспользоваться специальной встроенной функцией:

getattr(Point, 'a', False)

Здесь третий аргумент – возвращаемое значение, если атрибут не будет найден. Эту же функцию можно вызвать и с двумя аргументами:

getattr(Point, 'a')

Но тогда также будет сгенерирована ошибка при отсутствии указанного атрибута. Иначе:

getattr(Point, 'color')

она возвратит его значение. То есть, эта функция дает нам больше гибкости при обращении к атрибутам класса. Хотя на практике ей пользуются только в том случае, если есть опасность обращения к несуществующим атрибутам. Обычно, все же, применяют обычный синтаксис:

Point.color

Наконец, мы можем удалять любые атрибуты из класса. Сделать это можно, по крайней мере, двумя способами. Первый – это воспользоваться оператором del:

del Point.prop

Если повторить эту команду и попытаться удалить несуществующий атрибут, возникнет ошибка. Поэтому перед удалением рекомендуется проверять существование удаляемого свойства. Делается это с помощью функции hasattr:

hasattr(Point, 'prop')

Она возвращает True, если атрибут найден и False – в противном случае.

Также удалить атрибут можно с помощью функции:

delattr(Point, 'type_pt')

Она работает аналогично оператору del.

И, обратите внимание, удаление атрибутов выполняется только в текущем пространстве имен. Например, если попытаться удалить свойство color из объекта b:

del b.color

то получим ошибку, т.к. в объекте b не своих локальных свойств и удалять здесь в общем то нечего. А вот в объекте a есть свое свойство color, которое мы с вами добавляли:

a.__dict__

и его можно удалить:

del a.color

Смотрите, после удаления локального свойства color в объекте a становится доступным атрибут color класса Point с другим значение ‘black’. И это логично, т.к. если свойство не обнаруживается в локальной области, то поиск продолжается в следующей (внешней) области видимости. А это (для объекта a) класс Point. Вот этот момент также следует хорошо понимать при работе с локальными свойствами объектов и атрибутами класса.

Атрибуты экземпляров классов

Теперь, когда мы знаем, как создаются атрибуты, вернемся к нашей задаче формирования объектов точек на плоскости. Мы полагаем, что атрибуты color и circle класса Point – это общие данные для всех объектов этого класса. А вот координаты точек должны принадлежать его экземплярам. Поэтому для объектов a и b мы определим локальные свойства x и y:

a.x = 1
a.y = 2
b.x = 10
b.y = 20

То есть, свойства x, y будут существовать непосредственно в объектах, но не в самом классе Point:

Иллюстрация к уроку

В результате, каждый объект представляет точку с независимыми координатами на плоскости. А цвет и их размер – общие данные для всех объектов.

В заключение этого занятия отмечу, что в любом классе языка Python мы можем прописывать его описание в виде начальной строки, например, так:

class Point:
    "Класс для представления координат точек на плоскости"
    color = 'red'
    circle = 2

В результате, специальная переменная:

Point.__doc__

будет ссылаться на это описание. Обычно, при создании больших программ, в ключевых классах создают такие описания, чтобы в последующем было удобнее возвращаться к ранее написанному коду, корректировать его и использовать, не обращаясь к специальной документации.

Заключение

Итак, из этого занятия вы должны себе хорошо представлять, как определяются классы в Python и создаются объекты класса. Что из себя представляют атрибуты класса и атрибуты объектов, как они связаны между собой. Уметь обращаться к этим атрибутам, добавлять, удалять их, а также проверять существование конкретного свойства в классе или объекте класса.

Урок 3 · Часть II. ООП на Python

Методы классов. Параметр self

Источник: metody-klassov-parametr-self

Мы продолжаем изучать ООП языка Python. Как я говорил на первом занятии, класс может содержать свойства (данные) и методы (функции). Благодаря методам внутри класса можно реализовывать самые разные алгоритмы, то есть методы – это действия. Именно поэтому, в названиях методов используют глаголы, например:

set_value, get_param, start, stop, и т.п.

В то время как именами свойств (данных) выступают существительные:

color, size, x, y, и т.п.

Рекомендуется придерживаться этого простого правила.

Давайте, для примера объявим метод set_coords в классе Point, который будет просто выводить в консоль сообщение «вызов метода set_coords»:

class Point:
    color = 'red'
    circle = 2
 
    def set_coords(self):
        print("вызов метода set_coords")

Здесь сразу бросается в глаза вот этот параметр self, который автоматически прописывает интегрированная среда. Зачем он здесь, если мы пока ничего не собираемся передавать этому методу? Давайте его уберем! Пока никаких проблем не возникло. Мало того, мы можем его вызвать из класса Point:

Point.set_coords()

и все будет работать без ошибок. Здесь мы видим, как вызываются методы класса. Все довольно очевидно. Записываем имя класса (Point), и через точку указываем имя метода. В конце обязательно прописываем круглые скобки, так как это оператор вызова функций. И, так как метод – это функция класса, то для вызова метода используется тот же оператор, что и для вызова функций.

В результате, мы получили класс, в котором два свойства и один метод. Далее, создадим экземпляр этого класса:

pt = Point()

И, как мы с вами говорили, через объект pt можно обращаться ко всем атрибутам класса Point, в том числе и к методу set_coords:

pt.set_coords

Этот атрибут ссылается на объект-функцию, которую мы определили в классе Point. Попробуем ее вызвать:

pt.set_coords()

Видим ошибку, что в метод set_coords при вызове передается один аргумент, а он у нас определен без параметров. Дело в том, что когда мы вызываем методы класса через его объекты, то интерпретатор Python автоматически добавляет первым аргументом ссылку на объект, из которого этот метод вызывается.

Иллюстрация к уроку

Поэтому, если мы хотим внутри класса определить метод, который можно было бы вызывать из его экземпляров, то дополнительно прописывается первый параметр, обычно, с именем self:

class Point:
    color = 'red'
    circle = 2
 
    def set_coords(self):
        print("вызов метода set_coords " + str(self))

Еще раз, параметр self будет ссылаться на экземпляр класса, из которого вызывается метод. Зачем это надо? Сейчас узнаете. После этого дополнения мы уже не сможем вызвать данный метод через класс без указания первого аргумента:

Point.set_coords()

но можем через его объекты:

pt.set_coords()

То есть, когда метод вызывается через класс, то Python автоматически не подставляет никаких аргументов. А когда вызов идет через экземпляры класса, то первый аргумент – это всегда ссылка на экземпляр. Данный момент нужно знать и помнить.

Но мы все же можем вызвать метод set_coords и через класс, если явно передадим ссылку на объект pt, следующим образом:

Point.set_coords(pt)

Именно это на автомате делает Python, когда вызов осуществляется через объекты классов.

Так зачем понадобилось такое поведение? Дело в том, что метод класса – это тоже его атрибут и когда создаются экземпляры класса, то метод становится общим для всех объектов и не копируется в них. Фактически, только благодаря параметру self мы «знаем» какой объект вызвал данный метод и можем организовать с ним обратную связь.

Например, пусть метод set_coords задает координаты точек для текущего объекта. Тогда, мы пропишем в нем два дополнительных параметра и через self в самом экземпляре класса создадим (либо переопределим) два свойства:

class Point:
    color = 'red'
    circle = 2
 
    def set_coords(self, x, y):
        self.x = x
        self.y = y

В результате, при вызове метода:

pt.set_coords(1, 2)
print(pt.__dict__)

в объекте pt будут созданы два свойства x, y со значениями 1 и 2. Вот для чего нужен этот параметр self. Если в программе создать еще один объект:

pt2 = Point()

и через него вызвать тот же самый метод:

pt2.set_coords(10, 20)
print(pt2.__dict__)

То увидим, что свойства x, y со значениями 10 и 20 были созданы только в нем (в его пространстве имен) и никак не связаны с координатами другого объекта pt или классом Point. То есть, через self мы работаем с конкретным объектом, из которого был вызван данный метод.

Конечно, в классах мы можем прописывать произвольное количество методов. Например, определим еще один, который будет возвращать координаты точки в виде кортежа значений:

class Point:
    color = 'red'
    circle = 2
 
    def set_coords(self, x, y):
        self.x = x
        self.y = y
 
    def get_coords(self):
        return (self.x, self.y)

И ниже в программе можем вызвать его:

print(pt.get_coords())

Интересно, что так как имя метода – это атрибут класса, то мы можем обратиться к нему через знакомую нам уже функцию:

res = getattr(pt, 'get_coords')
print(res)

Видим, что это ссылка на объект-функцию. А раз так, то ничто нам не мешает ее здесь вызывать:

print(res())

Конечно, так делают очень редко. Обычно используют синтаксис через точку. Я привел это, чтобы еще раз подчеркнуть, что имена методов – это те же самые атрибуты, просто они ведут не на данные, а на функции. Во всем остальном они схожи с атрибутами-данными класса.

Заключение

Итак, на этом занятии вы должны были узнать, как определяются простые методы класса, за что отвечает параметр self и как происходит обращение к методам и их вызов. Если все это понятно, то смело переходите к следующему занятию, где мы продолжим эту тему.

Урок 4 · Часть II. ООП на Python

Инициализатор <strong>init</strong> и финализатор <strong>del</strong>

Источник: inicializator-init-i-finalizator-del

На этом занятии мы поговорим о начальной инициализации объектов в момент их создания и финализации при их удалении.

В каждом классе языка Python есть набор предопределенных «магических» методов. Да, это такое общепринятое название. Магические методы начинаются и заканчиваются двумя подчеркиваниями:

__ имя метода__

В частности существуют два таких метода:

  • init(self) – инициализатор объекта класса
  • del(self) – финализатор класса

Первый вызывается сразу после создания экземпляра класса, а второй – перед непосредственным его удалением. Давайте посмотрим, как они работают и зачем нужны.

Я вернусь к примеру из прошлого занятия, где мы с вами определили класс с двумя свойствами color и circle и двумя методами set_coords и get_coords:

class Point:
    color = 'red'
    circle = 2
 
    def set_coords(self, x, y):
        self.x = x
        self.y = y
 
    def get_coords(self):
        return (self.x, self.y)

Использовать на практике такой класс не очень удобно, так как после создания объекта:

pt = Point()

координат x, y в нем никаких не будет. Дополнительно для этого нужно еще вызывать метод:

pt.set_coords(1, 2)

Было бы хорошо сделать эти действия сразу в момент создания экземпляра класса. И поможет нам в этом магический метод init. Давайте сначала мы его пропишем в самом простом виде:

class Point:
    color = 'red'
    circle = 2
 
    def __init__(self):
        print("вызов __init__")
        self.x = 0
        self.y = 0
    ...

Здесь первый параметр self является ссылкой на созданный экземпляр класса, через который мы создаем в этом новом объекте локальные свойства x, y. В результате, создавая экземпляр класса:

pt = Point()

мы увидим в консоли, что, во-первых, произошел вызов этого метода и, во-вторых, в объекте pt были созданы два локальных свойства x, y с нулевыми значениями:

print(pt.__dict__)

Детально это работает, следующим образом. Вначале происходит создание объекта в памяти устройства. Непосредственно перед его созданием вызывается магический метод new (О нем мы еще будем говорить). Затем, после успешного создания объекта, вызывается магический метод init для начальной инициализации созданного объекта. В результате, у нас появляются два локальных атрибута x и y.

Давайте теперь сделаем так, чтобы в момент создания экземпляра класса мы могли сразу указывать значения координат точки. Для этого в инициализаторе можно прописывать дополнительные параметры:

    def __init__(self, a, b):
        self.x = a
        self.y = b

И при создании объекта с таким инициализатором мы уже должны в круглых скобках передавать эти два аргумента:

pt = Point(1, 2)

Если этого не сделать, то возникнет ошибка и объект создан не будет.

Обратите внимание, я специально в качестве дополнительных параметров указал имена a и b. При этом, в самом объекте создаются локальные свойства с именами x и y. То есть, то, что мы прописываем после self, то и является именем нового атрибута. Конечно, на практике, обычно, имена параметров в инициализаторе совпадают с именами создаваемых свойств и лучше записать инициализатор в таком виде:

    def __init__(self, x, y):
        self.x = x
        self.y = y

Также всегда следует помнить, что метод init - это обычная функция, поэтому мы в качестве дополнительных параметров можем указывать и фактические и формальные параметры. Например, так:

    def __init__(self, x=0, y=0):
        self.x = x
        self.y = y

Тогда, при создании объектов мы можем вообще не указывать аргументы:

pt = Point()

Либо указать один или два:

pt = Point(10)
pt = Point(10, 20)

То есть, здесь все ровно так, как и с обычными функциями.

Финализатор объекта класса

Я, надеюсь, вы теперь хорошо себе представляете, как работает инициализатор объектов класса и зачем он нужен. Второй аналогичный магический метод del автоматически вызывается непосредственно перед уничтожением экземпляра класса. Он называется финализатор.

Давайте пропишем такой магический метод в классе Point, следующим образом:

    def __del__(self):
        print("Удаление экземпляра: "+ str(self))

Здесь по-прежнему self – это ссылка на экземпляр класса, который будет удален.

После запуска программы видим, что объект в конце программы действительно был удален и вызван метод del. Но, здесь у вас может возникнуть вопрос: а когда и в какой момент вообще происходит удаление объектов. Мы же в программе это явно нигде не указываем? Работает все достаточно просто. Интерпретатор языка Python имеет, так называемый, сборщик мусора. Это алгоритм, который отслеживает объекты и как только они становятся ненужными, удаляет их. Но как он определяет нужный объект или ненужный? Все очень просто. Пока на какой-либо объект ведет хотя бы одна внешняя ссылка, то он считается используемым и сохраняется в памяти. Как только все внешние ссылки пропадают, то сборщик мусора его уничтожает (освобождает память, которую он занимал).

Итак, из этого занятия вы должны знать, что такое магический метод и как работают инициализатор объекта и его финализатор. А также в какой момент и когда они вызываются. Если все это понятно, то жду всех вас на следующем занятии.

Урок 5 · Часть II. ООП на Python

Магический метод <strong>new</strong>. Пример паттерна Singleton

Источник: magicheskiy-metod-new-primer-patterna-singleton

На этом занятии мы познакомимся с еще одним магическим методом new, который вызывается непосредственно перед созданием объекта класса. Я напомню, что другой магический метод init вызывается после создания объекта (о нем мы говорили на предыдущем занятии).

Здесь у вас может сразу возникнуть вопрос, зачем нужно было определять два разных метода, которые последовательно вызываются при создании экземпляров классов? Разве не достаточно одного init, чтобы выполнять начальную инициализацию объекта? Конечно, нет. В практике программирования встречаются самые разнообразные задачи и иногда нужно что-то делать и до создания объектов. Например, реализация известного паттерна Singleton в Python, как раз делается через метод new и мы с ним позже познакомимся.

А для начала нам нужно познакомиться с работой самого метода new. Давайте добавим его в наш класс Point. Я его перепишу в сокращенной форме:

class Point:
    def __new__(cls, *args, **kwargs):
        print("вызов __new__ для " + str(cls))
 
    def __init__(self, x=0, y=0):
        print("вызов __init__ для " + str(self))
        self.x = x
        self.y = y

Смотрите, здесь записан метод new, у которого первым идет обязательный параметр cls – это ссылка на текущий класс Point, а затем, указываются коллекции из фактических и формальных параметров, которые может принимать данная функция. Это стандартное определение метода new в классах. В теле функции я просто сделал вывод сообщения и переменной cls.

Если теперь попробовать создать экземпляр класса:

pt = Point(1, 2)

то мы в консоли увидим только одно сообщение от метода new. То есть, второй метод init не был вызван и, кроме того, если мы распечатаем переменную pt:

print(pt)

то увидим значение None, то есть, объект не был создан. Почему так произошло? В Python магический метод new должен возвращать адрес нового созданного объекта. А в нашей программе он ничего не возвращает, то есть, значение None, что эквивалентно отказу в создании нового объекта. Именно поэтому переменная pt принимает значение None.

Хорошо, давайте адрес нового объекта. Но откуда мы его возьмем? Для этого можно вызвать аналогичный метод базового класса и делается это, следующим образом:

    def __new__(cls, *args, **kwargs):
        print("вызов __new__ для " + str(cls))
        return super().__new__(cls)

Здесь функция super() возвращает ссылку на базовый класс и через нее мы вызываем метод new с одним первым аргументом. Но, подождите! Что это за базовый класс? Мы наш класс Point ни от какого класса не наследовали? Да и вообще еще не изучали тему наследования! Да, поэтому, забегая вперед, скажу, что, начиная с версии Python 3, все классы автоматически и неявно наследуются от базового класса object:

Иллюстрация к уроку

И уже из этого базового класса мы вызываем метод new. Кстати, если метод new не прописывать в классе Point, то будет автоматически запускаться версия базового класса. То есть, этот метод всегда вызывается при создании нового объекта. При необходимости, мы можем его переопределять, добавляя новую логику его работы. И то же самое относится ко всем магическим методам. Они всегда существуют у всех классов. Но переопределяем мы лишь те, что необходимо, а остальные работают по умолчанию. В этом сила базового класса object. В нем уже существует программный код, общий для всех классов языка Python. Иначе, нам пришлось бы его каждый раз прописывать заново.

Итак, теперь мы знаем откуда берется и вызывается магический метод new. Запустим программу и видим в консоли, что были вызваны оба метода new и init нашего класса Point, а также был успешно сформирован новый объект.

Возможно, здесь у вас остался один вопрос: а зачем нужны списки параметров *args, **kwargs в методе new? Мы, вроде, их нигде не используем? В действительности, здесь хранятся дополнительные параметры, которые мы можем указывать при создании объекта. Например, строчка:

pt = Point(1, 2)

создает объект с двумя числовыми значениями, то есть, *args будет содержать эти два числа. По идее, мы можем реализовать в методе new какую-либо логику с учетом значений этих аргументов. Но, в данном случае, просто игнорируем. Используем их дальше в методе init при инициализации объекта. То есть, аргументы 1 и 2 передаются и в метод new и в метод init.

Пример паттерна Singleton (учебный)

Думаю, вы в целом теперь представляете себе работу магического метода new, но остается вопрос: зачем все же он нужен? В качестве ответа я приведу пример очень известного паттерна проектирования под названием Singleton. Этот паттерн будет представлен в учебном варианте, то есть, мы его реализуем не полностью, т.к. пока отсутствуют достаточные знания.

Итак, давайте предположим, что мы разрабатываем класс для работы с БД. В частности, через него можно будет подключаться к СУБД, читать и записывать информацию, закрывать соединение:

class DataBase:
    def __init__(self, user, psw, port):
        self.user = user
        self.psw = psw
        self.port = port
 
    def connect(self):
        print(f"соединение с БД: {self.user}, {self.psw}, {self.port}")
 
    def close(self):
        print("закрытие соединения с БД")
 
    def read(self):
        return "данные из БД"
 
    def write(self, data):
        print(f"запись в БД {data}")

И далее полагаем, что в программе должен существовать только один экземпляр этого класса в каждый момент ее работы. То есть, одновременно два объекта класса DataBase быть не должно. Чтобы это обеспечить и гарантировать, как раз и используется паттерн Singleton. Реализуем его для класса DataBase.

Я пропишу в нем специальный атрибут (на уровне класса):

__instance = None

который будет хранить ссылку на экземпляр этого класса. Если экземпляра нет, то атрибут будет принимать значение None. А, затем, чтобы гарантировать создание строго одного экземпляра, добавим в класс магический метод new:

    def __new__(cls, *args, **kwargs):
        if cls.__instance is None:
            cls.__instance = super().__new__(cls)
 
        return cls.__instance

Работает этот метод очевидным образом. Мы проверяем атрибут класса __instance. Причем, для обращения к нему используем параметр cls – ссылку на текущий класс. Подробнее я еще освещу этот момент. Далее, проверяем, если значение равно None, то вызываем метод new базового класса и тем самым разрешаем создание объекта. Иначе, просто возвращаем ссылку на ранее созданный экземпляр. Как видите, все достаточно просто.

И пропишем еще один магический метод – финализатор del, который будет обнулять атрибут __instance перед уничтожением объекта, чтобы мы могли, при необходимости, создать новый.

Все, простейший вариант паттерна Singleton готов. Правда он имеет один изъян. Смотрите, если попробовать создать два экземпляра:

db = DataBase('root', '1234', 80)
db2 = DataBase('root2', '5678', 40)
print(id(db), id(db2))

то их id ожидаемо будут равны. То есть, ссылки db и db2 действительно ведут на один объект. Но, если выполнить метод:

db.connect()
db2.connect()

то увидим значения: ‘root2’, ‘5678’, 40 – аргументы при повторном создании класса. По идее, если объект не создается, то и локальные свойства его также не должны меняться. Почему так произошло? Все просто. Мы здесь действительно видим первый объект. Но при повторном вызове DataBase() также был вызван магический метод init с новым набором аргументов и локальные свойства изменили свое значение. Конечно, мы можем здесь поставить «костыль» (как говорят в программисты) и дополнительно в классе прописать флаговый атрибут, например:

__is_exist = False

специально для метода init, чтобы не выполнять его если объект уже создан. Но я даже не буду дописывать такую программу. Слишком уж костыльно получается. Правильнее было бы здесь переопределить еще один магический метод call, о котором мы еще будем говорить. А пока оставим нашу реализацию паттерна Singleton в таком виде.

Я, надеюсь, что из этого занятия вы поняли, как работает магический метод new и зачем он нужен. Если все это понятно, то переходите к следующему занятию.

Урок 6 · Часть II. ООП на Python

Методы класса (classmethod) и статические методы (staticmethod)

Источник: metody-klassa-classmethod-i-staticheskie-metody-staticmethod

Мы продолжаем тему методов в ООП. До сих пор мы с вами определяли методы просто как функции внутри класса, например:

class Vector:
    def __init__(self, x, y):
        self.x = x
        self.y = y
 
    def get_coord(self):
        return self.x, self.y

И у каждого такого метода, как правило, первым идет параметр self – ссылка на экземпляр класса, из которого метод был вызван:

v = Vector(10, 20)
coord = v.get_coord()
print(coord)

В данном случае, при вызове метода get_coord () параметр self будет вести на объект v класса Vector. Об этом мы с вами уже говорили. Также отмечали, что при вызове такого метода напрямую из класса нужно явно указывать первый аргумент self:

coord2 = Vector.get_coord(v)

Так вот, в Python помимо таких «стандартных» методов можно задавать методы уровня класса и статические методы с помощью встроенных декораторов:

@classmethod и @staticmethod

Давайте я поясню на простом примере, что они значат. Добавим в наш класс Vector два атрибута:

class Vector:
    MIN_COORD = 0
    MAX_COORD = 100
...

А также метод класса:

    @classmethod
    def validate(cls, arg):
        return cls.MIN_COORD <= arg <= cls.MAX_COORD

который проверяет, попадает ли значение arg в диапазон [MIN_COORD; MAX_COORD]. Обратите внимание, у методов класса (когда мы используем декоратор classmethod) первым параметром идет cls – ссылка на класс, а не self – ссылка на объект класса. Это означает, что данный метод может обращаться только к атрибутам текущего класса, но не к локальным свойствам его экземпляров. Мало того, этот метод можно теперь напрямую вызывать из класса, не передавая ссылку на экземпляр, как это было при вызове обычных методов через класс:

res = Vector.validate(5)
print(res)

Здесь пользователь класса Vector может совершенно спокойно вызывать метод validate(), не создавая никаких объектов. Но «платой» за это является ограниченность метода: он может работать только с атрибутами класса, но не объекта, что, в общем то, естественно, так как у него изначально нет ссылки на объект. Во всем остальном этот метод работает абсолютно также, как и любой другой метод, объявленный в классе.

Давайте мы им воспользуемся и вызовем внутри класса для проверки корректности координат x, y:

    def __init__(self, x, y):
        self.x = self.y = 0
        if Vector.validate(x) and Vector.validate(y):
            self.x = x
            self.y = y

Обратите внимание, мы здесь обращаемся к методу класса через пространство имен Vector. Но также можем прописать и self:

if self.validate(x) and self.validate(y):

В этом случае интерпретатор Python сам подставит нужный класс в параметр cls данного метода, так как экземпляр содержит информацию о классе, от которого был образован.

Наконец, третий тип методов – статические методы, определяются декоратором @staticmethod. Это методы, которые не имеют доступа ни к атрибутам класса, ни к атрибутам его экземпляров, то есть, некая независимая, самостоятельная функция, объявленная внутри класса. Обычно, это делают для удобства, т.к. их функционал так или иначе связан с тематикой класса.

Например, в нашем классе Vector можно объявить такой статический метод, который бы вычислял квадратичную норму вектора (длину вектора в квадрате):

    @staticmethod
    def norm2(x, y):
        return x*x + y*y

Здесь нет никаких скрытых параметров, которые бы автоматически заполнялись интерпретатором языка. Только те, что мы прописываем сами. Я указал два параметра x, y, по которым вычисляется квадрат длины радиус-вектора. То есть, это некая вспомогательная, сервисная функция, связанная с векторами, для вычисления квадратичной нормы любого радиус-вектора. Воспользоваться этим методом можно как вне класса:

res = Vector.norm2(5, 6)

Так и внутри класса:

    def __init__(self, x, y):
        self.x = self.y = 0
        if self.validate(x) and self.validate(y):
            self.x = x
            self.y = y
 
        print(Vector.norm2(self.x, self.y))

Либо, также обратиться к этому методу через self:

print(self.norm2(self.x, self.y))

Подведем итог различных типов методов в классах. Обычные методы, как правило, вызываются из экземпляров классов и работают с атрибутами экземпляров и атрибутами классов. Методы классов обычно вызываются через класс, реже через его экземпляры и имеют доступ только к атрибутам самого класса, в котором объявлены. Наконец, статические методы – это совершенно изолированные функции, которые работают только с параметрами, прописанными в ней самой и не имеют доступа к атрибутам класса или его экземпляров.

Поэтому, если вам нужен метод, который работает с атрибутами объектов класса, то это обычное определение функций внутри класса с первым параметром self. Если метод работает только с атрибутами класса, то возможно, имеет смысл его определить как метод класса и тогда можно будет вызывать без ссылки на объект этого класса. Третий тип, статические методы часто определяют как вспомогательные, сервисные, связанные с логикой работы самого класса.

Вот общее руководство по выбору этих методов. Надеюсь, из этого занятия вам стало понятно, что такое методы класса и статические методы, а также для чего имеет смысл их использовать.

Практика 1 · Часть II. ООП на Python

Классы, объекты, методы

Задания для закрепления темы · решений нет

Цели обучения

  • Моделировать реальные сущности классами, атрибутами экземпляра и методами
  • Использовать __init__ для инициализации и понимать жизненный цикл объекта
  • Реализовать Singleton через __new__
  • Правильно выбирать между методами экземпляра, класса и статическими методами

Задания

Задание 1. Запись о книге в каталоге

Сложность: лёгкое

Реализуйте класс Book, который хранит название, автора и год.

Требования:

  • __init__(self, title: str, author: str, year: int)
  • Метод экземпляра info(self) -> str, возвращающий "Title by Author (year)"
  • Атрибут класса genre_default = "fiction", доступный на каждом экземпляре, если не переопределён

Пример:

b = Book("Dune", "Frank Herbert", 1965)
assert b.info() == "Dune by Frank Herbert (1965)"
assert Book.genre_default == "fiction"

Задание 2. Счётчик с общим состоянием класса

Сложность: лёгкое

Реализуйте ClickCounter, который отслеживает, сколько экземпляров было создано.

Требования:

  • Атрибут класса created = 0
  • Каждый __init__ увеличивает created
  • Атрибут экземпляра clicks с начальным значением 0
  • Методы click(self) -> None и reset(self) -> None

Пример:

a, b = ClickCounter(), ClickCounter()
assert ClickCounter.created == 2
a.click(); a.click()
assert a.clicks == 2 and b.clicks == 0

Задание 3. Температура с фабричными методами

Сложность: среднее

Реализуйте Temperature, хранящий значение в градусах Цельсия.

Требования:

  • __init__(self, celsius: float)
  • @classmethod from_fahrenheit(cls, f: float) -> Temperature
  • @classmethod from_kelvin(cls, k: float) -> Temperature
  • @staticmethod celsius_to_fahrenheit(c: float) -> float
  • Метод экземпляра as_fahrenheit(self) -> float

Пример:

t = Temperature.from_fahrenheit(32)
assert abs(t.celsius - 0.0) < 1e-9
assert abs(Temperature.celsius_to_fahrenheit(100) - 212) < 1e-9

Задание 4. Ресурс с финализатором

Сложность: среднее

Реализуйте TempFileHandle, имитирующий открытие ресурса.

Требования:

  • __init__(self, name: str) задаёт self.name, self.open = True
  • Метод close(self) -> None устанавливает open = False
  • __del__(self) вызывает close(), если ресурс ещё открыт (безопасно: не возбуждайте исключения)
  • Имена закрытых ресурсов записывайте в список класса closed_log: list[str] при закрытии через __del__ или close

Подсказки:

  • Держите __del__ минимальным: только меняйте состояние и дополняйте лог

Задание 5. Config Singleton

Сложность: среднее

Реализуйте AppConfig как Singleton с помощью __new__.

Требования:

  • Существует только один экземпляр при любых конструкциях
  • __init__(self, **kwargs) объединяет kwargs в self.settings: dict только при первой инициализации (или всегда — зафиксируйте свой выбор)
  • Метод get(self, key: str, default=None)
  • Метод класса reset(cls), очищающий синглтон (для тестов)

Пример:

AppConfig.reset()
a = AppConfig(debug=True)
b = AppConfig(host="localhost")
assert a is b
assert a.get("debug") is True

Задание 6. Мини-проект: фабрика Point и Rectangle

Сложность: сложное

Соберите небольшой геометрический API.

Требования:

  • Класс Point с x, y; метод distance_to(self, other: Point) -> float
  • Класс Rectangle с двумя противоположными углами p1, p2 (Point)
  • Методы: width, height, area, contains(self, point: Point) -> bool
  • @classmethod Rectangle.from_size(cls, origin: Point, width: float, height: float) -> Rectangle
  • @staticmethod Rectangle.overlap_area(a: Rectangle, b: Rectangle) -> float (0, если пересечения нет)

Пример:

r = Rectangle.from_size(Point(0, 0), 10, 5)
assert r.area() == 50
assert r.contains(Point(3, 2))

Глава 2

Контроль доступа, property, атрибуты

Урок 7 · Часть II. ООП на Python

Режимы доступа public, private, protected. Сеттеры и геттеры

Источник: rezhimy-dostupa-public-private-protected-settery-i-gettery

На прошлых занятиях мы научились с вами создавать экземпляры классов и объявлять в них атрибуты и методы. Пришла пора сделать следующий шаг и познакомиться с механизмом ограничения доступа к данным и методам класса извне. Это основа механизма инкапсуляции.

Давайте предположим, что мы описываем класс представления точки на плоскости:

class Point:
    def __init__(self, x=0, y=0):
        self.x = x
        self.y = y

Когда создается экземпляр этого класса:

pt = Point(1, 2)

то имеется полный доступ ко всем его локальным атрибутам:

print(pt.x, pt.y)

а, значит, их всегда можно изменить через ссылку pt:

pt.x = 200
pt.y = "coord_y"

и присвоить любые значения, в том числе и недопустимые (например, строку).

Так вот, чтобы указать программисту (пользователю класса), чтобы он не обращался напрямую к атрибутам, их следует делать «закрытыми». Что это такое? Смотрите, в Python возможны следующие варианты доступа к данным:

  • attribute (без одного или двух подчеркиваний вначале) – публичное свойство (public);
  • _attribute (с одним подчеркиванием) – режим доступа protected (служит для обращения внутри класса и во всех его дочерних классах)
  • __attribute (с двумя подчеркиваниями) – режим доступа private (служит для обращения только внутри класса).

Давайте разберем это подробнее. До сих пор все атрибуты в классе, либо в экземплярах класса мы делали публичными, то есть, не использовали одно или два подчеркивания перед их именами. Давайте посмотрим, что изменится, если добавить одно подчеркивание перед локальными атрибутами x и y:

class Point:
    def __init__(self, x=0, y=0):
        self._x = x
        self._y = y

Так реализуется режим protected в Python. Если кто из вас программирует на других языках, например, С++ или Java, то сейчас ожидают, что мы не сможем обращаться к свойствам _x и _y через ссылку pt, так как они определены как защищенные (protected). Давайте проверим и попробуем вывести их в консоль:

print(pt._x, pt._y)

Как видим, никаких ошибок не возникает и все работает так, словно это публичные свойства экземпляра класса. Но тогда зачем нам писать это нижнее подчеркивание, если оно не играет никакой роли? Одна роль у этого префикса все-таки есть: нижнее подчеркивание должно предостерегать программиста от использования этого свойства вне класса. Впоследствии это может стать причиной непредвиденных ошибок. Например, изменится версия класса и такое свойство может перестать существовать, т.к. никто не предполагал доступа к нему извне. Так что, к таким атрибутам лучше не обращаться напрямую – одно нижнее подчеркивание указывает нам, что это внутренние, служебные переменные.

Давайте теперь посмотрим, как работает режим доступа private. Пропишем у локальных свойств два подчеркивания:

class Point:
    def __init__(self, x=0, y=0):
        self.__x = x
        self.__y = y

и также попробуем обратиться к ним напрямую:

print(pt.__x, pt.__y)

После запуска программы видим ошибку, что такие свойства не определены. Это говорит о том, что извне, через переменную pt мы не можем напрямую к ним обращаться. А вот внутри класса доступ к ним открыт.

Пропишем метод set_coord, который будет менять локальные свойства __x и __y экземпляра класса:

    def set_coord(self, x, y):
        self.__x = x
        self.__y = y

А ниже, вызовем его для экземпляра pt:

pt.set_coord(1, 2)

Как видите, никаких ошибок не возникает и чтобы убедиться в изменении локальных приватных свойств, определим еще один метод:

    def get_сoord(self):
        return self.__x, self.__y

И вызовем его:

print(pt.get_сoord())

После запуска программы видим измененные координаты точки. В результате, мы с вами определили два вспомогательных метода: set_coord и get_coord, через которые предполагается работа с защищенными данными класса. Такие методы в ООП называются сеттерами игеттерами или еще интерфейсными методами.

Зачем понадобилось в классах создавать приватные атрибуты да еще и определять дополнительно методы для работы с ними извне. Я об этом уже говорил на самом первом занятии по ООП, когда объяснял принцип инкапсуляции. Но, скажу еще раз. Класс в ООП следует воспринимать как некое единое целое, и чтобы случайно или намеренно не нарушить целостность работы алгоритма внутри этого класса, то следует взаимодействовать с ним только через публичные свойства и методы. В этом суть принципа инкапсуляции. Опять же, представьте автомобиль, в котором согласованно работают тысячи узлов. А управление им предполагается только через разрешенные интерфейсы: руль, коробка передач, педали газа и тормоза и т.п. Если во время движения вмешиваться напрямую в его узлы, например, будем на ходу спускать воздух из шин, то, наверное, ничего хорошего не получится. То же самое, можно сказать и о программисте, который намеренно обходит запрет и обращается к скрытым атрибутам класса напрямую, а не через сеттеры или геттеры. Так делать не нужно.

Назначение интерфейсных методов не только передавать значения между приватными атрибутами класса, но и проверять их корректность. Например, в нашем случае координаты должны быть числами. Поэтому, прежде чем обновлять значения переменных, следует проверить их тип данных. Для этого можно воспользоваться функцией type и записать сеттер следующим образом:

    def set_coord(self, x, y):
        if type(x) in (int, float) and type(y) in (int, float):
            self.__x = x
            self.__y = y
        else:
            raise ValueError("Координаты должны быть числами")

Здесь мы проверяем, что обе переданные переменные x и y должны иметь тип int или float и только после этого приватным атрибутам экземпляра класса присваиваются новые значения. Иначе, генерируется исключение ValueError. Об исключениях мы с вами еще будем говорить.

Теперь, если передавать недопустимые значения координат:

pt.set_coord('1', 2)

то увидим ошибку ValueError.

Продолжим совершенствовать наш класс Point и добавим приватный метод для проверки корректности координат. Приватный метод объявляется также как и приватная переменная – двумя подчеркиваниями и, кроме того, сделаем его методом уровня класса (о декораторе classmethod мы с вами говорили на предыдущем занятии):

    @classmethod
    def __check_value (cls, x):
        return type(x) in (int, float)

Соответственно, в сеттере и в инициализаторе воспользуемся этим методом:

    def __init__(self, x=0, y=0):
        self.__x = self.__y = 0
 
        if self.__check_value (x) and self.__check_value (y):
            self.__x = x
            self.__y = y
 
    def set_coord(self, x, y):
        if self.__check_value (x) and self.__check_value (y):
            self.__x = x
            self.__y = y
        else:
            raise ValueError("Координаты должны быть числами")

Запускаем программу и видим, что все работает. Но, при этом, доступа к этому методу извне нет, он приватный.

На самом деле, в Python можно относительно легко обратиться и к приватным атрибутам извне. Если распечатать все атрибуты экземпляра:

print(dir(pt))

то среди прочих мы увидим, следующие:

’_Point__x’, ‘_Point__y’

Это и есть кодовые имена приватных атрибутов, к которым мы можем обратиться через ссылку pt:

print(pt._Point__x, pt._Point__y)

и менять их. Однако, так делать крайне не рекомендуется и двойное подчеркивание должно сигнализировать программисту, что работать с такими атрибутами нужно только через разрешенные интерфейсные методы. Иначе, возможны непредвиденные ошибки.

Если у вас появилась необходимость лучше защитить методы класса от доступа извне, то это можно сделать с помощью модуля accessify. Для его установки нужно выполнить команду:

pip install accessify

И, затем, импортировать из него два декоратора:

from accessify import private, protected

Далее, нужный декоратор просто применяем к методу и он становится либо приватным (private), либо защищенным (protected):

    @private
    @classmethod
    def check_value(cls, x):
        return type(x) in (int, float)

Все, теперь мы можем обратиться к check_value только внутри класса, но не извне:

pt.check_value(5)

Я, думаю, из этого занятия вам стало понятно, как реализуются режимы доступа public, protected и private, а также, как правильно обращаться к скрытым атрибутам через интерфейсные методы – сеттеры и геттеры.

Урок 8 · Часть II. ООП на Python

Магические методы <strong>setattr</strong>, <strong>getattribute</strong>, <strong>getattr</strong> и <strong>delattr</strong>

Источник: magicheskie-metody-setattr-getattribute-getattr-i-delattr

На этом занятии мы поговорим о работе с атрибутами класса и его экземплярами. Я напомню, что класс можно воспринимать как некое пространство имен, в котором записаны свойства и методы. Например, если вернуться к классу Point (представления точки на плоскости):

class Point:
    MAX_COORD = 100
    MIN_COORD = 0
 
    def __init__(self, x, y):
        self.x = x
        self.y = y
 
    def set_coord(self, x, y):
        self.x = x
        self.y = y

то здесь мы видим определение четырех атрибутов: двух свойств MAX_COORD и MIN_COORD и двух методов init и set_coord. Это атрибуты класса и при создании экземпляров:

pt1 = Point(1, 2)
pt2 = Point(10, 20)

Эти атрибуты остаются в пространстве имен класса, не копируются в экземпляры. Но из экземпляров мы можем совершенно спокойно к ним обращаться, так как пространство имен объектов содержит ссылку на внешнее пространство имен класса. Если какой-либо атрибут не существует в экземпляре, то поиск переходит во внешнее пространство, то есть, в класс и поиск продолжается там. Поэтому мы совершенно спокойно можем через экземпляр обратиться к свойству класса MAX_COORD:

print(pt1.MAX_COORD)

И получается, что атрибуты и методы класса – это общие данные для всех его экземпляров.

Далее, когда мы обращаемся к атрибутам класса внутри методов, объявленных в этом классе, то должны не просто прописать их имена:

    def set_coord(self, x, y):
        if MIN_COORD <= x <= MAX_COORD:
            self.x = x
            self.y = y

а явно указать перед ними ссылку на класс, то есть, на пространство имен. Либо так:

if Point.MIN_COORD <= x <= Point.MAX_COORD:

но лучше через self:

if self.MIN_COORD <= x <= self.MAX_COORD:

Здесь self – это ссылка на экземпляр класса, из которого метод вызывается, поэтому мы можем через этот параметр обращаться к атрибутам класса.

Обо всем этом мы с вами уже говорили, я лишь еще раз повторил эти важные моменты. А теперь один нюанс, о который спотыкаются многие начинающие программисты. Давайте предположим, что нам нужен метод, который бы изменял значение атрибута класса MIN_COORD. Пропишем его как обычный метод:

    def set_bound(self, left):
        self.MIN_COORD = left

Иногда ошибочно здесь рассуждают так. Мы обращаемся к атрибуту класса MIN_COORD и присваиваем ему новое значение left. Те из вас, кто внимательно смотрел предыдущие занятия, понимают, в чем ошибочность такого рассуждения. Да, когда мы через self (ссылку на объект) записываем имя атрибута и присваиваем ему какое-либо значение, то оператор присваивания создает этот атрибут в локальной области видимости, то есть, в самом объекте. В результате, у нас появляется новое локальное свойство в экземпляре класса:

pt1.set_bound(-100)
print(pt1.__dict__)

А в самом классе одноименный атрибут остается без изменений:

print(Point.__dict__)

Поэтому, правильнее было бы здесь объявить метод уровня класса и через него менять значения атрибутов MIN_COORD и MAX_COORD:

    @classmethod
    def set_bound(cls, left):
        cls.MIN_COORD = left

Тогда в самом объекте не будет создаваться никаких дополнительных свойств, а в классе изменится значение переменной MIN_COORD, так, как мы этого и хотели.

Будем полагать, что мы теперь с вами хорошо понимаем, как обращаться к атрибутам класса и его объектов. Во второй части занятия я хочу вам рассказать о четырех магических методах, которые используются при работе с атрибутами:

  • setattr(self, key, value)__ – автоматически вызывается при изменении свойства key класса;
  • getattribute(self, item) – автоматически вызывается при получении свойства класса с именем item;
  • getattr(self, item) – автоматически вызывается при получении несуществующего свойства item класса;
  • delattr(self, item) – автоматически вызывается при удалении свойства item (не важно: существует оно или нет).

Работают они достаточно просто. Начнем с метода getattribute и с его помощью ограничим доступ к приватным свойствам __x и __y экземпляра. Для простоты я переопределю класс Point, следующим образом:

class Point:
    MAX_COORD = 100
    MIN_COORD = 0
 
    def __init__(self, x, y):
        self.__x = x
        self.__y = y
 
    def __getattribute__(self, item):
        print("__getattribute__")
        return object.__getattribute__(self, item)

Здесь добавлен новый магический метод getattribute. Он автоматически вызывается, когда идет считывание атрибута через экземпляр класса. Например, при обращении к свойству MIN_COORD:

print(pt1.MIN_COORD)

Или к приватному свойству через специальное имя:

print(pt1._Point__x)

Но раз это так, то давайте явно запретим считывать такой атрибут из экземпляра класса. Для этого пропишем в методе getattribute проверку:

    def __getattribute__(self, item):
        if item == "_Point__x":
            raise ValueError("Private attribute")
        else:
            return object.__getattribute__(self, item)

То есть, мы смотрим, если идет обращение к приватному атрибуту по внешнему имени _Point__x, то генерируем исключение ValueError. И, действительно, после запуска программы видим отображение этой ошибки в консоли. Вот так, через магический метод getattribute можно реализовывать определенную логику при обращении к атрибутам через экземпляр класса.

Следующий магический метод setattr автоматически вызывается в момент присваивания атрибуту нового значения. Пропишем формально этот метод в классе Point:

    def __setattr__(self, key, value):
        print("__setattr__")
        object.__setattr__(self, key, value)

После запуска видим несколько сообщений «setattr». Это связано с тем, что в момент создания экземпляров класса в инициализаторе init создавались локальные свойства __x и __y. В этот момент вызывался данный метод. Также в переопределенном методе setattr мы должны вызывать соответствующий метод из базового класса object, иначе, локальные свойства в экземплярах создаваться не будут.

Давайте теперь для примера через этот магический метод запретим создание локального свойства с именем z. Сделаем это следующим образом:

    def __setattr__(self, key, value):
        if key == 'z':
            raise AttributeError("недопустимое имя атрибута")
        else:
            object.__setattr__(self, key, value)

Обратите внимание, что внутри метода setattr нельзя менять свойства напрямую:

    def __setattr__(self, key, value):
        if key == 'z':
            raise AttributeError("недопустимое имя атрибута")
        else:
            self.__x = value

В этом случае метод setattr начнет выполняться по рекурсии, пока не возникнет ошибка достижения максимальной глубины рекурсии. Если нужно сделать что-то подобное, то используйте коллекцию dict:

self.__dict__[key] = value

или, если требуется стандартное поведение метода, то вызывайте его из класса object, как это мы прописывали вначале:

object.__setattr__(self, key, value)

Следующий магический метод getattr автоматически вызывается, если идет обращение к несуществующему атрибуту. Добавим его в наш класс:

    def __getattr__(self, item):
        print("__getattr__: " + item)

Если ниже обратиться к несуществующему свойству, например:

print(pt1.a)

то увидим сообщение «getattr: a» и значение None, которое вернул данный метод. Если же прописать существующий атрибут:

print(pt1.MAX_COORD)

то этот магический метод уже не вызывается. Зачем он может понадобиться? Например, нам необходимо определить класс, в котором при обращении к несуществующим атрибутам возвращается значение False, а не генерируется исключение. Для этого записывается метод getattr в виде:

    def __getattr__(self, item):
        return False

Наконец, последний магический метод delattr вызывается в момент удаления какого-либо атрибута из экземпляра класса:

    def __delattr__(self, item):
        print("__delattr__: "+item)

Добавим новое локальное свойство в экземпляр pt1:

pt1.a = 10

затем выполним команду его удаления:

del pt1.a

и видим, что действительно был вызван метод delattr, правда, сам атрибут удален не был:

print(pt1.__dict__)

Это из-за того, что внутри этого метода нужно вызвать соответствующий метод класса object, который и выполняет непосредственное удаление:

    def __delattr__(self, item):
        object.__delattr__(self, item)

Я думаю, что из этого занятия вы хорошо себе уяснили, как происходит обращение к атрибутам класса и как можно управлять доступом к ним через магические методы.

Урок 9 · Часть II. ООП на Python

Паттерн моносостояние

Источник: pattern-monosostoyanie

На этом занятии мы рассмотрим реализацию паттерна «Моносостояние», реализуемое на уровне классов и объектов. На примере этого паттерна я хочу вам показать, как можно в Python легко и гибко управлять локальными атрибутами экземпляров класса.

Вначале разберем саму идею «Моносостояния». Представьте, что у нас некий многопоточный процесс и в каждом потоке создается свой экземпляр класса ThreadData. Но нам бы хотелось, чтобы все они имели единые локальные свойства:

Иллюстрация к уроку

Обратите внимание, имели бы именно единые локальные свойства, а не просто одни и те же данные, то есть, их словарь dict был бы одинаков для всех этих экземпляров.

Реализуется на Python это очень просто. Объявим класс и в нем пропишем приватный словарь с некоторыми начальными свойствами, которыми будет обладать каждый экземпляр (или же этот словарь может быть пустым):

class ThreadData:
    __shared_attrs = {
        'name': 'thread_1',
        'data': {},
        'id': 1,
    }
 
    def __init__(self):
        self.__dict__ = self.__shared_attrs

Затем, в инициализаторе этого класса, переопределим специальную коллекцию dict на общий словарь __shared_attrs. Таким образом, коллекция dict в каждом экземпляре будет ссылаться на один и тот же словарь класса __shared_attrs, а значит, все они будут иметь общие локальные свойства.

Я напомню, что список локальных свойств каждого конкретного экземпляра класса определяется словарем dict и если у всех объектов он будет един, то едины окажутся и их локальные свойства.

Давайте посмотрим, как это будет работать. Создадим экземпляр класса th1:

th1 = ThreadData()

В консоли можно видеть, что автоматически были созданы свойства экземпляра: name, data и id, как раз те, что прописаны в словаре __shared_attrs.

Создадим второй экземпляр:

th2 = ThreadData()

Видим, что у него те же самые свойства по умолчанию. Причем, эти свойства воспринимаются как локальные. Поэтому, если их переопределить, например:

th2.id = 3

то изменения коснутся именно словаря __shared_attrs и все объекты класса ThreadData также изменят значение этого атрибута.

Также мы можем совершенно свободно создавать новые свойства:

th1.attr_new = 'new attr'

и оно появляется во всех экземплярах этого класса.

Вот так реализуется паттерн «Моносостояние» на языке Python. Возможно, у вас здесь остался вопрос, а где все это используется? Честно говоря, паттерн «Моносостояние» мне ни разу не приходилось применять. Я привел его здесь, так как он хорошо показывает, как гибко можно управлять поведением объектов класса за счет переопределения ссылки стандартного свойства dict в каждом экземпляре, чтобы он вел на общий словарь __shared_attrs. Меняя эту коллекцию, оказывается можно существенно менять стандартное поведение экземпляров класса касательно их локальных атрибутов. Это и было целью данного занятия. Расширить ваше понимание о работе с атрибутами объектов классов. И, надеюсь, мне это удалось.

Урок 10 · Часть II. ООП на Python

Свойства property. Декоратор @property

Источник: svoystva-property-dekorator-property

На этом занятии вы узнаете о более удобном способе работы с приватными атрибутами через специальный объект property, который переводится как свойство. О чем здесь речь? Давайте представим, что мы разрабатываем класс для хранения и обработки данных о персонале:

class Person:
    def __init__(self, name, old):
        self.__name = name
        self.__old = old

И для простоты, в нем будут сохраняться имя и возраст сотрудника в виде приватных атрибутов __name и __old. Разумеется, чтобы обращаться к таким закрытым данным, необходимы сеттеры и геттеры. Пропишем их для возраста:

    def get_old(self):
        return self.__old
 
    def set_old(self, old):
        self.__old = old

Я, надеюсь, вы помните, для чего делают реализации классов с приватными свойствами, а затем, добавляют еще методы для работы с ними? Мы об этом с вами уже говорили. Да, это необходимо, чтобы не нарушалась внутренняя логика работы алгоритма класса, а взаимодействие с классом и его объектами извне осуществлялась бы только через разрешенные (публичные) методы и свойства. Если вам это не понятно, то посмотрите внимательнее предыдущие занятия, а я продолжу.

Итак, теперь можно создать экземпляр этого класса:

p = Person('Сергей', 20)

и через геттер и сеттер считывать и менять возраст сотрудника:

p.set_old(35)
print(p.get_old())

Это все мы с вами уже умеем и знаем. Но здесь есть одна маленькая проблема. Нам нужно прописывать разные сеттеры и геттеры для разных приватных атрибутов экземпляров класса. Например, добавить еще два для имени. В результате, пользователю этого класса (программисту) придется запоминать и держать в голове названия имен всех этих сеттеров и геттеров. Как можно было бы упростить работу с таким классом? Один из способов – воспользоваться объектом property. Давайте посмотрим на конкретном нашем примере, как это можно сделать.

В самом классе Person мы пропишем атрибут и придумаем ему имя, допустим, old. Этот атрибут класса будет ссылаться на объект property, которому мы передадим ссылку на геттер и сеттер:

old = property(get_old, set_old)

Что у нас тут с вами получилось? Смотрите. Из каждого экземпляра класса мы совершенно спокойно можем обращаться к атрибуту класса old. Этот атрибут является объектом property. Данный объект так устроен, что при считывании данных он вызывает первый метод get_old, этот метод возвращает значение приватного локального свойства __old экземпляра класса p и именно это значение дальше возвращается атрибутом old. Поэтому переменная a будет ссылаться на значение текущего возраста сотрудника.

Если же мы обращаемся к атрибуту класса old и присваиваем ему какое-то значение:

p.old = 35

то автоматически вызывается второй метод set_old и в локальное свойство __old заносится значение, указанное после оператора присваивания. В итоге, в текущем объекте p меняется локальное свойство __old на новое.

Здесь у вас может возникнуть резонный вопрос, почему строчка:

p.old = 35

не создает новое локальное свойство внутри объекта p, как это у нас было ранее в программах, а обращается именно к атрибуту класса Person? Все дело в приоритете. Если в классе задан атрибут как объект-свойство, то в первую очередь выбирается оно, даже если в экземпляре класса есть локальное свойство с таким же именем. В этом легко убедиться. Давайте создадим свойство с именем old прямо в объекте p через словарь dict:

p.__dict__['old'] = 'old in object p'

А, затем выведем всю информацию в консоль:

print(p.old, p.__dict__)

Отображается значение 35, а не строка, то есть, было обращение именно к объекту-свойству old класса Person. А если свойству old в классе присвоить, какое-либо числовое значение, например, то будет отображена строка из объекта p. Здесь уже срабатывают знакомые нам приоритеты: сначала локальная область видимости объекта, затем, класса. Вот этот момент нужно хорошо знать, при работе с объектами-свойствами.

Итак, теперь у нас есть класс и мы можем менять приватное свойство __old экземпляров этого класса через единый атрибут old (считывать информацию и записывать). Это гораздо удобнее использования сеттеров и геттеров. Здесь всего один атрибут и через него естественным образом происходит взаимодействие с закрытым свойством __old.

Декоратор @property

Я, думаю, из этого примера вы хорошо поняли, как создается объект property и для чего он нужен. Однако, в нашей реализации есть некое функциональное дублирование: мы можем работать с приватным свойством __old и через сеттер/геттер и через свойство класса old. Конечно, это не критичный момент и на него можно не обращать внимания. Но, на мой взгляд было бы лучше, если бы у нас был один интерфейс взаимодействия со свойством __old. Как это можно сделать?

Смотрите, вот этот класс property позволяет нам на уровне его объектов, использовать функции-декораторы. Если в консоли прописать:

a = property()

то через ссылку a нам будут доступны эти самые функции:

  • a.getter() – декоратор для сеттера;
  • a.setter() – декоратор для геттера;
  • a.deleter() – декоратор для делитера.

Что такое декораторы вы должны уже знать, мы с вами об этом говорили в базовом курсе по Python. Ссылка на этот урок будет под этим видео. В двух словах, декоратор – это функция, которая расширяет функционал другой функции. То есть, вот эту строчку:

old = property(get_old, set_old)

можно переписать и так:

    old = property()
    old = old.setter(set_old)
    old = old.getter(get_old)

Это будет одно и то же. При вызове метода setter осуществляется встраиванием метода set_old в алгоритм работы объекта property. И то же самое делает метод getter только для геттера. В обоих случаях они возвращают ссылку на объект property, который мы должны сохранять.

Так вот, мы можем использовать эти декораторы, чтобы сразу нужный нам метод класса превратить в объект-свойство property. Делается это очень просто. Перед геттером (обратите внимание, именно перед геттером, а не сеттером или делитером) прописывается декоратор:

    @property
    def get_old(self):
        return self.__old

По идее, он теперь представляет объект-свойство с именем get_old:

print(p.get_old)

Но пока присваивание не работает:

p.get_old = 35

так как мы не прописали декоратор для сеттера. Делается это просто. Метод set_old нужно переименовать в get_old, чтобы имена совпадали (это обязательное условие) и перед ним прописать декоратор:

    @get_old.setter
    def get_old(self, old):
        self.__old = old

Все, мы сформировали новый объект-свойство с именем get_old. Давайте его переименуем просто в old, а строчки ниже удалим, получим следующий класс Person:

class Person:
    def __init__(self, name, old):
        self.__name = name
        self.__old = old
 
    @property
    def old(self):
        return self.__old
 
    @old.setter
    def old(self, old):
        self.__old = old

То, что мы сделали, эквивалентно предыдущему варианту с тем лишь отличием, что теперь напрямую вызывать сеттер или геттер для локального свойства __old не получится. У нас остался один интерфейс взаимодействия – объект-свойство old. Именно так чаще всего делают на практике.

В заключение этого занятия добавлю еще один метод делитер, который вызывается при удалении свойства:

    @old.deleter
    def old(self):
        del self.__old

Теперь, если выполнить команду:

del p.old
print(p.__dict__)

то сработает делитер и мы увидим, что локальное свойство __old было удалено. Конечно, его легко снова создать, достаточно выполнить присвоение, то есть, вызвать сеттер:

p.old = 10

Вот так гибко можно работать с приватными (закрытыми) локальными свойствами через объект-свойство property. Надеюсь, из этого занятия вы узнали, что это такое, зачем надо и как формировать свои объекты-свойства или через класс property или через декораторы.

Урок 11 · Часть II. ООП на Python

Пример использования объектов property

Источник: primer-ispolzovaniya-obektov-property

На этом занятии мы рассмотрим один практический пример использования объектов-свойств (property), с которыми познакомились на предыдущем занятии. Надеюсь, что из этого урока вы лучше поймете, зачем они нужны и как применяются на практике.

Давайте, как и на предыдущем занятии, объявим класс Person, который будет представлять данные о персонале некоторого учреждения. Предположим, что отдел кадров от нас требует хранить следующие персональные данные:

  • ФИО;
  • возраст (целое число от 14 до 120);
  • серию и номер паспорта в формате xxxx xxxxxx, где x – цифра (от 0 до 9);
  • вес, в кг (вещественное число от 20 и выше).

Первое, над чем задумывается программист, как описать эти данные на уровне программы. Я сделаю, следующим образом:

  • ФИО – список из трех строк: фамилия, имя, отчество;
  • возраст – целое число;
  • паспорт – строка в нужном формате;
  • вес – вещественное число.

Запишем этот класс со следующим инициализатором:

class Person:
    def __init__(self, fio, old, ps, weight):
        self.__fio = fio.split()
        self.__old = old
        self.__passport = ps
        self.__weight = weight

Но пока здесь мы не учитываем ограничения, накладываемые на данные. Давайте это сделаем. Я пропишу несколько вспомогательных методов класса для проверки корректности каждого переданного значения. Начнем с проверки ФИО. Для этого я пропишу следующий метод:

    @classmethod
    def verify_fio(cls, fio):
        if type(fio) != str:
            raise TypeError("ФИО должно быть строкой")
 
        f = fio.split()
        if len(f) != 3:
            raise TypeError("Неверный формат записи ФИО")
 
        letters = ascii_letters + cls.S_RUS + cls.S_RUS_UPPER
        for s in f:
            if len(s) < 1:
                raise TypeError("В ФИО должен быть хотя бы один символ")
            if len(s.strip(letters)) != 0:
                raise TypeError("В ФИО можно использовать только буквенные символы и дефис")

Дополнительно определю атрибуты S_RUS и S_RUS_UPPER в классе Person:

    S_RUS = 'абвгдеёжзийклмнопрстуфхцчшщьыъэюя-'
    S_RUS_UPPER = S_RUS.upper()

И импортируем коллекцию символов латинского алфавита:

from string import ascii_letters

Все, теперь, при передаче ФИО нужно через пробел записывать фамилию, имя и отчество. Причем, все они должны состоять только из буквенных символов или символа подчеркивания и иметь длину не менее одного символа. Иначе, мы генерируем исключение TypeError с соответствующим сообщением об ошибке.

Чтобы увидеть работу этого метода, пропишем его в инициализаторе:

    def __init__(self, fio, old, ps, weight):
        self.verify_fio(fio)
 
        self.__fio = fio.split()
        self.__old = old
        self.__passport = ps
        self.__weight = weight

Если проверки пройдут успешно, то исключений не возникнет и программа продолжит свою работу, иначе она будет завершена, либо обработано соответствующее исключение. Об обработке исключений мы с вами еще будем говорить.

Давайте попробуем создать объект с верной записью ФИО:

p = Person('Балакирев Сергей Михайлович', 30, '1234 567890', 80.0)

Как видим, никаких ошибок, но если указать что то неверное, то будут появляться ошибки и программа прервет свою работу. Это то, что я бы хотел в данном случае видеть.

Отлично, первый метод проверки мы с вами написали. Добавим еще три. Следующий будет проверять корректность ввода возраста:

    @classmethod
    def verify_old(cls, old):
        if type(old) != int or old < 14 or old > 120:
            raise TypeError("Возраст должен быть целым числом в диапазоне [14; 120]")

Следующий метод по аналогии будет проверять вес:

    @classmethod
    def verify_weight(cls, w):
        if type(w) != float or w < 20:
            raise TypeError("Вес должен быть вещественным числом от 20 и выше")

Наконец, последний метод для проверки корректности серии и номера паспорта:

    @classmethod
    def verify_ps(cls, ps):
        if type(ps) != str:
            raise TypeError("Паспорт должен быть строкой")
 
        s = ps.split()
        if len(s) != 2 or len(s[0]) != 4 or len(s[1]) != 6:
            raise TypeError("Неверный формат паспорта")
 
        for p in s:
            if not p.isdigit():
                raise TypeError("Серия и номер паспорта должны быть числами")

Осталось вызвать все эти методы в инициализаторе, чтобы они отрабатывали соответствующие проверки передаваемых данных:

    def __init__(self, fio, old, ps, weight):
        self.verify_fio(fio)
        self.verify_old(old)
        self.verify_ps(ps)
        self.verify_weight(weight)
 
        self.__fio = fio.split()
        self.__old = old
        self.__passport = ps
        self.__weight = weight

Как видите, все достаточно просто. Теперь, программист уверен, что в приватных свойствах экземпляров класса будут храниться корректные (с точки зрения формата) данные о пользователях.

Следующий шаг – это определить интерфейсы для взаимодействия с этими данными. Для этого воспользуемся объектами-свойствами, о которых говорили на предыдущем занятии.

Первое такое свойство будет для получения доступа к ФИО. Мы определим его через декоратор property, следующим образом:

    @property
    def fio(self):
        return self.__fio

В результате, у нас будет только геттер для получения ФИО сотрудника. Изменить эти данные через объект-свойство fio будет невозможно. Я решил так сделать в учебном примере, чтобы еще раз показать, что мы можем довольно гибко определять эти объекты.

Следующее свойство old будет использоваться и для считывания и для записи возраста:

    @property
    def old(self):
        return self.__old
 
    @old.setter
    def old(self, old):
        self.verify_old(old)
        self.__old = old

Обратите внимание, в сеттере мы также делаем проверку на корректность переданных данных. Проверку делаем с помощью ранее определенного метода verify_old.

Далее, опишем свойство для доступа к паспортным данным:

    @property
    def passport(self):
        return self.__passport
 
    @passport.setter
    def passport(self, ps):
        self.verify_ps(ps)
        self.__passport = ps

И последнее – для веса сотрудника:

    @property
    def weight(self):
        return self.__weight
 
    @weight.setter
    def weight(self, w):
        self.verify_weight(w)
        self.__weight = w

Все, мы описали базовый функционал для хранения указанных данных о сотрудниках с проверкой корректности передаваемых значений. Теперь мы можем воспользоваться этими объектами-свойствами, например, так:

p = Person('Балакирев Сергей Михайлович', 20, '1234 567890', 80.0)
p.old = 100
p.passport = '4567 123456'
p.weight = 70.0
print(p.__dict__)

В данном случае, мы передали корректные данные и они были записаны в соответствующие приватные локальные свойства объекта p.

Кроме того, можно непосредственно в инициализаторе воспользоваться объектами-свойствами, чтобы упростить текст программы:

    def __init__(self, fio, old, ps, weight):
        self.verify_fio(fio)
 
        self.__fio = fio.split()
        self.old = old
        self.passport = ps
        self.weight = weight

Мы здесь сразу через свойства осуществляем создание приватных локальных свойств в объекте и автоматически проверяем корректность переданных данных. Кроме ФИО, т.к. мы для него не определяли сеттер.

Я думаю, из примера этого занятия вы теперь стали лучше себе представлять, как работать с атрибутами класса и объектами-свойствами. На следующем занятии мы разовьем эту тему и поговорим о дескрипторах.

Практика 2 · Часть II. ООП на Python

Контроль доступа, property, атрибуты

Задания для закрепления темы · решений нет

Цели обучения

  • Инкапсулировать состояние через соглашения об именах и геттеры/сеттеры
  • Управлять доступом к атрибутам через магические методы
  • Разделять состояние по паттерну monostate
  • Предоставлять проверенные атрибуты через @property

Задания

Задание 1. Person с приватным возрастом

Сложность: лёгкое

Реализуйте Person с проверяемым возрастом.

Требования:

  • Имя храните публично; возраст — как __age
  • Геттер get_age / сеттер set_age (или методы с такими именами)
  • set_age возбуждает ValueError, если возраст не в диапазоне 0..150
  • Метод birthday(self) увеличивает возраст на 1

Пример:

p = Person("Ada", 30)
p.set_age(31)
assert p.get_age() == 31

Задание 2. Строгий Product через property

Сложность: лёгкое

Реализуйте Product с помощью @property.

Требования:

  • Свойства name (непустая str) и price (float > 0)
  • Некорректное присваивание возбуждает ValueError
  • Свойство только для чтения tag, возвращающее f"{name}:{price:.2f}"

Задание 3. Заблокированные атрибуты через __setattr__

Сложность: среднее

Реализуйте FrozenAfterInit, который разрешает задавать атрибуты только во время __init__.

Требования:

  • После завершения init любое новое или изменённое значение атрибута возбуждает AttributeError
  • Используйте приватный флаг _locked (или аналог), выставляемый в конце __init__
  • __init__(self, **fields) копирует поля на экземпляр до блокировки

Пример:

obj = FrozenAfterInit(x=1, y=2)
assert obj.x == 1
# obj.x = 3  -> AttributeError
# obj.z = 0  -> AttributeError

Задание 4. Значения по умолчанию для отсутствующих атрибутов через __getattr__

Сложность: среднее

Реализуйте Defaults, который возвращает 0 для любого отсутствующего имени атрибута, начинающегося с count_, и "n/a" для имён, начинающихся с label_. Остальные отсутствующие имена возбуждают AttributeError.

Требования:

  • Существующие атрибуты ведут себя обычно
  • __getattr__ реализует правила по умолчанию выше

Пример:

d = Defaults()
d.count_a = 5
assert d.count_a == 5
assert d.count_b == 0
assert d.label_x == "n/a"

Задание 5. Monostate настройки «потока»

Сложность: среднее

Реализуйте ThreadLocalLike по паттерну monostate (общий __dict__ через словарь на уровне класса).

Требования:

  • Все экземпляры разделяют одни и те же значения атрибутов
  • Изменение атрибута на одном экземпляре видно на других
  • Атрибуты theme, lang со значениями по умолчанию "light" и "en"

Пример:

a, b = ThreadLocalLike(), ThreadLocalLike()
a.theme = "dark"
assert b.theme == "dark"

Задание 6. Мини-проект: BankAccount с API на property

Сложность: сложное

Реализуйте небольшой API счёта с акцентом на инкапсуляцию (пока без собственной иерархии исключений).

Требования:

  • Приватный __balance; публичный owner: str
  • Свойство balance (только чтение снаружи; без сеттера)
  • Методы deposit(amount) и withdraw(amount) — сумма должна быть > 0; снятие не должно уводить баланс ниже 0 (возбуждайте ValueError)
  • Свойство status → "empty", если balance == 0, "low", если < 100, иначе "ok"
  • Метод класса from_opening(cls, owner: str, opening: float) -> BankAccount с проверкой opening ≥ 0

Пример:

acc = BankAccount.from_opening("Sam", 50)
acc.deposit(20)
assert acc.balance == 70
assert acc.status == "low"

Глава 3

Дескрипторы и __call__

Урок 12 · Часть II. ООП на Python

Дескрипторы (data descriptor и non-data descriptor)

Источник: deskriptory-data-descriptor-i-non-data-descriptor

На этом занятии мы затронем довольно интересную, но не простую тему – дескрипторов классов. Я начну с одного явного недостатка объектов-свойств, о которых мы с вами уже подробно говорили. Давайте представим, что создаем класс для представления точек в трехмерном пространстве:

class Point3D:
    def __init__(self, x, y, z):
        self._x = x
        self._y = y
        self._z = z

Здесь у нас формируются защищенные локальные свойства для создаваемого объекта класса Point3D. Теперь представим, что согласно заданию координаты должны представляться исключительно целыми числами. Для этого я пропишу следующий метод проверки:

    @classmethod
    def verify_coord(cls, coord):
        if type(coord) != int:
            raise TypeError("Координата должна быть целым числом")

А вызывать его будут в сеттерах соответствующих свойств класса:

    @property
    def x(self):
        return self._x
 
    @x.setter
    def x(self, coord):
        self.verify_coord(coord)
        self._x = coord
 
    @property
    def y(self):
        return self._y
 
    @y.setter
    def y(self, coord):
        self.verify_coord(coord)
        self._y = coord
 
    @property
    def z(self):
        return self._z
 
    @z.setter
    def z(self, coord):
        self.verify_coord(coord)
        self._z = coord

Здесь все вам должно быть понятно. И теперь мы можем в инициализаторе использовать эти объекты-свойства для формирования локальных атрибутов экземпляров:

class Point3D:
    def __init__(self, x, y, z):
        self.x = x
        self.y = y
        self.z = z

Все, создавая объекты этого класса:

p = Point3D(1, 2, 3)
print(p.__dict__)

у нас автоматически будут формироваться нужные локальные атрибуты и мы сможем с ними работать через объекты-свойства x, y, z.

Но, смотрите, в нашем классе Point3D получилось своеобразное дублирование: мы три раза прописывали свойства, фактически, с одинаковым функционалом. Менялись только названия методов и локальных атрибутов. Представьте, во что превратится описание этого класса, если нужно будет задать 10 и более таких объектов-свойств! Программист во всем этом просто запутается, да и редактировать такую программу станет непросто. Как можно все это оптимизировать? Здесь нам на помощь как раз и приходят дескрипторы.

Вначале, что вообще такое дескрипторы? Это класс, который содержит или один магический метод get:

class A:
    def __get__(self, instance, owner): 
        return ...

Или класс, в котором дополнительно прописаны методы set и/или del:

class B:
    def __get__(self, instance, owner):
        return ...
 
    def __set__(self, instance, value):
        ...
 
    def __del__(self):
        ...

Первый (класс A) называется non-data descriptor (дескриптор не данных), а второй (класс B) – data descriptor (дескриптор данных). Это различие имеет смысл, но об этом позже.

Как вы уже догадались, эти магические методы, по сути, геттеры и сеттеры, а также делитер. Давайте, теперь посмотрим, как дескриптор может упростить наш программный код с обработкой координат точек.

Вначале я покажу все взаимодействие на схеме. Так как все координаты – целые числа, то интерфейс взаимодействия с ними мы определим через дескриптор с названием Integer (это имя мы, конечно же, придумываем сами):

class Integer:
    def __set_name__(self, owner, name):
        self.name = "_" + name
 
    def __get__(self, instance, owner):
        return instance.__dict__[self.name]
 
    def __set__(self, instance, value):
        print(f"__set__: {self.name} = {value}")
        instance.__dict__[self.name] = value

Пока не обращайте внимания на его содержимое, сейчас я все подробно объясню. Затем, в классе Point3D мы создадим три атрибута как объекты класса Integer:

class Point3D:
    x = Integer()
    y = Integer()
    z = Integer()
 
    def __init__(self, x, y, z):
        self.x = x
        self.y = y
        self.z = z

Эти атрибуты и есть дескрипторы данных, через которые будет проходить взаимодействие. Итак, когда мы создавали экземпляры классов Integer, то автоматически вызывался магический метод set_name, в котором параметр self являлся ссылкой на создаваемый экземпляр класса; owner – ссылка на класс Point3D; name – имя атрибута (для первого объекта x, затем, y и z). В этом методе мы формируем локальное свойство с именем атрибута, добавляя перед ним одно нижнее подчеркивание (так принято делать при определении дескрипторов). В итоге, в экземплярах классов будут храниться имена _x, _y, _z.

Зачем нам это нужно? Смотрите дальше. Предположим, мы создаем экземпляр класса Point3D:

pt = Point3D(1, 2, 3)

Сработает инициализатор, а в нем идет обращение к дескрипторам x, y, z. В частности, мы им присваиваем переданные значения. В этом случае, в классе Integer срабатывает сеттер (магический метод set), параметр self – это ссылка на объект дескриптора; instance – ссылка на объект pt, из которого произошло обращение к дескриптору; value – присваиваемое значение. В этом сеттере мы выводим в консоль сообщение, что был вызван данный метод и отображаем сохраненное имя и присваиваемое значение. Следующей строчкой через ссылку instance, то есть, на экземпляр класса pt, формируем в нем локальное свойство с именем self.name и присваиваем значение value. В результате, в объекте pt появляются локальные свойства _x, _y, _z с соответствующими значениями.

Если затем, выполнить считывание данных через дескриптор, например, x, то автоматически сработает геттер (метод get), в котором self – это ссылка на объект Integer; instance – ссылка на экземпляр класса pt; owner – ссылка на класс Point3D. Мы здесь через ссылку instance обращаемся к словарю dict и считываем значение нужного локального свойства, которое, затем, возвращается геттером. Это же значение автоматически возвращается и самим дескриптором.

Вот общая схема работы дескрипторов применительно к нашему классу Point3D. Теперь, сколько бы интерфейсов взаимодействия нам не понадобилось, мы легко их можем добавить в наш класс и все будет выглядеть понятно и компактно. На первый взгляд все это может показаться каким-то сложным и запутанным. Но, если внимательно во всем разобраться, то все предельно просто, только несколько громоздко. Именно громоздко, а не сложно. Поэтому, при необходимости, просто посмотрите несколько раз объяснение схемы и я уверен, каждый из вас поймет принцип ее работы. Ну а мы реализуем ее в нашей программе.

После создания экземпляра класса и вывода локальных свойств объекта:

pt = Point3D(1, 2, 3)
print(pt.__dict__)

увидим в консоли следующие строчки:

set: _x = 1
set: _y = 2
set: _z = 3
{‘_x’: 1, ‘_y’: 2, ‘_z’: 3}

Последнее, что нужно прописать в дескрипторе – это проверку корректности данных. Для этого у нас уже есть метод verify_coord, перенесем его в класс Integer и вызовем в сеттере:

class Integer:
    @classmethod
    def verify_coord(cls, coord):
        if type(coord) != int:
            raise TypeError("Координата должна быть целым числом")
 
    def __set_name__(self, owner, name):
        self.name = "_" + name
 
    def __get__(self, instance, owner):
        return instance.__dict__[self.name]
 
    def __set__(self, instance, value):
        self.verify_coord(value)
        instance.__dict__[self.name] = value

Теперь, если при формировании объекта указать неверный тип данных:

pt = Point3D('1', 2, 3)

то увидим сообщение об ошибке.

Еще в классе Integer я сделаю обращение к атрибутам экземпляра через стандартные функции getattr и setattr:

    def __get__(self, instance, owner):
        return getattr(instance, self.name)
 
    def __set__(self, instance, value):
        self.verify_coord(value)
        setattr(instance, self.name, value)

Так будет правильнее, с точки зрения Python, чем обращение напрямую к специальной коллекции dict.

В итоге, мы с вами определили дескриптор данных (data descriptor) и на его основе создали три объекта x, y, z для интерфейса взаимодействия с координатами точки объектов класса Point3D.

Теперь вернемся к тому, что вначале я вам говорил, что важно различать дескрипторы данных и не данных. В чем разница? Ну, во-первых, очевидно, дескрипторы не данных не могут менять значения какого-либо свойства, так как не имеют сеттера и делитера. Они служат только для считывания информации. И есть второе важное отличие. Они имеют тот же приоритет доступа, что и обычные атрибуты класса. О чем здесь речь? Давайте я покажу это различие на примере. Добавим в программу еще один дескриптор, только не данных:

class ReadIntX:
    def __set_name__(self, owner, name):
        self.name = "_x"
 
    def __get__(self, instance, owner):
        return getattr(instance, self.name)

Он у нас будет считывать локальное свойство _x. Определим его в классе Point3D:

    xr = ReadIntX()

И теперь можем использовать для считывания локального атрибута _x:

print(pt.xr)

Как видите, все работает. Но, что будет, если мы запишем конструкцию:

pt.xr = 5

Произойдет ошибка? Нет! В экземпляре pt будет создано новое локальное свойство с именем xr и мы в этом можем убедиться:

print(pt.xr, pt.__dict__)

Кроме того, при обращении к pt.xr мы получаем значение 5, а не 1. Это, как раз и говорит о том, что приоритет доступа к локальным свойствам объекта и к дескриптору не данных одинаков.

Однако, если в дескриптор добавить сеттер и превратить его в дескриптор данных:

class ReadIntX:
    def __set_name__(self, owner, name):
        self.name = "_x"
 
    def __get__(self, instance, owner):
        return getattr(instance, self.name)
 
    def __set__(self, instance, value):
        setattr(instance, self.name, value)

А создание локального атрибута xr в объекте pt мы сделаем через коллекцию dict:

pt.__dict__['xr'] = 5

то при выполнении:

print(pt.xr, pt.__dict__)

увидим значение 1, хотя в объекте существует свойство xr. Это произошло потому, что приоритет обращению к дескриптору данных выше, чем к локальным атрибутам экземпляра класса. То есть, здесь все работает ровно так, как и с доступом к объектам-свойствам, о которых мы говорили на прошлых занятиях.

На этом мы завершим с вами знакомство с этой непростой темой «дескрипторы». Постарался объяснить все, как можно проще. Если тема не до конца понятна, то возможно нужно посмотреть ее несколько раз, либо совсем пропустить, так как это относительно редко используется в практике. Но знать этот функционал нужно, чтобы при необходимости не изобретать велосипед, а использовать уже встроенные возможности языка Python.

Урок 13 · Часть II. ООП на Python

Магический метод <strong>call</strong>. Функторы и классы-декораторы

Источник: magicheskiy-metod-call-funktory-i-klassy-dekoratory

На этом занятии мы познакомимся с очередным магическим методом call. Магические методы еще называют:

dunder-методы (от англ. сокращения double underscore)

В дальнейшем я буду говорить магические методы. Итак, когда вызывается метод call и для чего он нужен? Как вы уже знаете, после объявления любого класса:

class Counter:
    def __init__(self):
        self.__counter = 0

Мы можем создавать его экземпляры командой:

c = Counter()

Обратите внимание на круглые скобки после имени класса. В общем случае – это оператор вызова, например, так можно вызывать функции. Но, как видите, так можно вызывать и классы. В действительности, когда происходит вызов класса, то автоматически запускается магический метод call и в данном случае он создает новый экземпляр этого класса:

Иллюстрация к уроку

Это очень упрощенная схема реализации метода call, в действительности, она несколько сложнее, но принцип тот же: сначала вызывается магический метод new для создания самого объекта в памяти устройства, а затем, метод init - для его инициализации. То есть, класс можно вызывать подобно функции благодаря встроенной для него реализации магического метода call. А вот экземпляры классов так вызывать уже нельзя. Если записать команду:

c()

то возникнет ошибка: «TypeError: ‘Counter’ object is not callable».

Как вы уже догадались, мы можем поправить этот момент, если явно в классе Counter пропишем магический метод call, например, так:

class Counter:
    def __init__(self):
        self.__counter = 0
 
    def __call__(self, *args, **kwargs):
        print("__call__")
        self.__counter += 1
        return self.__counter

Здесь мы выводим сообщение, что был вызван данный метод, затем увеличиваем счетчик counter для текущего объекта на 1 и возвращаем его.

Запустим программу снова и теперь никаких ошибок нет, а в консоли отобразилась строка «call», что означает вызов магического метода call. То есть, благодаря добавлению этого магического метода в наш класс, теперь можно вызывать его экземпляры подобно функциям через оператор круглые скобки. Классы, экземпляры которых можно вызывать подобно функциям, получили название функторы.

В нашем случае метод call возвращает значение счетчика, поэтому с объектом можно работать, следующим образом:

c = Counter()
c()
c()
res = c()
print(res)

Мы здесь три раза вызвали метод call и счетчик __counter трижды увеличился на единицу. Поэтому в консоли мы видим значение 3. Мало того, если создать еще один объект-счетчик:

c = Counter()
c2 = Counter()
c()
c()
res = c()
res2 = c2()
print(res, res2)

То они будут работать совершенно независимо и подсчитывать число собственных вызовов.

Давайте еще раз посмотрим на определение метода call. Здесь записаны параметры *args, **kwargs. Это значит, что при вызове объектов мы можем передавать им произвольное количество аргументов. Например, в нашем случае можно указать значение изменения счетчика при текущем вызове. Для этого я перепишу метод call, следующим образом:

    def __call__(self, step=1, *args, **kwargs):
        self.__counter += step
        return self.__counter

Здесь появился в явном виде первый параметр step с начальным значением 1. То есть, можно вызывать объекты, например, так:

c(2)
c(10)
res = c()
res2 = c2(-5)

Вот общий принцип работы магического метода call. Но здесь остается, как всегда, один важный вопрос: зачем это нужно, где может пригодиться? Давайте я приведу несколько примеров его использования.

Первый пример – это использование класса с методом call вместо замыканий функций. Смотрите, мы можем объявить класс StripChars, который бы удалял вначале и в конце строки заданные символы:

class StripChars:
    def __init__(self, chars):
        self.__chars = chars
 
    def __call__(self, *args, **kwargs):
        if not isinstance(args[0], str):
            raise ValueError("Аргумент должен быть строкой")
 
        return args[0].strip(self.__chars)

Для этого, в инициализаторе мы сохраняем строку __chars – удаляемые символы, а затем, при вызове метода call удаляем символы через строковый метод strip для символов __chars. То есть, теперь можно создать экземпляр класса и указать те символы, которые следует убирать:

s1 = StripChars("?:!.; ")

А, затем, вызвать объект s1 подобно функции:

res = s1(" Hello World! ")
print(res)

В результате объект s1 будет отвечать за удаление указанных символов в начале и конце строки. Но нам ничто не мешает определять другие объекты этого класса с другим набором символов:

s1 = StripChars("?:!.; ")
s2 = StripChars(" ")
res = s1(" Hello World! ")
res2 = s2(" Hello World! ")
print(res, res2, sep='\n')

То есть, объект s2 уже отвечает только за удаление пробелов, тогда как s1 и некоторых других символов. Достаточно элегантное решение задачи, где нам требуется сохранять символы для удаления.

Классы-декораторы

Второй пример – это реализация декораторов с помощью классов. Ранее мы с вами создавали декоратор для вычисления значения производной функции в определенной точке x. Я повторю эту реализацию, но с использованием класса. Вначале запишем следующий класс:

class Derivate:
    def __init__(self, func):
        self.__fn = func
 
    def __call__(self, x, dx=0.0001, *args, **kwargs):
        return (self.__fn(x + dx) - self.__fn(x)) / dx

Здесь в инициализаторе сохраняем ссылку на функцию, которую декорируем, а в методе call принимаем один обязательный параметр x – точку, где вычисляется производная и dx – шаг изменения при вычислении производной.

Далее, определим функцию, например, просто синус:

def df_sin(x):
    return math.sin(x)

и вызове ее пока без декорирования:

print(df_sin(math.pi/4))

После запуска программы увидим значение примерно 0.7071. Давайте теперь добавим декоратор. Это можно сделать двумя способами. Первый, прописать все в явном виде:

df_sin = Derivate(df_sin)

Теперь df_sin – это экземпляр класса Derivate, а не исходная функция. Поэтому, когда она будет вызываться, то запустится метод call и вычислится значение производной в точке math.pi/4.

Второй способ – это воспользоваться оператором @ перед объявлением функции:

@Derivate
def df_sin(x):
    return math.sin(x)

Получим абсолютно тот же самый результат. Вот принцип создания декораторов функций на основе классов. Как видите, все достаточно просто – запоминаем ссылку на функцию, а затем, расширяем ее функционал в магическом методе call.

Надеюсь, из этого занятия вы поняли, как работает метод call и где он может быть использован. Конечно, я привел всего два простых примера, чтобы продемонстрировать принцип его работы. В реальных задачах, проектах, вы должны сами, используя свои знания, решать, какие механизмы, приемы следует применять для решения текущих задач. Привести алгоритмы решений на все случаи жизни просто невозможно – это уже навык алгоритмизации, которым должен владеть каждый программист. И вырабатывается он, в основном, на решении практических задач. Так что больше практикуйтесь параллельно с изучением возможностей языка Python.

Практика 3 · Часть II. ООП на Python

Дескрипторы и `__call__`

Задания для закрепления темы · решений нет

Цели обучения

  • Различать data и non-data дескрипторы
  • Создавать переиспользуемые дескрипторы валидации
  • Реализовывать вызываемые объекты (функторы) и простые декораторы классов

Задания

Задание 1. Non-data дескриптор-логгер

Сложность: лёгкое

Реализуйте non-data дескриптор ReadLog: только __get__.

Требования:

  • При доступе добавляйте имя атрибута в список класса access_log у класса-владельца (или в общий список, который вы определите)
  • Возвращайте значение из __dict__ экземпляра (или None, если его нет)
  • Не реализуйте __set__

Пример:

class Demo:
    x = ReadLog()
    access_log: list[str] = []

d = Demo()
d.__dict__["x"] = 10
assert d.x == 10
assert "x" in Demo.access_log

Задание 2. Data-дескриптор IntegerField

Сложность: среднее

Реализуйте data-дескриптор IntegerField(min_value=None, max_value=None).

Требования:

  • __set_name__ сохраняет имя атрибута
  • Значения должны быть int; иначе TypeError
  • Опциональные min/max проверяйте с ValueError
  • Храните значения по экземплярам (например, под приватным ключом в __dict__ экземпляра)

Пример:

class Player:
    score = IntegerField(min_value=0)

p = Player()
p.score = 10
# p.score = -1  -> ValueError

Задание 3. StringField + составная модель

Сложность: среднее

Реализуйте StringField(minsize=1, maxsize=100) и модель User на дескрипторах.

Требования:

  • User.username = StringField(minsize=3, maxsize=20)
  • User.age = IntegerField(min_value=0, max_value=150) (переиспользуйте задание 2)
  • Некорректные значения возбуждают исключения по правилам дескрипторов

Задание 4. Функтор: скользящее среднее

Сложность: среднее

Реализуйте вызываемый класс RunningAverage.

Требования:

  • __call__(self, value: float) -> float обновляет внутренние сумму/счётчик и возвращает новое среднее
  • Свойство или атрибут count — число наблюдений
  • Метод reset(self) -> None

Пример:

avg = RunningAverage()
assert avg(10) == 10
assert avg(20) == 15
assert avg.count == 2

Задание 5. Декоратор класса: добавить created_at

Сложность: среднее

Напишите декоратор класса stamp_created, который для каждого экземпляра задаёт created_at меткой времени (используйте time.time() или datetime.now()).

Требования:

  • Оберните __init__ декорируемого класса
  • Сохраните исходное имя класса
  • Работает с классами, у которых уже есть __init__

Пример:

@stamp_created
class Job:
    def __init__(self, name: str):
        self.name = name

j = Job("build")
assert hasattr(j, "created_at")

Задание 6. Мини-проект: валидируемая форма + функтор Retry

Сложность: сложное

Объедините дескрипторы и __call__.

Требования:

  • Дескрипторы: IntegerField, StringField как выше
  • Класс SignupForm с username, email (StringField), age (IntegerField)
  • Метод validate(self) -> list[str], возвращающий человекочитаемые ошибки без возбуждения (или пустой список, если всё ок)
  • Функтор Retry(fn, tries=3): __call__(*args, **kwargs) повторяет fn при ValueError до tries раз; повторно возбуждает последнюю ошибку
  • Бонус: декорируйте хелпер, который строит SignupForm из dict и возбуждает ValueError на плохих данных, затем оберните его в Retry

Подсказки:

  • При желании держите валидацию формы отдельно от __set__ дескриптора, если в validate нужны «мягкие» проверки

Глава 4

Магические методы

Урок 14 · Часть II. ООП на Python

Магические методы <strong>str</strong>, <strong>repr</strong>, <strong>len</strong>, <strong>abs</strong>

Источник: magicheskie-metody-str-repr-len-abs

На этом занятии я расскажу о, так называемых, магических методах, которые определены в каждом классе и записываются через два подчеркивания вначале и в конце имен, например, так:

str, repr

Как я говорил, их еще называют

dunder-методами (от англ. сокращения double underscope)

Каждый магический метод автоматически срабатывает в определенный момент времени, например:

  • str() – магический метод для отображения информации об объекте класса для пользователей (например, для функций print, str);
  • repr() – магический метод для отображения информации об объекте класса в режиме отладки (для разработчиков).

Чтобы лучше понять, как работают эти методы, объявим класс для описания кошек:

class Cat:
    def __init__(self, name):
        self.name = name

Перейдем в консоль Python, скопируем (определим) этот класс. Затем, создадим его экземпляр:

cat = Cat('Васька')

При выводе cat, увидим служебную информацию:

Если нам нужно ее как-то переопределить и отобразить в другом виде (формате), то, как раз для этого используются магические методы str и repr. Давайте для начала переопределим метод repr и посмотрим, как это отразится на выводе служебной информации о классе:

    def __repr__(self):
        return f"{self.__class__}: {self.name}"

Обратите внимание, этот метод должен возвращать строку, поэтому здесь записан оператор return и формируемая строка. Что именно возвращать, мы решаем сами, в данном случае – это название класса и имя кошки.

Переопределим измененный класс Cat. И, смотрите, теперь при создании экземпляра мы видим другую информацию при его выводе:

<class ‘ex1.Cat’>: Васька

Как раз то, что определили в магическом методе repr. То же самое увидим и при использовании функции print и str. По идее, здесь должен отрабатывать другой магический метод str, но так как он у нас еще не переопределен, то автоматически выполняется метод repr.

Давайте добавим второй магический метод str и посмотрим, как это повлияет на отображение данных:

    def __str__(self):
        return f"{self.name}"

Снова переопределим класс Cat, создадим его экземпляр и при отображении ссылки:

cat

по-прежнему будем видеть служебную информацию от метода repr. Однако, если выполнить отображение экземпляра класса через print или str, то будет срабатывать уже второй метод str. Вот в этом отличие этих двух магических методов.

Магические методы len и abs

Следующие два магических метода:

  • len() – позволяет применять функцию len() к экземплярам класса;
  • abs() - позволяет применять функцию abs() к экземплярам класса.

Их использование достаточно простое и очевидное. Давайте для примера представим, что у нас есть класс Point, который может хранить произвольный вектор координат точек, и определим его так:

class Point:
    def __init__(self, *args):
        self.__coords = args

А, далее, по программе нам бы хотелось определять размерность координат с помощью функции len(), следующим образом:

p = Point(1, 2)
print(len(p))

Если сейчас запустить программу, то увидим ошибку, так как функция len не применима к экземплярам классов по умолчанию. Как вы уже догадались, чтобы изменить это поведение, можно переопределить магический метод len() и в нашем случае это можно сделать так:

    def __len__(self):
        return len(self.__coords)

Смотрите, мы здесь возвращаем размер списка __coords и если после этого запустить программу, то как раз это значение и будет выведено в консоль. То есть, магический метод len указал, что нужно возвращать, в момент применения функции len() к экземпляру класса. Как видите, все просто и очевидно.

Следующий магический метод abs работает аналогичным образом, только активируется в момент вызова функции abs для экземпляра класса, например, так:

print(abs(p))

Опять же, если сейчас выполнить программу, то увидим ошибку, т.к. функция abs не может быть напрямую применена к экземпляру. Но, если переопределить магический метод:

    def __abs__(self):
        return list( map(abs, self.__coords) )

который возвращает список из абсолютных значений координат точки, то программа отработает в штатном режиме и мы увидим ожидаемый результат.

Вот так можно использовать эти два магических метода. Я, надеюсь, из этого занятия вы узнали, зачем нужны и как можно реализовывать в своих классах четыре магических метода:

str, repr, len, abs

Урок 15 · Часть II. ООП на Python

Магические методы <strong>add</strong>, <strong>sub</strong>, <strong>mul</strong>, <strong>truediv</strong>

Источник: magicheskie-metody-add-sub-mul-truediv

Раз уж мы затронули тему магических методов, то доведем ее до конца и познакомимся с наиболее употребительными из них. На этом занятии мы будем рассматривать методы для работы с арифметическими операторами:

  • add() – для операции сложения;
  • sub() – для операции вычитания;
  • mul() – для операции умножения;
  • truediv() – для операции деления.

Как всегда, объяснить работу этих методов проще всего на конкретном примере. Предположим, что мы создаем класс для работы со временем. Его экземпляры будут хранить часы, минуты и секунды текущего дня. Начальной точкой отсчета будет 00:00 часов ночи. Время будем хранить в виде секунд с максимальным значением 86400 – число секунд в одном дне. Поэтому перед присвоением в инициализаторе будем брать остаток от деления на это значение:

class Clock:
    __DAY = 86400   # число секунд в одном дне
 
    def __init__(self, seconds: int):
        if not isinstance(seconds, int):
            raise TypeError("Секунды должны быть целым числом")
        self.seconds = seconds % self.__DAY

Обратите внимание как записан параметр seconds. После него стоит двоеточие и указан ожидаемый тип данных. Эта нотация языка Python подсказывает программисту, какой тип данных следует передавать в качестве seconds. Конечно, мы можем передавать и другие типы данных, строгого ограничения здесь нет, это лишь пометка для программиста и не более того. Поэтому далее внутри инициализатора мы делаем проверку, что параметр seconds должен являться целым числом. Если это не так, генерируем исключение TypeError.

Далее в этом же классе пропишем метод get_time для получения текущего времени в виде форматной строки:

    def get_time(self):
        s = self.seconds % 60            # секунды
        m = (self.seconds // 60) % 60    # минуты
        h = (self.seconds // 3600) % 24  # часы
        return f"{self.__get_formatted(h)}:{self.__get_formatted(m)}:{self.__get_formatted(s)}"
 
    @classmethod
    def __get_formatted(cls, x):
        return str(x).rjust(2, "0")

Здесь дополнительно определен метод класса для форматирования времени (добавляется незначащий первый ноль, если число меньше 10).

Далее, мы можем воспользоваться этим классом, например, так:

c1 = Clock(1000)
print(c1.get_time())

Если же нам понадобиться изменить время в объекте c1, то сейчас это можно сделать через локальное свойство seconds:

c1.seconds = c1.seconds + 100

Мы добавили 100 секунд. Но было бы здорово если бы это изменение можно было бы прописать вот так:

c1 = c1 + 100

Конечно, при запуске программы возникнет ошибка, так как оператор сложения не работает с экземплярами класса Clock. Однако, это можно поправить, если добавить в наш класс магический метод add. Я запишу его в следующем виде:

    def __add__(self, other):
        if not isinstance(other, int):
            raise ArithmeticError("Правый операнд должен быть типом int")
 
        return Clock(self.seconds + other)

И теперь, при запуске программы, все работает так, как и задумывалось. Давайте разберем этот момент подробнее.

Вначале у нас есть объект класса Clock со значением секунд 1000. Затем, арифметическая операция c1 = c1 + 100 фактически означает выполнение команды:

с1 = c1.__add__(100)

В результате, активируется метод add и параметр other принимает целочисленное значение 100. Проверка проходит и формируется новый объект класса Clock со значением секунд 1000+100 = 1100. Этот объект возвращается методом add и переменная c1 начинает ссылаться на этот новый экземпляр класса. На прежний уже не будет никаких внешних ссылок, поэтому он будет автоматически удален сборщиком мусора.

Вас может удивить сложность процессов, когда нам всего лишь нужно прибавить 100 секунд к уже имеющемуся значению. Но эта сложность оправданна. Чтобы это понять, мы расширим функционал оператора сложения и допустим, что можно складывать два разных объекта класса Clock, следующим образом:

c1 = Clock(1000)
c2 = Clock(2000)
c3 = c1 + c2
print(c3.get_time())

Конечно, если сейчас запустить программу, то увидим ошибку ArithmeticError, так как параметр other не соответствует целому числу. Поправим это и немного изменим реализацию метода add:

    def __add__(self, other):
        if not isinstance(other, (int, Clock)):
            raise ArithmeticError("Правый операнд должен быть типом int или объектом Clock")
 
        sc = other if isinstance(other, int) else other.seconds
        return Clock(self.seconds + sc)

Теперь, в программе можно складывать и отдельные целые числа и объекты классов Clock. Видите, как это удобно! Кроме того, мы можем прописывать и более сложные конструкции при сложении, например, такие:

c1 = Clock(1000)
c2 = Clock(2000)
c3 = Clock(3000)
c4 = c1 + c2 + c3
print(c4.get_time())

И она сработала благодаря тому, что метод add возвращает каждый раз новый экземпляр класса Clock. Детальнее все выглядит так.

Сначала идет сложение объектов c1 + c2, в результате формируется новый объект класса Clock со значением секунд 1000 + 2000 = 3000. Пусть на этот класс ведет внутренняя переменная t1. Затем, для этого нового объекта вызывается снова метод add и идет сложение с объектом t1 + c3. Получаем еще один объект с числом секунд 6000. На этот объект, как раз и будет ссылаться переменная c4, а объект с t1 будет автоматически уничтожен сборщиком мусора.

Если бы мы не создавали экземпляры классов Clock в методе add и не возвращали их, то конструкцию с двумя сложениями было бы невозможно реализовать.

Еще одним важным нюансом работы оператора сложения для объектов классов, является порядок их записи. Мы всегда прописывали его в виде:

c1 = c1 + 100

то есть, сначала шел объект, а затем, число. Если записать наоборот, то возникнет ошибка:

c1 = 100 + c1

и это очевидно, так как здесь, фактически идет вызов метода:

100.add(c1)

но он не существует для объекта int и экземпляров класса Clock. Как выйти из этой ситуации? Очень просто. Язык Python предоставляет нам специальный набор магических методов с добавлением буквы r:

radd()

Он автоматически вызывается, если не может быть вызван метод add(). Давайте добавим его определение в наш класс Clock:

    def __radd__(self, other):
        return self + other

Смотрите, мы здесь записали команду сложения текущего объекта класса Clock с параметром other, который может быть или числом или тоже объектом класса Clock. В свою очередь будет вызван метод add, но с правильным порядком типов данных, поэтому сложение пройдет без ошибок.

Наконец, у всех магических методов, связанных с арифметическими операторами, есть еще одна модификация с первой буквой i:

iadd()

Она вызывается для команды:

c1 += 100

Если запустить сейчас программу, то никаких ошибок не будет и отработает метод add(). Но в методе add создается новый объект класса Clock, тогда как при операции += этого делать не обязательно. Поэтому я добавлю еще один магический метод iadd в наш класс Clock:

    def __iadd__(self, other):
        print("__iadd__")
        if not isinstance(other, (int, Clock)):
            raise ArithmeticError("Правый операнд должен быть типом int или объектом Clock")
 
        sc = other if isinstance(other, int) else other.seconds
        self.seconds += sc
 
        return self

Смотрите, мы здесь не создаем нового объекта, а меняем число секунд в текущем. Это логичнее, так как вызывать цепочкой операцию += не предполагается и, кроме того, она изменяет (по смыслу) состояние текущего объекта. Поэтому я посчитал правильным добавить этот магический метод.

Вот мы с вами подробно рассмотрели работу одного арифметического магического метода add() с его вариациями radd() и iadd(). По аналогии используются и все остальные подобные магические методы:

Оператор Метод оператора Оператор Метод оператора
x + y add(self, other) x += y iadd(self, other)
x - y sub(self, other) x -= y isub(self, other)
x * y mul(self, other) x *= y imul(self, other)
x / y truediv(self, other) x /= y itruediv(self, other)
x // y floordiv(self, other) x //= y ifloordiv(self, other)
x % y mod(self, other) x %= y imod(self, other)

Предлагаю вам в качестве самостоятельного задания добавить некоторые из них в класс Clock по аналогии с методами add(). При этом обращайте внимание на недопустимость дублирования кода. Оно произойдет, если вы «в лоб» будете прописывать другие арифметические магические методы. Подумайте, как все сделать правильно.

На этом мы завершим это занятие по магическим методам. На следующем продолжим эту тему и поговорим о реализации операторов сравнения.

Урок 16 · Часть II. ООП на Python

Методы сравнений <strong>eq</strong>, <strong>ne</strong>, <strong>lt</strong>, <strong>gt</strong> и другие

Источник: metody-sravneniy-eq-ne-lt-gt

На этом занятии мы будем рассматривать магические методы для реализации операторов сравнения:

  • eq() – для равенства ==
  • ne() – для неравенства !=
  • lt() – для оператора меньше <
  • le() – для оператора меньше или равно <=
  • gt() – для оператора больше >
  • ge() – для оператора больше или равно >=

Рассматривать работу этих методов мы будем на примере нашего класса Clock, который использовали на предыдущем занятии:

class Clock:
    __DAY = 86400   # число секунд в одном дне
 
    def __init__(self, seconds: int):
        if not isinstance(seconds, int):
            raise TypeError("Секунды должны быть целым числом")
        self.seconds = seconds % self.__DAY
 
    def get_time(self):
        s = self.seconds % 60            # секунды
        m = (self.seconds // 60) % 60    # минуты
        h = (self.seconds // 3600) % 24  # часы
        return f"{self.__get_formatted(h)}:{self.__get_formatted(m)}:{self.__get_formatted(s)}"
 
    @classmethod
    def __get_formatted(cls, x):
        return str(x).rjust(2, "0")

Изначально для класса реализован только один метод сравнения на равенство, например:

c1 = Clock(1000)
c2 = Clock(1000)
print(c1 == c2)

Но здесь объекты сравниваются по их id (адресу в памяти), а мы бы хотели, чтобы сравнивались секунды в каждом из объектов c1 и c2. Для этого переопределим магический метод eq(), следующим образом:

    def __eq__(self, other):
        if not isinstance(other, (int, Clock)):
            raise TypeError("Операнд справа должен иметь тип int или Clock")
 
        sc = other if isinstance(other, int) else other.seconds
        return self.seconds == sc

Теперь, после запуска программы видим значение True, т.к. объекты содержат одинаковое время. Кроме того, мы можем совершенно спокойно выполнять проверку и на неравенство:

print(c1 != c2)

Смотрите, если интерпретатор языка Python не находит определение метода ==, то он пытается выполнить противоположное сравнение с последующей инверсией результата. То есть, в данном случае находится оператор == и выполняется инверсия:

not (a == b)

Давайте в этом убедимся, поставим точку останова в метод eq и запустим программу. Как видите, он срабатывает и результат в последствии меняется на противоположный.

Отлично, на равенство и неравенство мы теперь можем сравнивать объекты класса Clock, а также с целыми числами. Однако, сравнение на больше или меньше пока не работает. Строчка программы:

print(c1 < c2)

приведет к ошибке. Добавим эту операцию сравнения:

    def __lt__(self, other):
        if not isinstance(other, (int, Clock)):
            raise TypeError("Операнд справа должен иметь тип int или Clock")
 
        sc = other if isinstance(other, int) else other.seconds
        return self.seconds < sc

Как видите, у нас здесь получается дублирование кода. Поэтому, я вынесу общее для методов сравнения в отдельный метода класса:

    @classmethod
    def __verify_data(cls, other):
        if not isinstance(other, (int, Clock)):
            raise TypeError("Операнд справа должен иметь тип int или Clock")
 
        return other if isinstance(other, int) else other.seconds

А сами методы примут вид:

    def __eq__(self, other):
        sc = self.__verify_data(other)
        return self.seconds == sc
 
    def __lt__(self, other):
        sc = self.__verify_data(other)
        return self.seconds < sc

Итак, мы определили сравнение на равенство и меньше. Теперь, можно сравнивать объекты класса Clock на эти операции и дополнительно на неравенство и больше. Сейчас команда:

c1 = Clock(1000)
c2 = Clock(2000)
print(c1 < c2)

Выдаст True, так как первое время меньше второго. И также мы можем совершенно спокойно делать проверку на больше:

print(c1 > c2)

Здесь сработает тот же метод меньше, но для объекта c2:

c2 < c1

То есть, в отличие от оператора ==, где применяется инверсия, здесь меняется порядок операндов. Разумеется, если в классе определен метод больше:

    def __gt__(self, other):
        sc = self.__verify_data(other)
        return self.seconds > sc

то он будет найден и выполнен. Подмена происходит только в случае отсутствия соответствующего магического метода.

И то же самое для методов сравнения на меньше или равно и больше или равно:

    def __le__(self, other):
        sc = self.__verify_data(other)
        return self.seconds <= sc

Если мы его вызовем непосредственно для объектов класса:

print(c1 <= c2)

то он сработает и результат отобразится в консоли. Но, если пропишем обратное сравнение:

print(c1 >= c2)

то просто изменится порядок операндов и будет взято все то же сравнение меньше или равно.

То есть, для определения операций сравнения достаточно в классе определить только три метода: ==, <, <=, если остальные являются их симметричной противоположностью. В этом случае язык Python сам подберет нужный метод и выполнит его при сравнении объектов.

Я, думаю, теперь вы хорошо себе представляете, как можно реализовывать операции сравнения для объектов класса.

Урок 17 · Часть II. ООП на Python

Магические методы <strong>eq</strong> и <strong>hash</strong>

Источник: magicheskie-metody-eq-hash

На этом занятии мы затронем тему вычисления хеша для объектов классов. Вначале что это такое и зачем нужно? В Python имеется специальная функция:

hash(123)
hash("Python")
hash((1, 2, 3))

которая формирует по определенному алгоритму целочисленные значения для неизменяемых объектов. Причем, для равных объектов на выходе всегда должны получаться равные хэши:

hash("Python")
hash((1, 2, 3))

А вот обратное утверждение делать нельзя: равные хэши не гарантируют равенство объектов. Это, как в известном выражении: селедка – это рыба, но не каждая рыба селедка. С хэшами все то же самое.

Иллюстрация к уроку

Однако, если хеши не равны, то и объекты точно не равны. Получаем следующие свойства для хеша:

  1. Если объекты a == b (равны), то равен и их хэш.
  2. Если равны хеши: hash(a) == hash(b), то объекты могут быть равны, но могут быть и не равны.
  3. Если хеши не равны: hash(a) != hash(b), то объекты точно не равны.

Причем, обратите внимание, хэши можно вычислять только для неизменяемых объектов. Например, для списков:

hash([1, 2, 3])

получим ошибку «unhashable type» - не хэшируемый объект.

Итак, мы увидели, что для любого неизменяемого объекта можно вычислять хэш с помощью функции hash(), но зачем все это надо? В действительности некоторые объекты в Python, например, словари используют хэши в качестве своих ключей. Вспомним, когда мы у словаря указываем ключ, то он должен относиться к неизменяемому типу данных:

d = {}
d[5] = 5
d["python"] = "python"
d[(1, 2, 3)] = [1, 2, 3]

В действительности, это необходимо, чтобы можно было вычислить хеш объектов и ключи хранить в виде:

(хэш ключа, ключ)

Для чего это понадобилось? Дело в том, что первоначально нужная запись в словаре ищется по хэшу, так как существует быстрый алгоритм поиска нужного значения хэша. А, затем, для равных хешей (если такие были обнаружены), отбирается запись с указанным в ключе объекте. Такой подход значительно ускоряет поиск значения в словаре.

Думаю, теперь вы представляете себе, что такое хэш и зачем он нужен. Давайте теперь рассмотрим простой класс Point для представления координат на плоскости:

class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

Для экземпляров этого класса:

p1 = Point(1, 2)
p2 = Point(1, 2)

мы совершенно спокойно можем вычислять хеш:

print(hash(p1), hash(p2), sep='\n')

Обратите внимание, несмотря на то, что координаты точек p1 и p2 равны, их хэши разные. То есть, с точки зрения функции hash() – это два разных объекта. Но как она понимает, равные объекты или разные? Все просто. Если оператор сравнения:

print(p1 == p2)

дает True, то объекты равны, иначе – не равны. Соответственно, для разных объектов будут получаться и разные хэши. Но раз это так, что будет, если мы переопределим поведение этого оператора сравнения с помощью магического метода eq()? Давайте попробуем:

    def __eq__(self, other):
        return self.x == other.x and self.y == other.y

Теперь у нас объекты с одинаковыми координатами будут считаться равными. Но при запуске программы возникает ошибка «unhashable type», то есть, наши объекты стали не хэшируемыми. Да, как только происходит переопределение оператора ==, то начальный алгоритм вычисления хэша для таких объектов перестает работать. Поэтому, нам здесь нужно прописать свой способ вычисления хэша объектов через магический метод hash(), например, так:

    def __hash__(self):
        return hash((self.x, self.y))

Мы здесь вызываем функцию hash для кортежа из координат точки. Этот кортеж относится к неизменяемому типу, поэтому для него можно применить стандартную функцию hash(). То есть, мы подменили вычисление хэша объекта класса Point на вычисление хэша от координат точки. Теперь, после запуска программы видим, что объекты равны и их хэши также равны.

Что это в итоге означает? Смотрите, если взять пустой словарь:

d = {}

А, затем, сформировать записи через объекты p1 и p2:

d[p1] = 1
d[p2] = 2
print(d)

то они будут восприниматься как один и тот же ключ, так как объекты равны и их хэши тоже равны. А вот если магические методы в классе Point поставить в комментарии и снова запустить программу, то увидим, что это уже разные объекты, которые формируют разные ключи словаря. Вот для чего может понадобиться тонко настраивать работу функции hash() для объектов классов. И теперь вы знаете, как это делается.

Урок 18 · Часть II. ООП на Python

Магический метод <strong>bool</strong> определения правдивости объектов

Источник: magicheskiy-metod-bool-opredeleniya-pravdivosti-obektov

На этом занятии мы поговорим о способах настройки и определения правдивости объектов классов. Что такое правдивость? Это когда к экземпляру явно или неявно применяется функция bool(). С ней мы с вами уже знакомы и применяли к обычным типам данных:

bool(123)
bool(-1)
bool(0)
bool("python")
bool("")
bool([])

В стандартном поведении она возвращает True для непустых объектов и False – для пустых. Давайте посмотрим, что она будет выдавать для экземпляров классов. Я возьму класс из предыдущего занятия:

class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

Создадим его объект:

p = Point(3, 4)

и применим к нему функцию bool():

print(bool(p))

Увидим значение True. В действительности, эта функция всегда возвращает True для любых объектов пользовательского класса. Получается, что смысла в ней особого нет, применительно к экземплярам наших классов? Не совсем. Мы можем переопределить ее поведение либо через магический метод len(), либо через метод bool():

  • len() – вызывается функцией bool(), если не определен магический метод bool();
  • bool() – вызывается в приоритетном порядке функцией bool().

Вначале я пропишу магический метод len() в классе Point, следующим образом:

class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y
 
    def __len__(self):
        print("__len__")
        return self.x * self.x + self.y * self.y

В этом методе я вычисляю и возвращаю квадрат длины радиус-вектора с координатами (x; y). Запустим программу и видим значение True, а также сообщение «len». То есть, действительно был вызван метод len() и, так как он вернул не нулевое значение, то функция bool() интерпретировала его как True.

Давайте в экземпляре класса пропишем нулевые координаты, чтобы длина вектора была нулевой:

p = Point(0, 0)

Теперь видим ожидаемое значение False.

Конечно, если нам нужно явно описать алгоритм работы функции bool() применительно к нашим экземплярам класса, то следует использовать магический метод bool(). Я запишу его в таком виде:

    def __bool__(self):
        print("__bool__")
        return self.x == self.y

Теперь, объект будет считаться правдивым (истинным), если его координаты равны. Запускаем программу и видим, что для нулей отображается значение True. Если же прописать не равные координаты:

p = Point(10, 20)

то получаем значение False. Конечно, такая реализация магического метода bool() – это лишь учебный пример, чтобы вы поняли принцип его работы. В реальности, мы можем в этом методе прописывать любую логику. Единственное условие, чтобы данный метод возвращал булево значение True или False. Указывать в операторе return другие типы данных запрещено.

Все это хорошо, но где это используется? Чаще всего в условных конструкциях. Например, если прописать вот такое условие:

if p:
    print("объект p дает True")
else:
    print("объект p дает False")

Здесь происходит неявный вызов функции bool() при проверке условия. Поэтому в программах, где требуется описать собственные проверки истинности или ложности объектов, то пользуются или магическим методом len(), но чаще всего, магическим методом bool().

Урок 19 · Часть II. ООП на Python

Магические методы <strong>getitem</strong>, <strong>setitem</strong> и <strong>delitem</strong>

Источник: magicheskie-metody-getitem-setitem-delitem

Я Сергей Балакирев и мы продолжаем знакомиться с магическими методами классов. Здесь речь пойдет о следующем их наборе:

  • getitem(self, item) – получение значения по ключу item;
  • setitem(self, key, value) – запись значения value по ключу key;
  • delitem(self, key) – удаление элемента по ключу key.

Давайте разберемся для чего они нужны и как их можно использовать. Предположим, что мы создаем класс для представления студентов:

class Student:
    def __init__(self, name, marks):
        self.name = name
        self.marks = list(marks)

Его экземпляр можно сформировать, следующим образом:

s1 = Student('Сергей', [5, 5, 3, 2, 5])

В объекте s1 имеется локальное свойство marks со списком студентов. Мы можем к нему обратиться и выбрать любую оценку:

print(s1.marks[2])

Но что если мы хотим делать то же самое, но используя только ссылку на объект s1:

print(s1[2])

Если сейчас запустить программу, то увидим сообщение об ошибке, что наш класс (объект) не поддерживает такой синтаксис. Как вы, наверное, уже догадались, поправить это можно с помощью магического метода getitem. Запишем его в нашем классе, следующим образом:

    def __getitem__(self, item):
        return self.marks[item]

Теперь ошибок нет и на экране видим значение 3. Однако, если указать неверный индекс:

print(s1[20])

то получим исключение IndexError, которое сгенерировал список marks. При необходимости, мы можем сами контролировать эту ошибку, если в методе getitem пропишем проверку:

    def __getitem__(self, item):
        if 0 <= item < len(self.marks):
            return self.marks[item]
        else:
            raise IndexError("Неверный индекс")

При запуске программы видим наше сообщение «Неверный индекс». Также можно сделать проверку на тип индекса:

print(s1['abc'])

для списков он должен быть целым числом. Поэтому дополнительно можно записать такую проверку:

    def __getitem__(self, item):
        if not isinstance(item, int):
            raise TypeError("Индекс должен быть целым числом")
 
       if 0 <= item < len(self.marks):
            return self.marks[item]
        else:
            raise IndexError("Неверный индекс")

То есть, здесь возможны самые разные вариации обработки и проверки исходных данных, прежде чем обратиться к списку marks и вернуть значение.

Теперь давайте предположим, что хотели бы иметь возможность менять оценки студентов, используя синтаксис:

s1[2] = 4
print(s1[2])

Сейчас, после запуска программы будет ошибка TypeError, что объект не поддерживает операцию присвоения, так как в классе не реализован метод setitem. Давайте добавим и его:

    def __setitem__(self, key, value):
        if not isinstance(key, int) or key < 0:
            raise TypeError("Индекс должен быть целым неотрицательным числом")
 
        self.marks[key] = value

Однако, если мы сейчас укажем несуществующий индекс:

s1[6] = 4

то операция присвоения новой оценки приведет к ошибке. Если предполагается использовать такую возможность, то реализовать ее можно, следующим образом:

    def __setitem__(self, key, value):
        if not isinstance(key, int) or key < 0:
            raise TypeError("Индекс должен быть целым неотрицательным числом")
 
        if key >= len(self.marks):
            off = key + 1 - len(self.marks)
            self.marks.extend([None]*off)
 
        self.marks[key] = value

Если индекс превышает размер списка, то мы расширяем список значениями None до нужной длины (с помощью метода extend), а затем, в последний элемент записываем переданное значение value. Теперь, при выполнении команд:

s1[10] = 4
print(s1.marks)

Увидим список:

[5, 5, 3, 2, 5, None, None, None, None, None, 4]

То есть, он был расширен до 10 элементов и последним элементом записано 4. И так можно прописывать любую нужную нам логику при записи новых значений в список marks.

Наконец, последний третий магический метод delitem вызывается при удалении элемента из списка. Если сейчас записать команду:

del s1[2]

то в консоли увидим сообщение: «AttributeError: delitem». Здесь явно указывается, что при удалении вызывается метод delitem. Добавим его в наш класс:

    def __delitem__(self, key):
        if not isinstance(key, int):
            raise TypeError("Индекс должен быть целым числом")
 
        del self.marks[key]

Теперь оценки успешно удаляются, если указан верный индекс.

Вот общие возможности данных магических методов. Теперь, если в программе вам потребуется реализовать подобную логику поведения экземпляров классов, я думаю, вы легко со всем справитесь.

Урок 20 · Часть II. ООП на Python

Магические методы <strong>iter</strong> и <strong>next</strong>

Источник: magicheskie-metody-iter-next

Я Сергей Балакирев и на этом занятии мы будем говорить о методах:

  • iter(self) – получение итератора для перебора объекта;
  • next(self) – переход к следующему значению и его считывание.

Давайте разберемся для чего они нужны и как их можно использовать. Вы все знаете, как работает функция range(). Она выдает значения арифметической прогрессии, например:

list(range(5))

дает последовательность целых чисел от 0 до 4. Перебрать значения объекта range также можно через итератор:

a = iter(range(5))
next(a)
next(a)
…

В конце генерируется исключение StopIteration. Так вот, мы можем создать подобный объект, используя магические методы iter и next. Давайте это сделаем для объекта frange, который будет выдавать последовательность вещественных чисел арифметической прогрессии. Для этого я объявлю класс:

class FRange:
    def __init__(self, start=0.0, stop=0.0, step=1.0):
        self.start = start
        self.stop = stop
        self.step = step
        self.value = self.start - self.step

Здесь в инициализатор мы передаем начальное значение прогрессии, конечное и шаг изменения. Также формируем свойство value, которое будет представлять собой текущее значение для считывания.

Для перебора элементов добавим в этот класс метод, который будет соответствовать магическому методу next:

    def __next__(self):
        if self.value + self.step < self.stop:
            self.value += self.step
            return self.value
        else:
            raise StopIteration

В этом методе мы увеличиваем значение value на шаг step и возвращаем до тех пор, пока не достигли значения stop (не включая его). При достижении конца генерируем исключение StopIteration, ровно так, как это делает объект range.

Сформируем объект этого класса:

fr = FRange(0, 2, 0.5)

и четыре раза вызовем метод next()

print(fr.__next__())

Видим четыре значения нашей арифметической прогрессии. Если вызвать next() еще раз:

print(fr.__next__())

получим исключение StopIteration. В целом получился неплохой учебный пример. В действительности, благодаря определению магического метода next в классе FRange, мы можем применять функцию next() для перебора значений его объектов:

fr = FRange(0, 2, 0.5)
print(next(fr))
print(next(fr))
print(next(fr))
print(next(fr))

Здесь функция next() вызывает метод next и возвращенное им значение, возвращается функцией next(). При этом, в качестве аргумента мы ей передаем экземпляр самого класса. То есть, объект класса выступает в роли итератора. В нашем случае так и задумывалось. Однако, перебрать объект fr с помощью цикла for не получится:

for x in fr:
    print(x)

Появится ошибка, что объект не итерируемый. Почему? Ведь мы прописали поведение функции next()? Этого не достаточно. Необходимо еще, чтобы объект возвращал итератор при вызове функции iter:

it = iter(fr)

Для этого в классе нужно прописать еще один магический метод iter. В нашем примере он будет выглядеть, так:

    def __iter__(self):
        self.value = self.start - self.step
        return self

Мы здесь устанавливаем начальное значение value и возвращаем ссылку на объекта класса, так как этот объект в нашем примере и есть итератор – через него вызывается магический метод next.

Теперь, после запуска программы у нас не возникает никаких ошибок и цикл for перебирает значения объекта fr. То же самое мы можем сделать и через next():

fr = FRange(0, 2, 0.5)
it = iter(fr)
print(next(it))
print(next(it))
print(next(it))
print(next(it))

Как вы помните, цикл for именно так и перебирает итерируемые объекты, сначала неявно вызывает функцию iter(), а затем, на каждой итерации – функцию next(), пока не возникнет исключение StopIteration. Кроме того, благодаря магическому методу iter мы теперь можем обходить значения объекта fr много раз с самого начала, например:

it = iter(fr)
print(next(it))
print(next(it))
print(next(it))
print(next(it))
 
it = iter(fr)
print(next(it))
print(next(it))
print(next(it))
print(next(it))

Таким образом, сформировали класс FRange, который воспринимается как итерируемый объект с возможностью перебора функцией next() или циклом for.

В заключение этого занятия я приведу пример еще одного класса FRange2D для формирования таблиц значений:

class FRange2D:
    def __init__(self, start=0.0, stop=0.0, step=1.0, rows=5):
        self.fr = FRange(start, stop, step)
        self.rows = rows

Здесь в инициализаторе создается одномерный объект FRange, который будет формировать строки таблицы. Параметр rows – число строк. Далее, пропишем два магических метода iter и next, следующим образом:

    def __iter__(self):
        self.value_row = 0
        return self
 
    def __next__(self):
        if self.value_row < self.rows:
            self.value_row += 1
            return iter(self.fr)
        else:
            raise StopIteration

Обратите внимание, что метод next возвращает не конкретное значение, а итератор на объект класса FRange. Сейчас вы поймете почему так. Создадим объект класса FRange2D:

fr = FRange2D(0, 2, 0.5, 4)

и для перебора его значений нам понадобятся два цикла for:

for row in fr:
    for x in row:
        print(x, end=" ")
    print()

Первый цикл перебирает первый итератор – объект класса FRange2D и на каждой итерации возвращает итератор объекта класса FRange. Именно поэтому мы в методе next класса FRange2D возвращаем иетратор, иначе бы не смогли перебирать объект row во вложенном цикле for.

После запуска программы увидим на экране следующую таблицу чисел:

0.0 0.5 1.0 1.5
0.0 0.5 1.0 1.5
0.0 0.5 1.0 1.5
0.0 0.5 1.0 1.5

Вот общий принцип создания итерируемых объектов. Надеюсь, эти примеры вам были понятны и вы теперь знаете, как и для чего используются магические методы iter и next.

Практика 4 · Часть II. ООП на Python

Магические методы

Задания для закрепления темы · решений нет

Цели обучения

  • Давать читаемые строковые представления и протоколы контейнеров
  • Корректно перегружать арифметические и операторы сравнения
  • Делать объекты хешируемыми или явно нехешируемыми
  • Реализовывать индексацию и пользовательские итераторы

Задания

Задание 1. Отображение Money

Сложность: лёгкое

Реализуйте Money(amount: float, currency: str = "USD").

Требования:

  • __str__ → "12.50 USD" (2 знака после запятой)
  • __repr__ → в стиле Money(12.5, 'USD') (по возможности удобный для eval)
  • __bool__ равен False, когда amount == 0

Пример:

m = Money(12.5)
assert str(m) == "12.50 USD"
assert bool(Money(0)) is False

Задание 2. Длина и abs в стиле range

Сложность: лёгкое

Реализуйте Span(start: int, end: int) включительно start, исключительно end (как range).

Требования:

  • __len__ возвращает число целых в промежутке
  • __abs__ возвращает новый Span с start <= end (нормализуйте, если границы перевёрнуты)

Задание 3. Vector2: арифметика и сравнения

Сложность: среднее

Реализуйте Vector2(x: float, y: float).

Требования:

  • +, - между векторами; * со скаляром (с обеих сторон: __mul__, __rmul__)
  • / на скаляр (__truediv__); деление на ноль → ZeroDivisionError
  • __abs__ → евклидова длина (float)
  • Равенство по компонентам (__eq__); поддержка упорядочивания по длине (__lt__ и т.д.) или задокументируйте реализованные богатые сравнения
  • __hash__ согласован с __eq__ (неизменяемый: без сеттеров)

Пример:

assert Vector2(1, 2) + Vector2(3, 4) == Vector2(4, 6)
assert abs(Vector2(3, 4)) == 5

Задание 4. Хешируемый Tag

Сложность: среднее

Реализуйте неизменяемый Tag(name: str, *labels: str).

Требования:

  • Нормализуйте name в нижний регистр; метки храните как frozenset
  • __eq__ / __hash__, чтобы теги работали как ключи set/dict
  • __repr__ показывает имя и отсортированные метки

Задание 5. Разреженный список с доступом по индексу

Сложность: среднее

Реализуйте SparseList на основе dict[int, object].

Требования:

  • __getitem__, __setitem__, __delitem__ для неотрицательных индексов
  • Чтение отсутствующего индекса возвращает None (или возбуждает IndexError — выберите одно и придерживайтесь)
  • __len__ → 0, если пусто, иначе max(index) + 1
  • Отрицательные индексы возбуждают IndexError

Пример:

s = SparseList()
s[2] = "a"
assert len(s) == 3
assert s[0] is None and s[2] == "a"

Задание 6. Итератор Countdown

Сложность: среднее

Реализуйте Countdown(n: int) по протоколу итератора.

Требования:

  • __iter__ возвращает self (или свежий итератор — зафиксируйте выбор)
  • __next__ выдаёт n, n-1, ..., 1, затем возбуждает StopIteration
  • При n < 1 ничего не выдаёт

Пример:

assert list(Countdown(3)) == [3, 2, 1]

Задание 7. Мини-проект: набор для Matrix 2×N

Сложность: сложное

Реализуйте Matrix со списком строк (list[list[float]]).

Требования:

  • Проверяйте прямоугольную форму в __init__
  • __str__ — аккуратный многострочный вывод; __repr__ — компактный
  • __getitem__ поддерживает m[i] → строка и m[i, j] → элемент (ключ-кортеж)
  • __setitem__ для присваивания элемента
  • + для матриц одинаковой формы; * для скаляра или матрица×матрица (достаточно 2D)
  • __iter__ выдаёт строки; вложенная итерация — элементы, если строки тоже итерируемы (или выдавайте элементы плоско — задокументируйте)
  • __eq__ по форме и значениям; нехешируемый (__hash__ = None)
  • __bool__ равен False для пустой матрицы (0 строк)

Пример:

m = Matrix([[1, 2], [3, 4]])
assert m[1, 0] == 3
assert m + m == Matrix([[2, 4], [6, 8]])

Глава 5

Наследование

Урок 21 · Часть II. ООП на Python

Наследование в объектно-ориентированном программировании

Источник: python-nasledovanie-v-obektno-orientirovannom-programmirovanii

На этом занятии мы начнем изучение важной темы в ООП – наследовании. Давайте предположим, что у нас в программе объявлены два независимых класса:

class Geom:
    name = 'Geom'
 
 
class Line:
    def draw(self):
        print("Рисование линии")

Как вы понимаете, если сейчас создать экземпляр класса Geom:

g = Geom()

то мы сможем обратиться к свойству name:

print(g.name)

но не сможем вызвать метод draw() класса Line, так как это совершенно другой, независимый класс. И то же самое для объекта Line:

l = Line()
l.draw()

Можно вызвать его метод draw(), но нельзя обратиться к свойству name другого класса Geom. То есть, эти классы, пространства имен совершенно независимы между собой. Но, при необходимости, мы можем установить связь между ними и, например, сделать так, чтобы открытые атрибуты класса Geom были доступны в классе Line. Записывается такая связка, следующим образом:

class Line(Geom):
    def draw(self):
        print("Рисование линии")

В круглых скобках мы указали класс Geom, который собираемся расширять классом Line и все, что доступно в классе Geom автоматически становится доступным и в классе Line. В частности, мы теперь можем совершенно спокойно обратиться к свойству name через объект класса Line:

print(l.name)

Такая конструкция, когда один класс определяется на основе другого, называется наследованием. Причем, класс Geom называется родительским или базовым , а класс Line – подклассом родительского или дочерним классом.

Графически иерархию наследования классов принято изображать в виде прямоугольников, соединенных стрелками, причем стрелка направлена от дочернего к базовому классу:

Иллюстрация к уроку

Для чего может понадобиться наследование? Давайте добавим в класс Line метод set_coords для записи координат в объект-линию:

    def set_coords(self, x1, y1, x2, y2):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2

А, затем, определим еще один подобный класс для прямоугольников:

class Rect(Geom):
    def set_coords(self, x1, y1, x2, y2):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
 
    def draw(self):
        print("Рисование прямоугольника")

Как видите, у нас здесь налицо дублирование кода. И оно будет быстро нарастать с увеличением классов для различных геометрических фигур. Чтобы этого не было, мы можем общее для всех дочерних классов (от Geom) вынести в базовый и, в частности, записать в нем метод set_coords. В итоге получим, следующие определения классов:

class Geom:
    name = 'Geom'
 
    def set_coords(self, x1, y1, x2, y2):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
 
 
class Line(Geom):
    def draw(self):
        print("Рисование линии")
 
 
class Rect(Geom):
    def draw(self):
        print("Рисование прямоугольника")

В результате мы устранили дублирование кода и можем вызывать метод set_coords из базового класса через объекты дочерних классов:

l = Line()
r = Rect()
l.set_coords(1, 1, 2, 2)
r.set_coords(1, 1, 2, 2)

А иерархия наследования принимает вид:

Иллюстрация к уроку

Давайте теперь внимательнее посмотрим, как отрабатывает метод set_coords базового класса Geom. Во-первых, когда происходит его вызов, например, через объект класса Line:

l.set_coords(1, 1, 2, 2)

то метод с таким названием сначала ищется в классе Line и если не находится, то поиск продолжается в базовых классах. В данном случае – это класс Geom. В нем этот метод обнаруживается и запускается.

Во-вторых, при вызове метода set_coords() из базового класса его параметр self будет ссылаться на объект, через который этот метод был вызван. То есть, на объект класса Line. Вот это очень важный момент! Параметр self в базовых классах может ссылаться не только на объекты этого же класса, но и на объекты производных (дочерних) от него классов, как в нашем случае – на объект класса Line. Почему это важно? Смотрите, формально сейчас мы можем в методе set_coords() вызвать метод дочернего класса draw():

    def set_coords(self, x1, y1, x2, y2):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
        self.draw()

И после запуска программы увидим, что сначала была нарисована линия, а затем, прямоугольник. Потому что сначала вызывался метод set_coords() через объект класса Line, а потом – через объект класса Rect. Но такой вызов метода draw() таит в себе потенциальную ошибку. Если мы создадим объект базового класса:

g = Geom()

а, затем, вызовем все тот же метод set_coords():

g.set_coords(0, 0, 0, 0)

то при выполнении программы получим ошибку, что метод draw() не определен. Действительно, теперь параметр self метода set_coords() ссылается на объект базового класса Geom, а в нем метод draw отсутствует. Отсюда и получается такая ошибка. Поэтому, при реализации методов в классах следует придерживаться одного простого правила: внутри них обращаться только к разрешенным атрибутам либо внутри текущего класса, либо базовых классов. Но не дочерних.

Я уберу вызов метода draw() в методе set_coords() и теперь никаких ошибок у нас не возникает.

Похожим образом происходит и обращение к свойствам базовых классов. Сейчас в классе Geom прописано свойство name и, как мы видели, к нему можно совершенно спокойно обращаться из объектов дочерних классов:

print(l.name)
print(r.name)

То есть, если указанное свойство не находится в соответствующем дочернем классе, то поиск продолжается в базовых. Однако, если свойство name прописать непосредственно в дочернем классе, например, Line:

class Line(Geom):
    name = 'Line'
 
    def draw(self):
        print("Рисование линии")

то для объектов-линий оно будет взято непосредственно из класса Line, а для прямоугольников, по-прежнему, из базового класса Geom.

Кстати, когда мы определяем какой-либо существующий атрибут в дочернем классе – это называется переопределением. То есть, мы переопределили атрибут name, который присутствует в базовом классе Geom и интегрированная среда нам об этом сигнализирует стрелочкой вверх.

То же самое происходит и при переопределении методов. Давайте добавим в класс Geom метод draw():

    def draw(self):
        print("Рисование примитива")

и видим, что у этого метода в базовом классе нарисована стрелочка вниз, а в дочерних – стрелочка вверх. Это и есть обозначения переопределения методов.

Работают они очевидным образом. Если draw() вызвать из дочерних объектов:

l.draw()
r.draw()

то будут вызваны соответствующие методы дочерних классов. А если мы вызываем draw() из базового класса:

g = Geom()
g.draw()

то будет вызван метод базового класса. Разумеется, если в каком-либо дочернем классе убрать метод draw(), например, в прямоугольнике, то для него будет вызван метод уже базового класса.

На этом мы завершим наше первое знакомство с механизмом наследования. Надеюсь все описанные моменты вам здесь были понятны и если это так, то переходите к следующему занятию, где будем продолжать изучение этой важной темы.

Урок 22 · Часть II. ООП на Python

Функция issubclass(). Наследование от встроенных типов и от object

Источник: python-funkciya-issubclass-nasledovanie-ot-vstroennyh-tipov-i-ot-object

Мы продолжаем изучение важной темы в ООП – наследование. Вначале нашего курса по ООП я говорил, что пользовательский класс по умолчанию автоматически наследуется от базового класса object языка Python. Например, если записать некий класс Geom без какой-либо реализации:

class Geom:
    pass

то, смотрите, в среде PyCharm записав ниже «Geom.» мы увидим список различных методов и свойств. Например, можно вывести значение свойства class:

print(Geom.__class__)

Откуда все это взялось? Как вы уже догадались, от базового класса object, который неявно добавляется, начиная с версии языка Python 3. Это эквивалентно такой записи:

class Geom(object):
    pass

И все эти атрибуты находятся в классе object.

Зачем это было сделано? Очевидно, чтобы обеспечить стандартный базовый функционал работы с классами. В частности, когда мы создаем экземпляр класса:

g = Geom()

а, затем, выводим его с помощью функции print:

print(g)

то автоматически отрабатывает магический метод str, который определен в базовом классе object. И так со всеми атрибутами, ничего лишнего там нет. Как вы понимаете, иметь такой базовый функционал очень удобно, поэтому в Python происходит такое наследование по умолчанию от object. В результате, мы имеем иерархию наследования:

Иллюстрация к уроку

Однако, если добавить дочерний класс от Geom, например, класс Line для представления линии:

class Geom(object):
    pass
 
 
class Line(Geom):
    pass

то иерархия наследования уже будет такой:

Иллюстрация к уроку

То есть, указывая в качестве базового любой другой класс, непосредственное наследование от object уже не происходит, только косвенное – через базовые классы. Разумеется, здесь объекты Line также имеют полный доступ ко всем открытым атрибутам класса object:

l = Line()
print(l.__class__)

Мало того, мы можем определять, является ли тот или иной класс подклассом другого класса. Это делает функция issubclass(), например:

print(issubclass(Line, Geom))

Она возвращает значение True, если класс Line является подклассом класса Geom. А вот если указать их в другом порядке:

print(issubclass(Geom, Line))

то получим False, так как класс Geom не является дочерним от класса Line.

А вот с объектами классов эта функция не работает. Если записать:

print(issubclass(l, Geom))

то получим ошибку, что аргумент должен быть классом, а не его экземпляром. Если нам все же нужно проверить принадлежность объекта тому или иному классу, в том числе и базовому, то следует использовать уже знакомую нам функцию isinstance():

print(isinstance(l, Geom))
print(isinstance(l, Line))

В обоих случаях получим значение True. Также истину вернет и проверка на базовый класс object:

print(isinstance(l, object))

Это еще раз показывает, что все классы неявно наследуются от object.

Наследование от встроенных типов данных

Интересный факт языка Python, что все стандартные типы данных являются классами:

Иллюстрация к уроку

Мы в этом легко можем убедиться, если выполним для них функцию issubclass():

issubclass(int, object)
issubclass(list, object)

Всюду увидим True. А мы знаем, что эта функция работает исключительно с классами, а не объектами, поэтому данный факт подтверждает, что эти типы являются классами языка Python.

Раз это так, то что нам мешает наследоваться от них и расширять функционал по мере необходимости? Ничего, поэтому можно сделать, например, такую реализацию:

class Vector(list):
    def __str__(self):
        return " ".join(map(str, self))
 
 
v = Vector([1, 2, 3])
print(v)

Мы здесь переопределили магический метод str для вывода списка в виде набора данных через пробел. Мало того, теперь тип данных нашего списка стал не list, а Vector:

print(type(v))

увидим:

<class ‘main.Vector’>

Конечно, стандартные типы данных редко расширяют с помощью пользовательских классов, но понимать, что они представляют собой классы и что такая возможность в принципе существует, важно.

Итак, из этого занятия вы должны были узнать, что все классы по умолчанию наследуются от базового класса object, как работает функция issubclass() и что из себя представляют встроенные типы данных языка Python.

Урок 23 · Часть II. ООП на Python

Наследование. Функция super() и делегирование

Источник: python-nasledovanie-funkciya-super-i-delegirovanie

Мы продолжаем изучение темы «наследование». Это занятие я начну с простой, но важной терминологии. Сморите, если у нас имеется некий базовый класс Geom и мы создаем дочерний класс Line, в котором дополнительно прописан метод draw(), то это называется расширением (extended) базового класса:

class Geom:
    name = 'Geom'
 
 
class Line(Geom):
    def draw(self):
        print("Рисование линии")

Как правило, дочерние создаются именно для расширения функциональности базовых классов. Однако, если в классе Geom также прописать метод draw():

class Geom:
    name = 'Geom'
 
    def draw(self):
        print("Рисование примитива")

то теперь класс Line лишь переопределяет (overriding) поведение базового класса, не меняя его принцип функционирования. Поэтому, когда говорят о расширении, то подразумевают добавление новых атрибутов в дочерних классах, а при переопределении (обычно методов) – изменение поведения уже существующего функционала.

Функция super() и делегирование

Давайте теперь пропишем инициализатор в базовом классе Geom (метод draw уберем):

class Geom:
    name = 'Geom'
 
    def __init__(self):
        print("инициализатор Geom")

А ниже создадим экземпляр класса Line:

l = Line()

После запуска программы увидим ожидаемое поведение – был автоматически вызван инициализатор базового класса. В действительности, здесь происходит следующая последовательность вызовов магических методов. Сначала вызывается call(), который, в свою очередь, последовательно вызывает метод new() для создания экземпляра класса, а затем, метод init() для его инициализации. Так вот, все эти методы вызываются из дочернего класса Line. Если какой-либо из них не находится, то поиск продолжается в родительских классах в порядке иерархии наследования. Например, метод new() в данном случае будет взят из метакласса type, который неявно вызывается при создании классов (подробнее о метаклассах мы еще будем говорить). А вот метод init() мы прописали в классе Geom, поэтому будет вызван именно он. Причем, параметр self в этом методе будет ссылаться на созданный объект класса Line. Об этом мы с вами уже говорили и это следует помнить. Параметр self в методах класса всегда ссылается на объект, из которого метод был вызван.

Отлично, я думаю в целом схема вызова методов в момент создания экземпляров классов, понятна. И в соответствии с ней, если мы определим инициализатор в классе Line, то именно он и должен вызваться. Давайте это сделаем:

class Line(Geom):
    def __init__(self):
        print("инициализатор Line")
 
    def draw(self):
        print("Рисование линии")

Запустим программу и теперь видим, что действительно, вызывается именно метод init класса Line. Я перепишу его со следующими параметрами:

    def __init__(self, x1, y1, x2, y2):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2

Это координаты начала и конца линии на плоскости. Соответственно, при создании объектов этого класса, мы теперь должны передавать аргументы:

l = Line(0, 0, 10, 20)

Все работает и никаких проблем у нас нет. Но, давайте теперь добавим еще один класс Rect для прямоугольников:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill=None):
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
        self.fill = fill
 
    def draw(self):
        print("Рисование прямоугольника")

Смотрите, у нас получилось дублирование кода. Это очень нехорошо. Но мы знаем, как это можно поправить. Давайте общее этих методов вынесем в базовый класс Geom:

class Geom:
    name = 'Geom'
 
    def __init__(self, x1, y1, x2, y2):
        print(f"инициализатор Geom для {self.__class__}")
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2

В дочернем классе Line уберем инициализатор, т.к. он полностью повторяется в Geom, а класс Rect запишем в виде:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill=None):
        print("инициализатор Rect")
        self.fill = fill
 
    def draw(self):
        print("Рисование прямоугольника")

Ниже создадим экземпляры обоих классов:

l = Line(0, 0, 10, 20)
r = Rect(1, 2, 3, 4)

После запуска увидим следующее:

инициализатор Geom для <class ‘main.Line’>
инициализатор Rect

О чем это говорит? Для класса Line был вызван инициализатор в базовом классе Geom, а для класса Rect не вызывался – только инициализатор самого класса. И это логично, так как метод init() был найден в Rect и дальше цепочка поиска не продолжалась. Но нам же нужно при создании примитивов также вызывать инициализатор и базового класса Geom. Как это сделать? Конечно, мы могли бы явно указать имя базового класса Geom и вызвать через него магический метод init() в инициализаторе класса Rect:

    def __init__(self, x1, y1, x2, y2, fill=None):
        Geom.__init__(self, x1, y1, x2, y2)
        print("инициализатор Rect")
        self.fill = fill

Но явно указывать имена базовых классов не лучшая практика, так как имена и иерархия наследования могут меняться. Поэтому в Python для обращения к базовому классу используется специальная функция super():

    def __init__(self, x1, y1, x2, y2, fill=None):
        super().__init__(x1, y1, x2, y2)
        print("инициализатор Rect")
        self.fill = fill

Она возвращает ссылку на, так называемый, объект-посредник, через который происходит вызов методов базового класса.

Теперь, при запуске программы мы видим, что был вызван инициализатор сначала класса Geom, а затем, для Rect. Такое обращение к переопределенным методам базового класса с помощью функции super() называется делегированием. То есть, мы делегировали вызов инициализатора класса Geom, чтобы он создал в нашем объекте локальные свойства с координатами углов прямоугольника. Причем, вызов метода init() базового класса лучше делать в первой же строчке, чтобы он случайно не переопределял какие-либо локальные свойство в дочернем классе. Например, если в базовом init() дополнительно прописать:

    def __init__(self, x1, y1, x2, y2):
        print(f"инициализатор Geom для {self.__class__}")
        self.x1 = x1
        self.y1 = y1
        self.x2 = x2
        self.y2 = y2
        self.fill = 0

А в дочернем его вызвать в последнюю очередь:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill=None):
        print("инициализатор Rect")
        self.fill = fill
        super().__init__(x1, y1, x2, y2)

то, очевидно, свойство fill будет неявно переопределено при вызове init() базового класса:

print(r.__dict__)

Подобные причины и рекомендуют делать вызов инициализатора базового класса в первой же строчке:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill=None):
        super().__init__(x1, y1, x2, y2)
        print("инициализатор Rect")
        self.fill = fill

Теперь у нас нет проблем с определением локального свойства fill.

Надеюсь, из этого занятия вы узнали о понятиях расширения классов и переопределения их методов, разобрались с работой функции super(), а также делегированием методов, то есть их вызовом из базового класса через функцию super().

Урок 24 · Часть II. ООП на Python

Наследование. Атрибуты private и protected

Источник: python-nasledovanie-atributy-private-i-protected

Мы продолжаем изучение темы «наследование». На этом занятии мы увидим, как влияет режим доступа private и protected атрибутов при наследовании классов.

Ранее мы с вами об этом уже говорили и в частности отмечали, что:

  • _attribute (с одним подчеркиванием) – режим доступа protected (служит для обращения внутри класса и во всех его дочерних классах)
  • __attribute (с двумя подчеркиваниями) – режим доступа private (служит для обращения только внутри класса).

Давайте посмотрим, как ведут себя атрибуты с этими режимами доступа при наследовании. Возьмем пример из предыдущего занятия с двумя классами:

class Geom:
    name = 'Geom'
 
    def __init__(self, x1, y1, x2, y2):
        print(f"инициализатор Geom для {self.__class__}")
        self.__x1 = x1
        self.__y1 = y1
        self.__x2 = x2
        self.__y2 = y2
 
 
class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill='red'):
        super().__init__(x1, y1, x2, y2)
        self.__fill = fill

Здесь мы пытаемся в инициализаторе базового класса Geom сформировать приватные локальные свойства с координатами прямоугольника. Дополнительно в инициализаторе самого класса создается приватное свойство __fill.

Ниже создадим объект класса Rect:

r = Rect(0, 0, 10, 20)

и выведем все его локальные атрибуты в консоль:

print(r.__dict__)

После запуска программы увидим следующие строчки:

инициализатор Geom для <class ‘main.Rect’>
{‘_Geom__x1’: 0, ‘_Geom__y1’: 0, ‘_Geom__x2’: 10, ‘_Geom__y2’: 20, ‘_Rect__fill’: ‘red’}

Смотрите, локальные свойства с координатами имеют префикс _Geom, то есть, префикс того класса, в котором они непосредственно были прописаны. Несмотря на то, что параметр self является ссылкой на объект класса Rect. Это особенность поведения (формирования) приватных атрибутов в базовых классах. У них всегда добавляется префикс именно базового класса, а не класса объекта self. А вот последнее свойство __fill имеет ожидаемый префикс _Rect, так как оно было создано в классе Rect.

Что из этого следует? Во-первых, мы, конечно же, не можем обратиться в свойствам-координатам в дочернем классе Rect. Если в нем прописать метод get_coords():

    def get_coords(self):
        return (self.__x1, self.__y1, self.__x2, self.__y2)

а, затем, вызвать через объект класса Rect:

r.get_coords()

то увидим ошибку AttributeError. Но если перенести этот метод в базовый класс Geom, то все сработает без ошибок, так как приватным свойствам будет добавлен правильный префикс _Geom.

Возможно, вам кажется это немного запутанным? Но давайте вспомним, а для чего вообще нужны и когда используются приватные атрибуты. Мы говорили, что это закрытые от внешнего вмешательства свойства или методы текущего класса, доступные только внутри этого класса и недоступные из других, в том числе и из дочерних классов. Именно поэтому приватные атрибуты жестко привязываются к текущему классу, в котором они создаются, так как по логике предполагается их использовать только внутри этого класса и больше нигде.

Если же нам нужно определить закрытые атрибуты, доступные в текущем классе и во всех его дочерних классах, то для этого следует использовать метод определения protected – одно нижнее подчеркивание. Поэтому правильнее было бы создавать свойства-координаты в базовом инициализаторе в режиме protected:

class Geom:
    name = 'Geom'
 
    def __init__(self, x1, y1, x2, y2):
        print(f"инициализатор Geom для {self.__class__}")
        self._x1 = x1
        self._y1 = y1
        self._x2 = x2
        self._y2 = y2
 
 
class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill='red'):
        super().__init__(x1, y1, x2, y2)
        self._fill = fill
 
    def get_coords(self):
        return (self._x1, self._y1, self._x2, self._y2)

Тогда никаких проблем с доступом уже не возникает:

r = Rect(0, 0, 10, 20)
print(r.__dict__)
r.get_coords()

После запуска программы увидим следующие строчки:

инициализатор Geom для <class ‘main.Rect’>
{‘_x1’: 0, ‘_y1’: 0, ‘_x2’: 10, ‘_y2’: 20, ‘_fill’: ‘red’}

Опять же, как я ранее отмечал, режим доступа protected в реальности никак не ограничивает доступ к атрибутам объектов класса или самого класса. Например, мы можем обратиться к координатам напрямую через экземпляр класса:

print(r._x1)

Никаких ошибок не будет. Нижнее подчеркивание лишь предупреждает (сигнализирует) программиста о защищенном атрибуте, к которому напрямую лучше не обращаться. Этот атрибут был создан для внутренней логики работы алгоритма в классе и не предназначен для обращения извне. В дальнейшем это может привести к проблемам, например, при изменении версии класса, в котором такого атрибута уже не будет, или он будет играть другую роль и т.п.

Атрибуты private и protected на уровне класса

Все также работает и с атрибутами уровня класса. Например, сейчас мы совершенно спокойно можем обратиться к свойству name класса Geom через объект класса Rect:

print(r.name)

Добавив одно нижнее подчеркивание, функционал останется прежним, мы лишь отметим, что к этой переменной извне лучше не обращаться:

print(r._name)

Но, если прописать два подчеркивания, то доступ будет закрыт всюду, кроме самого класса Geom:

print(r.__name)

или так:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill='red'):
        super().__init__(x1, y1, x2, y2)
        self._fill = fill
        self._name = self.__name

Но в Geom мы можем к ней обращаться:

class Geom:
    __name = 'Geom'
 
    def __init__(self, x1, y1, x2, y2):
        print(f"инициализатор {self.__name}")
        self._x1 = x1
        self._y1 = y1
        self._x2 = x2
        self._y2 = y2

Те же ограничения доступа можно накладывать и на методы. Если в базовом классе Geom определить приватный метод, например, для проверки корректности значений координат:

class Geom:
    ...
 
    def __verify_coord(self, coord):
        return 0 <= coord <= 100

то он будет доступен только внутри этого класса и вызвать его, скажем, в дочернем классе Rect уже не получится:

class Rect(Geom):
    def __init__(self, x1, y1, x2, y2, fill='red'):
        super().__init__(x1, y1, x2, y2)
        super().__verify_coord(x1)
        self._fill = fill

Кстати, этот пример также показывает, что приватность запрещает переопределение методов в дочерних классах. Если же у метода прописать только одно подчеркивание, то его можно будет вызывать во всех дочерних классах.

Я, надеюсь, вы теперь знаете, как работают режимы доступа атрибутов при наследовании классов и сможете их грамотно применять в своих программах.

Урок 25 · Часть II. ООП на Python

Полиморфизм и абстрактные методы

Источник: python-polimorfizm-i-abstraktnye-metody

На этом занятии я хочу затронуть следующий важный вопрос ООП: что такое полиморфизм и как он реализуется на Python? Вначале вспомним, что

Полиморфизм – это возможность работы с совершенно разными объектами (языка Python) единым образом.

Кажется, пока не особо понятно? Поэтому давайте, как всегда, постигнем суть этого подхода на конкретном примере.

Вначале я продемонстрирую пример, где мы увидим один недостаток, который как раз исправляется с помощью полиморфизма. Предположим, у нас есть два класса Rectangle и Square:

class Rectangle:
    def __init__(self, w, h):
        self.w = w
        self.h = h
 
    def get_rect_pr(self):
        return 2*(self.w+self.h)
 
 
class Square:
    def __init__(self, a):
        self.a = a
 
    def get_sq_pr(self):
        return 4*self.a

И в них объявлены геттеры get_rect_pr() и get_sq_pr() для получения периметра соответствующих фигур: прямоугольника и квадрата. Далее, мы можем создать экземпляры этих классов и вывести в консоль значения периметров:

r1 = Rectangle(1, 2)
r2 = Rectangle(3, 4)
print(r1.get_rect_pr(), r2.get_rect_pr())
 
s1 = Square(10)
s2 = Square(20)
print(s1.get_sq_pr(), s2.get_sq_pr())

Все отлично, все работает. Но, теперь предположим, что все эти объекты помещаются в коллекцию:

geom = [r1, r2, s1, s2]

которую можно легко перебрать с помощью цикла for и где бы мы хотели получить значение периметра для каждой фигуры:

for g in geom:
    print(g.get_rect_pr())

Как вы понимаете, когда в цикле очередь дойдет до объекта s1, возникнет ошибка, т.к. в классе Square отсутствует метод get_rect_pr(). Конечно, зная, что в коллекции находятся объекты Rectangle и Square, можно было бы в цикле записать проверку:

for g in geom:
    if isinstance(g, Rectangle):
        print(g.get_rect_pr())
    else:
        print(g.get_sq_pr())

и все заработает. Но у такого кода мало гибкости и, например, при добавлении еще одного класса:

class Triangle:
    def __init__(self, a, b, c):
        self.a = a
        self.b = b
        self.c = c
 
    def get_tr_pr(self):
        return self.a + self.b + self.c

Получим снова ошибку:

t1 = Triangle(1,2,3)
t2 = Triangle(4,5,6)
geom = [r1, r2, s1, s2, t1, t2]

Конечно, в цикле for можно дополнительно проверить на соответствие классам Square и Triangle, но красоты и гибкости нашей программе это не придаст. Вот как раз здесь очень хорошо применим подход, который и называется полиморфизмом. Мы договоримся в каждом классе создавать методы с одинаковыми именами, например,

get_pr()

Тогда в цикле будем просто обращаться к этому методу и получать периметры соответствующих фигур:

for g in geom:
    print( g. get_pr() )

Иллюстрация к уроку

И это логично, так как каждая ссылка списка ведет на соответствующий объект класса и далее через нее происходит прямой вызов метода get_pr(). Это и есть пример полиморфизма, когда к разным объектам мы обращаемся через индекс единого списка geom (единый интерфейс), а затем, вызываем геттер get_pr() соответствующего объекта.

Мало того, мы можем сформировать этот список, сразу создавая в нем объекты соответствующих классов:

geom = [Rectangle(1, 2), Rectangle(3, 4),
        Square(10), Square(20),
        Triangle(1, 2, 3), Triangle(4, 5, 6)
        ]

Мне кажется, так программа выглядит несколько приятнее и читабельнее.

Абстрактные методы

Но у нашей реализации есть один существенный недостаток. Что если мы забудем в каком-либо классе определить метод get_pr(), например, в Triangle. Тогда, очевидно, программа приведет к ошибке. Как можно было бы этого избежать? Один из вариантов определить базовый класс для классов геометрических примитивов и в нем прописать реализацию геттера get_pr(), используемую по умолчанию, например, так:

class Geom:
    def get_pr(self):
        return -1

А все остальные классы унаследовать от него:

class Rectangle(Geom):
...
 
 
class Square(Geom):
...
 
 
class Triangle(Geom):
...

Теперь, после запуска программы, для треугольников будем получать значения -1.

Но и это не самое лучшее решение. Все же, нам бы хотелось, чтобы каждый дочерний класс имел бы обязательную реализацию метода get_pr(). Для этого в геттере get_pr() мы будем генерировать специальное исключение NotImplementedError, следующим образом:

class Geom:
    def get_pr(self):
        raise NotImplementedError("В дочернем классе должен быть переопределен метод get_pr()")

И если в каком-либо дочернем классе не будет определен метод get_pr(), то вызовется метод базового класса и выдаст ошибку NotImplementedError, которая будет сигнализировать о том, что метод не переопределен.

Запустим программу и действительно видим это сообщение при попытке вызвать get_pr() для объектов Triangle. Причем, видя ошибку NotImplementedError, мы понимаем, что она связана именно с необходимостью переопределения get_pr(), а не с чем-то другим. В этом плюс такого подхода.

В языках программирования методы, которые обязательно нужно переопределять в дочерних классах и которые не имеют своей собственной реализации называют абстрактными. Конечно, в языке Python нет чисто абстрактных методов. Здесь мы лишь выполнили имитацию их поведения, заставляя программиста определять геттер get_pr() в дочерних классах, самостоятельно генерируя исключение NotImplementedError.

Итак, из этого занятия я, думаю, вы поняли, что из себя представляет полиморфизм и как он реализуется на Python. Также узнали, как можно определять методы, которые ведут себя подобно абстрактным с необходимостью их переопределения в дочерних классах.

Урок 26 · Часть II. ООП на Python

Множественное наследование

Источник: python-mnozhestvennoe-nasledovanie

Мы продолжаем изучать тему наследования. В языке Python допускается множественное наследование, когда один дочерний класс образуется сразу от нескольких базовых, согласно синтаксису:

class A(base1, base2, …, baseN):
…

Давайте посмотрим, как это работает и для чего вообще нужно. Признаюсь честно, я не сразу смог придумать учебный пример, где можно было бы показать целесообразность применения множественного наследования. То есть, он применяется не так часто, как обычное наследование от одного класса. Но, тем не менее это тоже важный механизм и некоторые подходы к программированию его активно используют. Например, идея миксинов (mixins) в Python реализуется через множественное наследование. И учебный пример я решил связать именно с ними, а заодно показать еще один прием в программировании.

Давайте представим, что мы делаем интернет-магазин по продаже товаров, например, ноутбуков, дисков, процессоров и т.п. Каждый товар будет определяться своим классом, а общим (базовым) для них всех будет класс Goods – товары. Также у каждого товара обязательно будут поля:

  • name – наименование
  • weight – вес
  • price – цена

Для примера запишем в нашей программе базовый класс Goods:

class Goods:
    def __init__(self, name, weight, price):
        print("init MixinLog")
        self.name = name
        self.weight = weight
        self.price = price
 
    def print_info(self):
        print(f"{self.name}, {self.weight}, {self.price}")

И один дочерний класс для ноутбуков:

class NoteBook(Goods):
    pass

Затем, мы можем создать объект для ноутбука:

n = NoteBook("Acer", 1.5, 30000)

и распечатать информацию о нем:

n.print_info()

Пока ничего нового здесь нет. Но потом, к нам подходит тимлид и говорит:

- Дорогой сеньор, добавь, пожалуйста, возможность логирования товаров магазина.

И как бы вы поступили на месте этого сеньора? Плохой сеньор начнет прописывать логику логирования либо непосредственно в базовом классе Goods, либо уровнем выше (в иерархии наследования). А хороший воспользуется идеей миксинов. Для этого он создаст еще один класс, который можно назвать:

class MixinLog:
    ID = 0
 
    def __init__(self):
        print("init MixinLog")
        self.ID += 1
        self.id = self.ID
 
    def save_sell_log(self):
        print(f"{self.id}: товар продан в 00:00 часов")

Этот класс работает совершенно независимо от классов Goods и Notebook и лишь добавляет функционал по логированию товаров с использованием их id. Такие независимые базовые классы и получили название миксинов – примесей.

Добавим этот класс в цепочку наследования:

class NoteBook(Goods, MixinLog):
    pass

а ниже вызовем метод save_sell_log():

n.save_sell_log()

И видим ошибку. Очевидно, она связана с тем, что у второго класса MixinLog не был вызван инициализатор. Почему так произошло? Как мы уже знаем, при создании объектов инициализатор ищется сначала в дочернем классе, но так как его там нет, то в первом базовом Goods. Он там есть, выполняется и на этом инициализация нашего объекта NoteBook завершается. Однако, нам нужно также взывать инициализатор и второго базового класса MixinLog. В данном случае, сделать это можно с помощью объекта-посредника super(), которая и делегирует вызов метода init класса MixinLog:

class Goods:
    def __init__(self, name, weight, price):
        super().__init__()
        print("init Goods")
        self.name = name
        self.weight = weight
        self.price = price
…

Теперь, после запуска программы, мы видим, что оба инициализатора сработали и ошибок никаких нет.

Но откуда функция super() «знает», что нужно обратиться ко второму базовому классу MixinLog, а, скажем, не к базовому классу object, от которого неявно наследуются все классы верхнего уровня? В Python существует специальный алгоритм обхода базовых классов при множественном наследовании. Сокращенно, он называется:

MRO – Method Resolution Order

И говорит, в каком порядке обходить базовые классы:

Иллюстрация к уроку

Мы можем увидеть эту цепочку обхода базовых классов, если распечатать специальную коллекцию mro любого класса:

print(NoteBook.__mro__)

В консоли появится следующая последовательность:

(<class ‘main.NoteBook’>, <class ‘main.Goods’>, <class ‘main.MixinLog’>, <class ‘object’>)

То есть, методы сначала ищутся в самом классе NoteBook, затем, в классе Goods, далее идет класс MixinLog и от него уже идет к классу object. Это цепочка обхода для нашего конкретного примера. При другой иерархии наследования эта цепочка может быть другой, но одно всегда неизменно –первый базовый класс, указанный при наследовании, выбирается первым (после дочернего, разумеется). И это важный момент. Вы всегда можете быть уверены, что инициализатор первого базового класса сработает в первую очередь. Почему это важно? Смотрите, при создании объекта NoteBook мы передаем ему три аргумента. Эти три аргумента, затем, передаются в инициализатор. И так как первым будет вызван инициализатор класса Goods, то мы уверены, что эти аргументы будут переданы именно в него, а не в какой-то другой инициализатор других базовых классов. И какая бы цепочка наследования у нас ни была, все равно первым будет вызываться метод init класса Goods, потому что он записан первым. Это гарантирует работоспособность нашей программы при разных иерархиях множественного наследования.

Ради интереса, давайте поменяем местами базовые классы:

class NoteBook(MixinLog, Goods):
    pass

И мы сразу получаем ошибку, что в метод init передаются четыре аргумента, а он принимает только один, так как здесь отрабатывает инициализатор уже класса MixinLog. Так что порядок следования базовых классов при множественном наследовании имеет важное значение. Первым должен идти «основной» класс и у него, как правило, инициализатор имеет несколько параметров. А далее, записываются классы, у которых, опять же, как правило, инициализаторы имеют только параметр self. Это второй важный момент. Когда мы собираемся использовать множественное наследование, то структуру классов следует продумывать так, чтобы инициализаторы вспомогательных классов имели только один параметр self, иначе будут сложности их использования. В чем они состоят?

Давайте для примера пропишем в инициализаторе класса MixinLog один параметр p1

class MixinLog:
    def __init__(self, p1):
        super().__init__(1, 2)
        …

И объявим еще один класс миксинов, где в инициализаторе два параметра:

class MixinLog2:
    def __init__(self, p1, p2):
        super().__init__()
        print("init MixinLog 2")

В каждом методе init мы также делаем делегированный вызов инициализатора следующего базового класса. А цепочка наследования будет такой:

class NoteBook(Goods, MixinLog, MixinLog2):
    pass

Сейчас при запуске у нас не возникает никаких ошибок, так как последовательность MRO имеет вид:

(<class ‘main.NoteBook’>, <class ‘main.Goods’>, <class ‘main.MixinLog’>, <class ‘main.MixinLog2’>, <class ‘object’>)

То есть, мы знаем, что функция super() в классе Goods вызовет метод init класса MixinLog с одним дополнительным параметром, а затем, метод init класса MixinLog2 с двумя дополнительными параметрами. И мы «жестко» это прописали. Но, как вы понимаете, если хотя бы немного изменится цепочка наследования, например, так:

class NoteBook(Goods, MixinLog2, MixinLog):
    pass

то все нарушится и получим ошибки. Чтобы в программах при множественном наследовании не возникало проблем с зависимостью последовательности наследования дополнительных базовых классов, их инициализаторы следует создавать с одним параметром self и в каждом из них прописывать делегированный вызов инициализатора следующего класса командой:

super().__init__()

Тогда точно никаких особых проблем при использовании множественного наследования не возникнет.

Последнее, что я хочу отметить на этом занятии, это вызов методов с одинаковыми именами из базовых классов. Давайте предположим, что в классе MixinLog имеется метод print_info с тем же именем, что и в классе Goods:

    def print_info(self):
        print("print_info класса MixinLog")

Понятно, что если сейчас его вызвать через объект класса NoteBook:

n.print_info()

то мы обратимся к методу класса Goods, так как он записан первым в цепочке наследования и в соответствии с алгоритмом обхода MRO он будет найден первым. Но что если мы хотим вызвать этот метод из второго базового класса MixinLog? Как поступить? Сделать это можно двумя способами. Либо напрямую вызвать этот метод через класс MixinLog:

MixinLog.print_info(n)

Обратите внимание, что в этом случае нам обязательно нужно указать первым аргументом ссылку на объект класса NoteBook. Либо, определить какой-либо метод в классе NoteBook (пусть он называется также):

class NoteBook(Goods, MixinLog):
    def print_info(self):
        MixinLog.print_info(self)

И тогда будет вызываться метод именно второго базового класса MixinLog.

Обычно, если нужно делать такие подмены, то есть, из конкретного дочернего класса вызывать метод другого (не первого) базового класса, то создают метод в дочернем классе с тем же именем, а затем, явно указывают нужный базовый класс.

Вот так работает множественное наследование в языке Python.

Практика 5 · Часть II. ООП на Python

Наследование

Задания для закрепления темы · решений нет

Цели обучения

  • Расширять классы и переиспользовать конструкторы через super()
  • Разбираться в issubclass / isinstance и name mangling
  • Проектировать полиморфные API с ABC
  • Комбинировать поведение через множественное наследование (с учётом MRO)

Задания

Задание 1. Иерархия Vehicle

Сложность: лёгкое

Реализуйте Vehicle(speed: float) с методом move(self) -> str, возвращающим "moving at {speed}".

Требования:

  • Car(speed, brand) расширяет Vehicle; move возвращает "Car {brand} moving at {speed}", используя super() где уместно
  • Bike(speed) переопределяет move, возвращая "Bike moving at {speed}"

Пример:

assert issubclass(Car, Vehicle)
assert "Toyota" in Car(60, "Toyota").move()

Задание 2. Расширение встроенного типа

Сложность: лёгкое

Реализуйте IntList(list), принимающий только значения int.

Требования:

  • Переопределите append и extend, отклоняя не-int через TypeError
  • __init__ может принимать итерируемое, но должен проверять элементы
  • issubclass(IntList, list) равен True

Задание 3. Protected vs private при наследовании

Сложность: среднее

Реализуйте базовый AccountBase с _rate (protected) и __code (private), плюс подкласс SavingsAccount.

Требования:

  • Метод подкласса describe(self) может читать _rate, но не должен опираться на __code без name mangling
  • Задокументируйте (кратким комментарием в коде), что возвращает hasattr(sub, '__code') vs _AccountBase__code
  • SavingsAccount добавляет метод projected(self, balance: float) -> float, использующий _rate

Задание 4. Shape ABC

Сложность: среднее

С помощью abc.ABC и @abstractmethod:

Требования:

  • Абстрактный Shape с area(self) -> float и perimeter(self) -> float
  • Конкретные Circle(radius) и Rectangle(width, height)
  • Функция total_area(shapes: list[Shape]) -> float, суммирующая площади (полиморфизм)

Пример:

shapes: list[Shape] = [Circle(1), Rectangle(2, 3)]
assert total_area(shapes) > 0

Задание 5. Mixin логирования + MRO

Сложность: среднее

Реализуйте миксины и комбинированный класс.

Требования:

  • LogMixin с методом log(self, msg: str), добавляющим сообщение в список экземпляра self.messages
  • TimestampMixin с stamp(self) -> float через time.time()
  • Service(LogMixin, TimestampMixin) с run(self), логирующим сообщение с меткой времени
  • Выведите или проверьте assert'ом, что Service.__mro__ начинается с Service, затем миксины, затем object

Задание 6. Мини-проект: каналы уведомлений

Сложность: сложное

Спроектируйте небольшую систему уведомлений.

Требования:

  • ABC Notifier с абстрактным send(self, message: str) -> None и конкретным send_batch(self, messages: list[str]), вызывающим send в цикле
  • EmailNotifier(address), SmsNotifier(phone) — сохраняют «отправленные» полезные нагрузки в self.outbox: list[str]
  • FailoverNotifier(primary: Notifier, secondary: Notifier) — пробует primary; при ConnectionError использует secondary
  • Вариант множественного наследования: LoggedEmailNotifier(LogMixin, EmailNotifier) логирует каждую отправку
  • Хелперные проверки issubclass для вашей иерархии в небольшом демо/if __name__ == "__main__"

Пример:

n = EmailNotifier("a@b.c")
n.send("hi")
assert n.outbox == ["hi"]

Глава 6

__slots__

Урок 27 · Часть II. ООП на Python

Коллекция <strong>slots</strong>

Источник: python-kollekciya-slots

На этом занятии мы с вами познакомимся со специальной коллекцией slots, которую можно прописывать в любом классе языка Python. Для простоты восприятия информации возьмем простой класс для представления точки на плоскости:

class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

Пока в этом классе нет коллекции slots, поэтому при создании его экземпляра можно свободно оперировать существующими свойствами:

pt = Point(1, 2)
pt.x
pt.y = 100

И создавать новые:

pt.z = 4

Как известно, список всех локальных свойств экземпляра класса хранится в его магическом списке dict:

pt.__dict__

Но что, если мы хотим объявить класс точки на плоскости, чтобы у его экземпляров были только два свойства x и y и никакие другие. Как это сделать? Для этого, как раз и применяется коллекция slots.

Давайте я создам для сравнения еще один класс, в котором укажу эту коллекцию:

class Point2D:
    __slots__ = ('x', 'y')
 
    def __init__(self, x, y):
        self.x = x
        self.y = y

Смотрите, мы в кортеже перечисляем атрибуты с именами x и y (указываются в виде строки) и только такие локальные свойства могут существовать в экземплярах этого класса. Проверим это. Создадим экземпляр:

pt2 = Point2D(10, 20)

Выведем свойства x и y, убедимся, что они присутствуют в экземпляре:

pt2.x
pt2.y

Но вот добавить новое уже не получится:

pt2.z = 30

Это произошло как раз по тому, что в классе прописана коллекция slots и мы ее можем даже вывести:

pt2.__slots__

А вот привычная нам коллекция

pt2.__dict__

будет отсутствовать. То есть, класс и его экземпляры ведут себя немного по-другому. Мы совершенно спокойно можем изменять, удалять и добавлять локальные свойства x, y:

pt2.x = 50
del pt2.y
pt2.y = 100

Но только их и никакие другие. Причем, обратите внимание, речь идет только о локальных свойствах экземпляров. В сам класс мы по-прежнему можем добавлять любые атрибуты, например, MAX_COORD:

class Point2D:
    __slots__ = ('x', 'y')
    MAX_COORD = 100
 
    def __init__(self, x, y):
        self.x = x
        self.y = y

Тогда в экземплярах этого класса появится это дополнительное свойство со значением 100.

Коллекция slots помимо ограничения создаваемых локальных свойств, еще уменьшает объем памяти, занимаемый экземпляром класса. Смотрите, если создать два экземпляра:

pt = Point(1, 2)
pt2 = Point2D(10, 20)

То первый будет содержать ссылку, как на объект класса, так и на коллекцию dict. А второй – только на пространство имен класса Point2D:

print(pt.__sizeof__(), pt.__dict__.__sizeof__())         
print(pt2.__sizeof__())

И еще коллекция slots ускоряет работу с локальными свойствами экземпляров класса. Например, если добавить в каждый класс метод:

    def calc(self):
        self.x += 1
        del self.y 
        self.y = 0

И замерить скорость его работы:

t1 = timeit.timeit(pt.calc)
t2 = timeit.timeit(pt2.calc)
 
print(t1, t2)

То мы увидим, что t1 больше, чем t2, то есть, класс Point2D работает быстрее с локальными свойствами, чем класс Point.

Вот такие три особенности дает коллекция slots экземплярам класса:

  • ограничение создаваемых локальных свойств;
  • уменьшение занимаемой памяти;
  • ускорение работы с локальными свойствами.

На следующем занятии мы продолжим эту тему и посмотрим, как эта коллекция ведет себя при наследовании классов.

Урок 28 · Часть II. ООП на Python

Как работает <strong>slots</strong> с property и при наследовании

Источник: python-kak-rabotaet-slots-s-property-i-pri-nasledovanii

Мы продолжаем изучение коллекции slots. Как мы говорили на предыдущем занятии, эта коллекция позволяет ограничивать список локальных свойств в экземплярах класса, в котором прописана. Например, для класса точки на плоскости мы разрешали только свойства с именами x и y:

class Point2D:
    __slots__ = ('x', 'y')
 
    def __init__(self, x, y):
        self.x = x
        self.y = y

А теперь, сделаем следующее. Добавим в эту коллекцию еще одно имя:

__slots__ = ('x', 'y', 'length')

Тогда, очевидно, мы его тоже сможем использовать в нашем классе, например, в конструкторе:

class Point2D:
    __slots__ = ('x', 'y', 'length')
 
    def __init__(self, x, y):
        self.x = x
        self.y = y
        self.length = (x*x + y*y) ** 0.5

И, далее, создавая экземпляр этого класса:

pt = Point2D(1, 2)

автоматически получаем свойство length с расстоянием до точки (относительно нуля):

pt.length

Но что если в этом классе прописать свойство (property) с тем же самым именем length? А в коллекции slots задать приватное свойство:

__slots__ = ('x', 'y', '__length')

Давайте добавим это свойство и посмотрим, что получится:

    @property
    def length(self):
        return self.__length
 
    @length.setter
    def length(self, value):
        self.__length = value

И, затем, после создания экземпляра класса, мы можем использовать такой синтаксис:

pt = Point2D(1, 2)
print(pt.length)

Смотрите, мы здесь обращаемся к свойству length, хотя в slots нет такого разрешенного имени. И при этом нет никаких ошибок выполнения. В принципе, так и должно быть, потому что length – это не локальная переменная экземпляра класса, а атрибут класса Point2D. Коллекция slots не накладывает ограничения на атрибуты класса, только на локальные атрибуты его экземпляров. Благодаря этому и появляется свойство length, которое работает как геттер и сеттер класса Point2D.

Поведение slots при наследовании классов

Следующий важный момент – это особенности работы коллекции slots при наследовании классов. Я сразу приведу пример, чтобы показать первую особенность этой коллекции. Допустим, мы создаем еще один класс Point3D, который наследует от класса Point2D и он пока будет пустым:

class Point3D(Point2D):
    pass

Тогда, для экземпляров этого класса будет разрешено создание локальных свойств, несмотря на то, что в базовом классе присутствует коллекция slots:

pt3 = Point3D(10, 20)
pt3.z = 30

То есть, по умолчанию эта коллекция не наследуется дочерними классами и они ведут себя как обычные, без каких-либо ограничений, сохраняя все локальные свойства, используя коллекцию:

pt3.__dict__

Однако, если мы ее пропишем даже без указания каких-либо элементов:

class Point3D(Point2D):
    __slots__ = ()

то ограничения вступят в свои права и она будет как бы унаследована от базового класса Point2D. То есть, в классе Point3D сейчас доступны только два локальных свойства x и y.

Но нам нужно разрешить еще одно имя z. Для этого достаточно одно его и прописать в этой коллекции:

class Point3D(Point2D):
    __slots__ = 'z',

Тогда имена x, y будут наследоваться от класса Point2D, а z – добавляться классом Point3D. Также обратите внимание на висячую запятую. Она означает, что z – это элемент кортежа, а не просто строка. Предпочтительно записывать в таком виде. Хотя, и без запятой тоже все будет работать.

Очевидно, следующим шагом надо добавить конструктор в дочерний класс. Запишем его в следующем виде:

class Point3D(Point2D):
    __slots__ = 'z',
 
    def __init__(self, x, y, z):
        super().__init__(x, y)
        self.z = z

И экземпляр будем создавать уже с тремя параметрами:

pt3 = Point3D(10, 20, 30)

Теперь, наш дочерний класс содержит уникальный код, расширяющий функционал базового класса без каких-либо повторений. При этом, в обоих классах используется ограничение, но с разным набором локальных свойств.

Надеюсь, из этих занятий вы стали лучше понимать работу этой коллекции и при необходимости применять ее в своих проектах.

Практика 6 · Часть II. ООП на Python

`__slots__`

Задания для закрепления темы · решений нет

Цели обучения

  • Ограничивать атрибуты экземпляра через __slots__
  • Совмещать __slots__ с property
  • Корректно расширять slotted-классы в подклассах

Задания

Задание 1. Point2D со slots

Сложность: лёгкое

Реализуйте Point2D с __slots__ = ("x", "y").

Требования:

  • __init__(self, x: float, y: float)
  • Присваивание нового атрибута (например, z) возбуждает AttributeError
  • Метод as_tuple(self) -> tuple[float, float]

Пример:

p = Point2D(1, 2)
assert p.as_tuple() == (1, 2)
# p.z = 3  -> AttributeError

Задание 2. Property со slots

Сложность: среднее

Реализуйте Celsius с __slots__ = ("_celsius",).

Требования:

  • Свойство celsius get/set с валидацией (>= -273.15)
  • Свойство fahrenheit get/set с преобразованием в обе стороны
  • У экземпляров нет __dict__

Подсказки:

  • Храните сырое значение в _celsius; отдавайте через properties

Задание 3. Slots в подклассе

Сложность: среднее

Реализуйте иерархию:

Требования:

  • Base с __slots__ = ("id",)
  • Child(Base) с __slots__ = ("name",)
  • У экземпляров Child только id и name
  • Покажите, что у экземпляров Child по-прежнему нет __dict__, пока вы сами его не добавите

Пример:

c = Child(1, "x")
assert c.id == 1 and c.name == "x"

Задание 4. Опциональный «люк» через dict

Сложность: среднее

Реализуйте Flexible с __slots__ = ("a", "__dict__").

Требования:

  • a — объявленный slot
  • Дополнительные атрибуты попадают в __dict__
  • Кратко прокомментируйте, когда этот паттерн полезен по сравнению с чистыми slots

Задание 5. Частица с упором на память

Сложность: сложное

Смоделируйте много лёгких объектов.

Требования:

  • Particle со slots x, y, vx, vy
  • Метод step(self, dt: float) -> None, обновляющий позицию
  • Класс ParticleSystem, хранящий list[Particle]
  • Методы add, step_all(dt), bounds → (min_x, min_y, max_x, max_y)
  • В демо создайте ≥ 1000 частиц и вызовите step_all (assert по производительности не требуется)

Подсказки:

  • Предпочитайте slots, чтобы отработать API, ориентированный на память, а не микробенчмарки

Глава 7

Исключения

Урок 29 · Часть II. ООП на Python

Введение в обработку исключений. Блоки try / except

Источник: python-vvedenie-v-obrabotku-isklyucheniy-bloki-try-except

Начиная с этого занятия, мы коснемся довольно важной темы в программировании – обработка исключений. Давайте вначале я поясню, что стоит за этими «умными» словами. Предположим, мы в программе строчка за строчкой выводим некий многострочный текст:

print("Я к вам пишу – чего же боле?")
print("Что я могу еще сказать?")
print("Теперь, я знаю, в вашей воле")
print("Меня презреньем наказать.")
print("Но вы, к моей несчастной доле")
print("Хоть каплю жалости храня,")
print("Вы не оставите меня.")

И где-нибудь в серединке, после третьего print(), запишем команду:

print(a)

Разумеется, в момент выполнения этой программы, возникнет ошибка, а точнее – исключение с типом:

NameError

Причем, первые три строчки будут выполнены, то есть, до момента исключения интерпретатор Python выполняет программу строчка за строчкой. Это пример исключения в момент выполнения программы. Причем, типы исключений могут быть самыми разными, в зависимости от возникшей ошибки. Например, если попробовать выполнить деление на ноль:

10/0

то отобразится тип исключения:

ZeroDivisionError

которое также относится к моменту выполнения программы, так как первые три строчки (до ошибки) были успешно выполнены.

Другой вариант ошибок, это, например, неверный синтаксис в программе. Если, допустим, прописать строчку:

if True
    print("True")

то увидим исключение типа:

SyntaxError

которое возникает в момент компиляции текста программы, поэтому, ни одной строчки не было отображено в консоли. То есть, исключения можно разбить на две группы:

  • исключения в момент исполнения;
  • исключения при компиляции (до исполнения кода).

И при обработке исключений нас будет интересовать первая группа – момента исполнения, так как именно из-за них исполнение программы может внезапно остановиться и, как вы понимаете, это не лучший сценарий развития.

На первый взгляд может показаться, что исключения возникают по вине программиста, из-за того, что он что-то не учел. Иногда такое бывает, но не всегда. Классический пример обработки исключений момента выполнения программы – открытие файлов на чтение или запись. Мы с вами уже об этом говорили, когда открывается файл:

file = open("myfile.txt")

то программист не может заранее знать, есть ли такой файл на диске или нет. Поэтому, такую строчку нужно выполнять в специальном блоке try с обработкой исключения типа FileNotFoundError:

try:
    file = open("myfile2.txt")
except FileNotFoundError:
    print("Невозможно открыть файл")

Или, при делении одного числа на другое:

try:
    x, y = map(int, input().split())
    res = x / y
except ZeroDivisionError:
    print("Делить на ноль нельзя!")

Здесь заранее нельзя сказать чему будет равно значение y, поэтому деление лучше поместить в блок try с обработкой исключения ZeroDivisionError. Кстати, здесь же может появиться и другое исключение ValueError, если мы введем с клавиатуры не целые числа, а, например, строки.

Чтобы отловить и это второе исключение, можно прописать еще один блок except:

try:
    x, y = map(int, input().split())
    res = x / y
except ZeroDivisionError:
    print("Делить на ноль нельзя!")
except ValueError:
    print("Ошибка типа данных")

И таких блоков except может быть сколько угодно.

Чтобы отловить в блоке except сразу несколько типов исключений, их можно указать в круглых скобках через запятую после ключевого слова except:

except (ZeroDivisionError, ValueError):
    res = "деление на ноль или нечисловое значение"

Но все же чаще используют раздельную запись, поэтому я ее верну.

Если мы хотим при возникновении ошибок взаимодействовать с объектами классов исключений, то это делается так:

try:
    x, y = map(int, input().split())
    res = x / y
except ZeroDivisionError as z:
    print(z)
except ValueError as z:
    print(z)

То есть, после имени исключения ставится ключевое слово as и дальше переменная, которая будет ссылаться на объект класса ValueError, в котором хранится служебная информация о конкретной ошибке.

Разумеется, так обрабатывать можно только исключения на этапе исполнения. Про синтаксические ошибки мы сейчас не говорим. Так вот, существует определенная иерархия классов исключений, во главе которой стоит базовый класс BaseException:

Иллюстрация к уроку

Здесь приведен лишь ее фрагмент. Самих классов гораздо больше. Из этого рисунка хорошо видно, что большая часть классов наследуется от базового класса Exception и именно эта ветка нас будет интересовать.

На что влияет эта иерархия и как ее можно использовать при обработке исключений? Например, мы видим обработку исключения деления на ноль, которое относится к базовому классу ArithmeticError, а он, в свою очередь, к базовому классу Exception. Поэтому, вместо указания конкретного типа ZeroDivisionError можно указать любой из этих базовых классов:

try:
    x, y = map(int, input().split())
    res = x / y
except ArithmeticError:
    print("Делить на ноль нельзя!")
except ValueError:
    print("Ошибка типа данных")

Но здесь есть один важный нюанс. Если вместо ArithmeticError прописать класс Exception – общий для классов ArithmeticError и ValueError, то первым блоком exception будут отлавливаться все типовые исключения. А блок с ValueError никогда выполнен не будет. Поэтому здесь есть одно простое правило. Сначала прописываются блоки со специализированными классами исключений, а затем с более общими (базовыми).

Если поменяем местами наши блоки except:

try:
    x, y = map(int, input().split())
    res = x / y
except ValueError:
    print("Ошибка типа данных")
except Exception:
    print("Делить на ноль нельзя!")

То ValueError будет отлавливать свой тип исключения, а второй блок – все остальные, унаследованные от класса Exception.

И последнее, что я хочу отметить про блок except. Его можно прописывать без указания каких-либо классов, следующим образом:

try:
    x, y = map(int, input().split())
    res = x / y
except:
    print("Ошибка")

В этом случае он будет отлавливать все исключения, возникающие в блоке try.

На этом завершим первое знакомство с исключениями. Здесь я вас лишь хотел познакомить с блоками try и except, а также показать на что влияет иерархия классов исключений при их отслеживании.

Урок 30 · Часть II. ООП на Python

Обработка исключений. Блоки finally и else

Источник: python-obrabotka-isklyucheniy-bloki-finally-i-else

Мы продолжаем тему исключений. На прошлом занятии мы с вами познакомились с основами работы блоков try / except, а также увидели, как правильно использовать иерархию классов исключений для их корректной обработки. Однако простой конструкции try / except часто бывает недостаточно для корректной обработки возникающих ошибок. Еще на практике дополнительно прописывают необязательные блоки else и finally. Давайте посмотрим, как они работают и для чего нужны.

Итак, блок try поддерживает необязательный блок else, который выполняется при штатном выполнении кода внутри блока try, то есть, когда не произошло никаких ошибок. Например, его можно записать так:

try:
    x, y = map(int, input().split())
    res = x / y
except ZeroDivisionError as z:
    print(z)
except ValueError as z:
    print(z) 
else:
    print("Исключений не произошло")

Теперь, при запуске программы, вводя корректные числа, мы увидим сообщение «Исключений не произошло». Если же возникает какое-либо исключение, то этот блок выполняться не будет.

Вторым необязательным блоком является блок finally, который, наоборот, выполняется всегда после блока try, вне зависимости произошла ошибка или нет:

finally:
    print("Блок finally выполняется всегда")

Теперь, при запуске программы, мы будем видеть это сообщение вне зависимости от возникновения возможных ошибок. И здесь часто возникает вопрос: зачем нужен этот блок, если он выполняется всегда после try? Мы с таким же успехом можем записать этот print сразу после этого блока и, вроде бы, все будет работать также? В действительности, нет. Смотрите, если мы, например, уберем блок except с исключением ValueError, запустим программу и введем нечисловые значения, то, конечно, возникнет необработанное исключение, но при этом, блок finally все равно выполнился! Этого не произошло бы, если просто записать print после try.

Но все же, в каких ситуация нам может понадобиться использовать блок finally? Классический пример – это работа с файлами. Вначале, для открытия файла, нам следует прописать функцию open() в блоке try:

try:
    f = open("myfile.txt")
    f.write("hello")
except FileNotFoundError as z:
    print(z)
except:
    print("Другая ошибка")

Здесь ошибка произойдет после открытия файла в строчке f.write(), поэтому файл остается открытым. Это нехорошо. Мы знаем, что любой файл нужно закрывать даже при возникновении ошибок. Как раз здесь может пригодиться блок finally:

try:
    f = open("myfile.txt")
    f.write("hello")
except FileNotFoundError as z:
    print(z)
except:
    print("Другая ошибка")
finally:
    if f:
        f.close()
        print("Файл закрыт")

Запустим программу и увидим, что файл закрывается (даже если убрать второй блок except).

Конечно, конкретно при работе с файлами такую громоздкую конструкцию заменяют более компактной с использованием файлового менеджера:

try:
    with open("myfile.txt") as f:
        f.write("hello")
except FileNotFoundError as z:
    print(z)
except:
    print("Другая ошибка")

Который автоматически закрывает файл. Я привел первый вариант исключительно в учебных целях, чтобы вы увидели для чего в принципе можно использовать блок finally.

Следующая особенность работы блока finally связана с обработкой исключений внутри функций. Предположим, в функции вводятся два целых числа и возвращаются в виде кортежа:

def get_values():
    try:
        x, y = map(int, input().split())
        return x, y
    except ValueError as v:
        print(v)
        return 0, 0
    finally:
        print("finally выполняется до return")
 
 
x, y = get_values()
print(x, y)

Здесь может возникнуть исключение ValueError, если были введены не целые числа. В этом случае возвращаются нули. Также прописан блок finally с выводом сообщения «finally выполняется до return», чтобы мы убедились, что этот блок действительно выполняется до оператора return.

Запускаем программу, вводим два значения и вне зависимости от ошибок срабатывает блок finally до оператора return. Вот этот момент также нужно знать при реализации этого блока.

Вложенные блоки try / except

Наконец, блоки try / except можно вкладывать один в другой, например, так:

try:
    x, y = map(int, input().split())
    try:
        res = x / y
    except ZeroDivisionError:
        print("Деление на ноль")
except ValueError as z:
    print("Ошибка ValueError")

Или, можно внутренний блок try вынести в функцию:

def div(a, b):
    try:
        return x / y
    except ZeroDivisionError:
        return "Деление на ноль"

А, затем, вызвать в первом блоке try:

try:
    x, y = map(int, input().split())
    res = div(x, y)
except ValueError as z:
    print("Ошибка ValueError")
 
 
print(res)

Все эти комбинации, конечно же, допустимы и используются на практике. На следующем занятии мы продолжим эту тему и детальнее рассмотрим механизм возникновения и обработки исключений.

Урок 31 · Часть II. ООП на Python

Распространение исключений (propagation exceptions)

Источник: python-rasprostranenie-isklyucheniy-propagation-exceptions

На предыдущих занятиях мы с вами в целом рассмотрели работу блоков try / except / finally / else на примере относительно простых программ. В реальности, программы куда сложнее, содержат вызовы различных функций и даже могут использовать многопоточную реализацию. Давайте посмотрим, как будут выглядеть сообщения об ошибках при использовании функций.

Для этого объявим вначале функцию:

def func1():
    return 1/0

и вызовем ее также после третьего print():

print("Я к вам пишу – чего же боле?")
print("Что я могу еще сказать?")
print("Теперь, я знаю, в вашей воле")
func1()
print("Меня презреньем наказать.")
print("Но вы, к моей несчастной доле")
print("Хоть каплю жалости храня,")
print("Вы не оставите меня.")

При попытке выполнить эту программу, Python выдаст следующие строчки:

Traceback (most recent call last):
File “D:/Python/Projects/p_course/ex1.py”, line 7, in 
func1()
File “D:/Python/Projects/p_course/ex1.py”, line 2, in func1
return 1/0
ZeroDivisionError: division by zero

Что примечательного в этом сообщении? Мы здесь видим указание об ошибке типа ZeroDivisionError для строчки 2 и строчки 7. В строчке 7 происходит вызов функции, которая выдает исключение, а в строчке 2 записано непосредственное деление на ноль. Почему строчки отображаются именно в таком порядке? Здесь нам нужно вспомнить, что при вызове функций формируется стек их вызова. И в нашем случае, этот стек можно представить, следующим образом:

Иллюстрация к уроку

Далее, возникшее исключение на уровне func1, последовательно распространяется по всему стеку вызова, доходя до верхнего уровня main. Именно этот стек распространения исключения и выдает интерпретатор языка Python.

Если, к примеру, добавить в программу еще один вложенный вызов функции:

def func2():
    return 1/0
 
def func1():
    return func2()

То в консоли появятся уже три строчки об ошибке, так как стек вызова стал длиннее:

Traceback (most recent call last):
File “D:/Python/Projects/p_course/ex1.py”, line 10, in 
func1()
File “D:/Python/Projects/p_course/ex1.py”, line 5, in func1
return func2()
File “D:/Python/Projects/p_course/ex1.py”, line 2, in func2
return 1/0
ZeroDivisionError: division by zero

Все это пример того, как исключение, зародившееся на одном из уровней стека вызова, постепенно поднимается на самый верх. Это называется распространением исключений. По-английски:

propagation exceptions

Причем, обработать (перехватывать) исключение можно на любом уровне этого стека. Например, сделаем это на самом верхнем. Поместим вызов функции в блок try/except:

try:
    func1()
except:
    print("Error for func1")

Теперь, все исключения для func1, которые дойдут до верхнего уровня, будут обработаны и программа выполнится в полном объеме.

Но, мы также можем обрабатывать исключения и на более глубоких уровнях, например, непосредственно в функции func2() при выполнении деления на ноль:

def func2():
    try:
        return 1/0
    except:
        return "-- деление на ноль --"

А на вершине стека, в глобальной области, просто вызовем функцию func1:

print("Я к вам пишу – чего же боле?")
print("Что я могу еще сказать?")
print("Теперь, я знаю, в вашей воле")
print(func1())
print("Меня презреньем наказать.")
print("Но вы, к моей несчастной доле")
print("Хоть каплю жалости храня,")
print("Вы не оставите меня.")

При выполнении программы также не будет возникать никаких ошибок, так как деление на ноль обрабатывается непосредственно в функции func2 и исключение уже не всплывает на более высокие уровни.

То есть, мы можем обрабатывать исключения на разных уровнях стека вызова, что очень удобно. Этот механизм обработки исключений позволяет программистам писать независимый, модульный, красивый код. В критических функциях достаточно генерировать исключения, а их обработку выполнять на другом, более глобальном уровне. Например, создается класс для печати данных на принтере. Тогда все ошибки, связанные с принтером (нет бумаги, нет подключения, не тот режим печати и т.п.) можно обрабатывать единым образом на верхнем, глобальном уровне. А нижние уровни только сигнализируют о проблемах и не более того. В результате, получается разделение ролей: функции нижних уровней сосредоточены исключительно на обработке данных, а функции верхних – на формировании сервисной информации для пользователя.

Иллюстрация к уроку

Вот так, благодаря механизму распространения и обработки исключений можно создавать гибкий и безопасный программный код.

Урок 32 · Часть II. ООП на Python

Инструкция raise и пользовательские исключения

Источник: python-instrukciya-raise-i-polzovatelskie-isklyucheniya

Мы продолжаем тему исключений. Во всех наших предыдущих примерах исключение возникало в результате ошибочных ситуаций во время работы программы, например, деления на ноль:

print("Куда ты скачешь, гордый конь,")
print("И где опустишь ты копыта?")
print("О мощный властелин судьбы!")
1/0
print("Не так ли ты над самой бездной")
print("На высоте, уздой железной")
print("Россию поднял на дыбы?")

Но как эта операция деления формирует само исключение? Для этого в языке Python имеется конструкция (оператор)

raise

которая и порождает указанные типы исключений. В самом простом варианте, мы можем вместо деления на ноль записать этот оператор и указать тип исключения ZeroDivisionError:

raise ZeroDivisionError("Деление на ноль")

Результат выполнения программы будет тем же – она остановится на конструкции raise. Только сообщение об ошибке теперь будет на русском языке – та строка, что мы указали при формировании объекта класса ZeroDivisionError. То есть, после оператора raise мы можем прописывать нужный нам класс исключения с собственными параметрами. Также можно просто указывать класс, не прописывая каких-либо параметров:

raise ZeroDivisionError

Здесь у нас также создается экземпляр, но без параметров. Раз это так, значит, можно заранее создать экземпляр класса:

e = ZeroDivisionError("Деление на ноль")

а, затем, сгенерировать это исключение:

raise e

Вообще, мы можем использовать любой класс в качестве исключения, унаследованного от базового класса:

BaseException

Например, если просто указать строку после оператора raise:

raise "деление на ноль"

то интерпретатор Python как раз это нам и укажет:

TypeError: exceptions must derive from BaseException

То есть, после raise должен находиться экземпляр класса исключения, а не какой-то произвольный объект.

Когда нам может понадобиться оператор raise? И разве сам язык Python не может генерировать нужные исключения при возникновении ошибок? Часто именно так и происходит. Например, если мы будем делать некорректные операции, вроде:

1 + "2"
[1, 2, 3][4]

то автоматически возникают ошибки заданного типа. Но прописать исключения на все случаи жизни невозможно. И если в качестве примера взять все тот же класс печати данных:

Иллюстрация к уроку

То, в частности, метод send_data() может генерировать свое исключение, если по каким-то причинам данные не были отправлены принтеру. В качестве демонстрации я приведу гипотетический класс PrintData для работы с принтером:

class PrintData:
    def print(self, data):
        self.send_data(data)
        print(f"печать: {str(data)}")
 
    def send_data(self, data):
        if not self.send_to_print(data):
            raise Exception("принтер не отвечает")
 
    def send_to_print(self, data):
        return False

Как раз здесь мы генерируем исключение, если данные не могут быть отправлены принтеру. Затем, это исключение может быть обработано на любом уровне стека вызова. Например, если далее создать экземпляр этого класса и вызвать метод print():

p = PrintData()
p.print("123")

То мы увидим сформированное нами исключение. Как вы понимаете, в язык Python не встроена по умолчанию возможность генерации исключения при взаимодействии с принтером. Это приходится делать уже самому программисту с помощью оператора raise. Вот для этого он и нужен.

Создание пользовательских исключений

В нашем гипотетическом классе PrintData исключение генерируется с помощью класса Exception. Почему именно он? Если мы посмотрим на иерархию классов исключений языка Python, то здесь во главе стоит базовый класс BaseException:

Иллюстрация к уроку

Остальные классы наследуются от него и имеют строгую специализацию, кроме, разве что, класса Exception, который является общим для большого разнообразия типов исключений в момент выполнения программы. Так почему же мы выбрали класс Exception, а не BaseException? Дело в том, что классы SystemExit, GeneratorExit и KeyboardInterrupt являются весьма специфичными и, обычно, они не используются при обработке собственных исключений. Поэтому, целесообразно выбирать именно класс Exception для формирования новых собственных классов исключений. Что мы сейчас и сделаем.

Итак, чтобы сформировать свой новый тип исключения, нужно прописать класс, который рекомендуется наследовать от класса Exception. В самом простом варианте достаточно просто описать иерархию:

class ExceptionPrintSendData(Exception):
    """Класс исключения при отправке данных принтеру"""

И далее в программе использовать этот новый класс:

    def send_data(self, data):
        if not self.send_to_print(data):
            raise ExceptionPrintSendData("принтер не отвечает")

Соответственно, ниже в программе, мы можем обработать этот тип ошибки, просто указав имя нашего нового класса:

p = PrintData()
 
try:
    p.print("123")
except ExceptionPrintSendData:
    print("Ошибка печати")

Видите, как это здорово! Мы создали новый тип исключения, просто прописав новый класс. И благодаря этому можем отличить ошибку передачи данных принтеру от каких-либо других ошибок.

Разумеется, мы поймаем эту же ошибку, если укажем базовый класс Exception, но пропустим, если указать какой-либо другой независимый класс исключения, иерархически не связанный с нашим, например, ArithmeticError.

Кроме того, мы можем расширить функционал класса ExceptionPrintSendData. Давайте добавим в него конструктор. Он прописывается для произвольного числа аргументов:

class ExceptionPrintSendData(Exception):
    """Класс исключения при отправке данных принтеру"""
    def __init__(self, *args):
        self.message = args[0] if args else None

А также магически метод__str__ для представления ошибки в консоли:

    def __str__(self):
        return f"Ошибка: {self.message}"

Если теперь убрать блок try/except и вызвать метод print(), то увидим наш вариант отображения ошибки в консоли:

p = PrintData()
p.print("123")

Это лишь пример расширения функционала класса исключения. В каждом конкретном случае программист может написать любую свою реализацию.

Наконец, пользовательские классы исключений дают возможность создавать свою иерархию исключений. В частности, в нашем примере, можно прописать общий класс исключений для принтера ExceptionPrint:

class ExceptionPrint(Exception):
    """Общий класс исключения принтера"""

А, затем, остальные, более конкретные типы наследовать от него:

class ExceptionPrintSendData(ExceptionPrint):
    """Класс исключения при отправке данных принтеру"""

В результате, в блоке except мы можем отлавливать как конкретные типы ошибок, так и общие, связанные с принтером:

p = PrintData()
 
try:
    p.print("123")
except ExceptionPrintSendData as e:
    print(e)
except ExceptionPrint:
    print("Ошибка печати")

Такой подход дает гибкий механизм обработки собственных типов исключений, благодаря чему, программа становится более понятной и структурированной.

Практика 7 · Часть II. ООП на Python

Исключения

Задания для закрепления темы · решений нет

Цели обучения

  • Обрабатывать ожидаемые сбои через try / except / else / finally
  • Сознательно распространять или преобразовывать исключения
  • Спроектировать небольшую иерархию пользовательских исключений

Задания

Задание 1. Безопасное деление

Сложность: лёгкое

Реализуйте safe_div(a, b) -> float | None.

Требования:

  • При успехе возвращайте a / b
  • При ZeroDivisionError возвращайте None
  • При нечисловых операндах ловите TypeError и возвращайте None

Пример:

assert safe_div(10, 2) == 5
assert safe_div(1, 0) is None

Задание 2. Разбор с else/finally

Сложность: лёгкое

Реализуйте parse_int_line(text: str) -> tuple[int | None, list[str]].

Требования:

  • Попробуйте int(text.strip())
  • При успехе (else): добавьте "ok" в список лога
  • При ValueError: добавьте "bad" и верните (None, log)
  • Всегда (finally): добавьте "done" в лог
  • Верните (value, log), где value — int или None

Пример:

v, log = parse_int_line(" 42 ")
assert v == 42 and log == ["ok", "done"]

Задание 3. Цепочка распространения

Сложность: среднее

Три функции: read_config(path), load_app(path), main(path).

Требования:

  • read_config открывает файл и естественно возбуждает FileNotFoundError, если файла нет
  • load_app вызывает read_config; не перехватывает — даёт распространиться
  • main ловит FileNotFoundError и возвращает строку "missing config"
  • Для существующего пути с содержимым x=1 main возвращает "ok"

Задание 4. Иерархия пользовательских исключений

Сложность: среднее

Определите:

Требования:

  • Базовый AppError(Exception)
  • ValidationError(AppError) с атрибутами field: str, message: str
  • NotFoundError(AppError) с entity: str, key: object
  • Функция get_user(users: dict, user_id) возбуждает NotFoundError, если ключа нет
  • Функция require_email(email: str) возбуждает ValidationError, если "@" not in email

Пример:

try:
    require_email("bad")
except ValidationError as e:
    assert e.field == "email"

Задание 5. Повторное возбуждение и обёртка

Сложность: среднее

Реализуйте run_pipeline(steps: list[callable]).

Требования:

  • Вызывайте каждый шаг по порядку без аргументов
  • При исключении возбуждайте AppError(f"step {i} failed") от исходного (raise ... from err)
  • Если все успешны, возвращайте "done"

Задание 6. Мини-проект: банк с доменными исключениями

Сложность: сложное

Соберите небольшой банковский API вокруг исключений.

Требования:

  • Исключения: BankError, InsufficientFunds(BankError), InvalidAmount(BankError), AccountClosed(BankError)
  • Класс Account(id: str, balance: float = 0) с open: bool = True
  • Методы:

- deposit(amount) — amount > 0, иначе InvalidAmount; если закрыт → AccountClosed

- withdraw(amount) — те же правила суммы; если amount > balance → InsufficientFunds

- close() — устанавливает open=False; дальнейшие денежные операции падают

  • Класс Bank с accounts: dict[str, Account]

- transfer(src_id, dst_id, amount) — атомарно с точки зрения вызывающего: если deposit на назначение падает после withdraw, задокументируйте восстановление (простой подход: withdraw, затем deposit; при сбое вернуть deposit обратно / возбудить обёрнутый BankError)

  • Демо try/except с печатью имён типов исключений хотя бы для трёх режимов сбоя

Пример:

a = Account("1", 100)
try:
    a.withdraw(150)
except InsufficientFunds:
    pass

Глава 8

Контекстные менеджеры и вложенные классы

Урок 33 · Часть II. ООП на Python

Менеджеры контекстов. Оператор with

Источник: python-menedzhery-kontekstov-operator-with

На этом занятии речь пойдет о, так называемых, менеджерах контекста. С менеджером контекста мы с вами уже сталкивались, когда рассматривали работу с файлами. Дело в том, что когда открываем файловый поток с помощью функции open(), то в конце работы с ним, его желательно закрыть с помощью метода close(). Если реализовать эту логику через конструкцию try/except/finally, то получим примерно вот такой текст программы:

fp = None
try:
    fp = open("myfile.txt")
    for t in fp:
        print(t)
except Exception as e:
    print(e)
finally:
    if fp is not None:
        fp.close()

Благодаря блоку finally мы гарантированно закрываем файл, даже если в блоке try возникло какое-либо исключение. Но, если воспользоваться файловым менеджером контекста, то программа принимает вид:

try:
    with open("myfile.txt") as fp:
        for t in fp:
            print(t)
except Exception as e:
    print(e)

Видите, она фактически отличается от первой только тем, что не реализует блок finally. Но почему? Нам же нужно закрыть файл после работы с ним? Да, и файловый менеджер контекста делает это автоматически вне зависимости от возникновения возможных исключений. Как же в деталях это происходит? Для этого мы вначале посмотрим, как вообще создаются свои собственные менеджеры контекстов.

В целом менеджер контекста – это класс, в котором реализованы два магических метода:

enter() и exit()

Когда происходит создание менеджера контекста с помощью оператора with, то автоматически вызывается метод класса enter. А когда менеджер контекста завершает свою работу (программа внутри него выполнилась или произошло исключение), то вызывается метод exit. Как видите, все предельно просто. И, как вы догадались, в файловом менеджере происходит закрытие файлового потока именно в методе exit.

Далее, общий синтаксис вызова менеджера, следующий:

with <менеджер контекста> as <переменная>:
список конструкций языка Python

Здесь «переменная» - это ссылка на экземпляр менеджера контекста, через которую, мы потом с ним можем работать. При необходимости ее можно опустить и записать все вот в таком виде:

with <менеджер контекста>:
список конструкций языка Python

Но тогда мы не сможем обратиться к объекту менеджера контекста.

Давайте создадим свой класс менеджера, который бы контролировал работу при изменении списка: если программа в теле менеджера приводит к исключению (ошибке), то список должен оставаться прежним (без изменений):

v1 = [1, 2, 3]
v2 = [1, 2]
with DefenerVector(v1) as dv:
    for i, a in enumerate(dv):
        dv[i] += v2[i]
 
print(v1)

А класс DefenderVector менеджера контекста будет выглядеть так:

class DefenerVector:
    def __init__(self, v):
        self.__v = v
 
    def __enter__(self):
        self.__temp = self.__v[:]  # делаем копию вектора v
        return self.__temp
 
    def __exit__(self, exc_type, exc_val, exc_tb):
        if exc_type is None:
            self.__v[:] = self.__temp
        return False

Мы здесь в приватном свойстве сохраняем ссылку на вектор, который следует «защитить». Далее, в методе enter создаем копию этого вектора и возвращаем его. То есть, переменная dv будет ссылаться на эту копию и обработка внутри менеджера будет происходить с элементами этой копии, а не исходным вектором. Затем, в методе exit мы проверяем: если исключений не произошло, то заменяем все элементы вектора __v на преобразованные __temp. В результате, при выходе из менеджера, мы получим измененный вектор v1. Если же было какое-либо исключение, то запись новых данных выполняться не будет и у нас останется прежний вектор v1.

Метод exit у нас возвращает значение False, что означает обработку исключения (если оно произошло) вышестоящим блоком. Обычно именно так и делают, чтобы не скрывать возможные ошибки и в обработчике верхнего уровня реагировать должным образом на ошибочные ситуации. Кстати, оператор return можно вовсе опустить, тогда метод exit возвратит None, а оно интерпретируется как False. Так что, часто его не пишут.

Давайте для примера возвратим значение True и смотрите, при возникновении исключения, оно было перехвачено менеджером и далее уже не распространялось. Снова вернем False, запустим и теперь видим это исключение снова.

Вложенные менеджеры контекстов

При необходимости, менеджеры контекстов можно вкладывать друг в друга. Например, при работе с файлами, можно выполнить такое вложение:

try:
    with open("myfile.txt") as fin:
        with open("out.txt", "w") as fout:
            for line in fin:
                fout.write(line)
except Exception as e:
    print(e)

Работает все очевидным образом. Сначала завершается (отрабатывает) вложенный менеджер, а затем, внешний (первый). Во всем остальном логика работы такого вложения сохраняется.

Думаю, теперь вы лучше узнали, что такое менеджеры контекста и зачем они нужны, а также сможете создавать свои менеджеры, если в этом возникнет необходимость.

Урок 34 · Часть II. ООП на Python

Вложенные классы

Источник: python-vlozhennye-klassy

На этом занятии речь пойдет о вложенных классах. В двух словах, это когда один класс объявлен внутри другого. Да, в Python так тоже можно делать. И здесь сразу возникает два главных вопроса: как это работает и зачем это надо? Я попробую дать ответ сразу на оба этих вопроса.

На мой взгляд, хороший пример использования вложенных классов – это описание моделей во фреймворке Django. Если вы не знаете, что это такое, то не беспокойтесь, нам нужна будет только суть вложений. Итак, там часто можно встретить определения вида:

class Women:
    title = 'объект класса для поля title'
    photo = 'объект класса для поля photo'
 
    class Meta:
        ordering = ['id']

Здесь объявляется некий класс Women, далее прописаны два атрибута, которые в Django являются ссылками на определенные классы, но в нашем примере – это просто строки. Причем, атрибуты title и photo – это поля в таблице БД, с которой впоследствии идет работа, то есть, полагаем, что нам важно называть эти атрибуты именно такими именами. Затем, идет объявление вложенного класса Meta с одним атрибутом ordering. В Django с помощью такого класса Meta определяют некие вспомогательные параметры. В частности, параметр ordering определяет сортировку по полю id записей в таблице БД. Если вы ничего не поняли про записи и таблицы, то это не важно. Главное сейчас, что у нас есть класс Women, в нем атрибуты со строго определенными именами и вложенный класс Meta с одним атрибутом ordering. Это все, что нужно сейчас знать.

Иллюстрация к уроку

Но все же, зачем нужен такой вложенный класс? Почему бы этот атрибут не прописать непосредственно в классе Women? Давайте предположим, что в нашей таблице есть поле с именем ordering и для работы с ним в классе Women его следует прописать, сделаем это так:

class Women:
    title = 'объект класса для поля title'
    photo = 'объект класса для поля photo'
    ordering = 'объект класса для поля ordering'
 
    class Meta:
        ordering = ['id']

Видите, если бы не было вложенного класса Meta, то возникла бы проблема с использованием одного и того же атрибута ordering для разных целей: и для представления данных поля ordering и для управления сортировкой. Вложенный класс Meta, фактически, создает независимое пространство имен для разрешения подобных конфликтов.

Иллюстрация к уроку

Разумеется, мы можем совершенно спокойно обращаться ко всем атрибутам класса через основной класс Women, например, так:

print(Women.ordering)
print(Women.Meta.ordering)

В первом случае берем атрибут ordering непосредственно из класса Women, а во втором – из класса Meta.

То же самое можно делать и через экземпляры класса Women:

w = Women()
print(w.ordering)
print(w.Meta.ordering)

Причем внутри самого объекта у нас сейчас не будет никаких локальных свойств:

print(w.__dict__)

Давайте для примера добавим инициализатор в класс Women, запишем его следующим образом:

class Women:
    title = 'объект класса для поля title'
    photo = 'объект класса для поля photo'
    ordering = 'объект класса для поля ordering'
 
    def __init__(self, user, psw):
        self._user = user
        self._psw = psw
 
    class Meta:
        ordering = ['id']

Теперь, при создании объектов:

w = Women('root', '12345')
print(w.__dict__)

в них дополнительно будут создаваться локальные свойства user и psw:

{‘_user’: ‘root’, ‘_psw’: ‘12345’}

Иллюстрация к уроку

Но обратите внимание, объект класса Meta при этом не создается. Здесь Meta – это, по сути, еще один атрибут (пространство имен) в классе Women и мы к нему обращаемся через w как к атрибуту класса, не более того. Если нам нужен объект класса Meta, его нужно явно создать в инициализаторе класса Women:

    def __init__(self, user, psw):
        self._user = user
        self._psw = psw
        self.meta = self.Meta()

Теперь в экземпляре класса Women имеется ссылка meta на объект класса Meta. Чтобы в этой операции был смысл, давайте пропишем инициализатор во вложенном классе:

class Women:
    title = 'объект класса для поля title'
    photo = 'объект класса для поля photo'
    ordering = 'объект класса для поля ordering'
 
    def __init__(self, user, psw):
        self._user = user
        self._psw = psw
        self.meta = self.Meta(user + '@' + psw)
 
    class Meta:
        ordering = ['id']
 
        def __init__(self, access):
            self._access = access

Теперь, при создании объекта класса Women будут автоматически создаваться два объекта: класса Women и класса Meta с соответствующими локальными свойствами:

w = Women('root', '12345')
print(w.__dict__)
print(w.meta.__dict__)

И, обратите внимание, мы не можем из класса Meta или из его объектов обращаться к атрибутам класса Women. Это совершенно изолированное пространство имен от внешнего класса. Например, запись вида:

    class Meta:
        ordering = ['id']
        t = Meta.title      # ошибка при обращении к атрибуту title класса Women

приведет к ошибке, так как у вложенного пространства имен класса нет ссылки на внешнее пространство имен класса Women. Мало того, непосредственно во вложенном классе мы даже не можем явно указывать класс Women:

    class Meta:
        ordering = ['id']
        t = Women.title      # ошибка при обращении к атрибуту title класса Women

то тоже приведет к ошибке, так как пространство имен Women на данный момент еще не создано. А вот обращаться к пространству имен Women внутри инициализатора класса Meta можно:

    class Meta:
        ordering = ['id']
 
        def __init__(self, access):
            self._access = access
            self._t = Women.title

Но, обычно, вложенные классы содержат изолированный код, который доступен только из внешнего класса. Именно так следует проектировать программы при использовании вложенных классов.

В заключение занятия отмечу, что подобные вложения служат исключительно для удобства программирования. Какого-то особого, сакрального смысла во вложенных классах нет и все что можно делать через вложения, также можно реализовать и без них, используя обычные, независимые объявления. Но вы вполне можете столкнуться с ними в других проектах, в частности, как я отмечал вначале, во фреймворке Django. И чтобы это не вызывало у удивления, я решил привести пример работы этой конструкции. Надеюсь, вы теперь хорошо себе представляете, как работают вложенные классы.

Практика 8 · Часть II. ООП на Python

Контекстные менеджеры и вложенные классы

Задания для закрепления темы · решений нет

Цели обучения

  • Корректно реализовывать __enter__ / __exit__ (включая подавление исключений)
  • Вкладывать вспомогательные классы для связности, не засоряя пространство имён модуля

Задания

Задание 1. Контекст Timer

Сложность: лёгкое

Реализуйте контекстный менеджер Timer.

Требования:

  • __enter__ запоминает время старта и возвращает self
  • Атрибут elapsed доступен после выхода (секунды, float)
  • __exit__ всегда возвращает False (не подавлять)

Пример:

with Timer() as t:
    sum(range(10000))
assert t.elapsed >= 0

Задание 2. Подавление выбранных ошибок

Сложность: среднее

Реализуйте suppress(*exc_types).

Требования:

  • Контекстный менеджер, подавляющий исключения, чей тип входит в exc_types
  • Остальные исключения распространяются
  • Имитируйте минимальное подмножество поведения contextlib.suppress

Пример:

with suppress(ZeroDivisionError):
    1 / 0
# no exception

Задание 3. Временный атрибут

Сложность: среднее

Реализуйте temp_attr(obj, name, value).

Требования:

  • При входе: сохраните старое значение, если есть; установите name в value
  • При выходе: восстановите старое значение или удалите атрибут, если его не было
  • Работает даже если тело возбуждает исключение (всё равно восстановить)

Пример:

class A:
    x = 1

a = A()
with temp_attr(a, "x", 99):
    assert a.x == 99
assert a.x == 1

Задание 4. Вложенный Node для дерева

Сложность: среднее

Реализуйте внешний класс Tree со вложенным Node.

Требования:

  • Tree.Node(value) с children: list[Tree.Node]
  • Tree хранит root: Tree.Node | None
  • Методы на Tree: add_child(parent, value), walk(), выдающий значения DFS
  • На вложенный класс ссылайтесь как Tree.Node

Пример:

t = Tree()
t.root = Tree.Node("root")
t.add_child(t.root, "a")
assert list(t.walk())[0] == "root"

Задание 5. Connection со вложенным Cursor

Сложность: среднее

Смоделируйте DB-подобный API.

Требования:

  • Внешний Connection(name: str) с closed: bool = False и вложенным Cursor
  • Connection.cursor(self) -> Connection.Cursor
  • Cursor.execute(self, sql: str) добавляет sql в connection.queries: list[str]; возбуждает RuntimeError, если соединение закрыто
  • Connection — контекстный менеджер: при выходе closed=True
  • Использование курсора после закрытия падает

Пример:

with Connection("db") as conn:
    cur = conn.cursor()
    cur.execute("select 1")
assert conn.closed and conn.queries == ["select 1"]

Задание 6. Мини-проект: транзакционный список

Сложность: сложное

Реализуйте TransactionalList как контекстный менеджер вокруг list.

Требования:

  • Хранит data: list
  • with lst.transaction(): — при входе снимок поверхностной копии data
  • Тело может мутировать lst.data
  • Если тело завершилось нормально — сохранить изменения
  • Если тело возбудило — восстановить снимок и не подавлять исключение
  • Предпочтителен вложенный класс Transaction, реализующий протокол контекста
  • Для сложного режима: вложенные транзакции (стек снимков)

Пример:

tl = TransactionalList([1, 2])
try:
    with tl.transaction():
        tl.data.append(3)
        raise ValueError
except ValueError:
    pass
assert tl.data == [1, 2]

Глава 9

Метаклассы

Урок 35 · Часть II. ООП на Python

Метаклассы. Объект type

Источник: python-metaklassy-obekt-type

На этом занятии мы затронем тему метаклассов. Давайте вначале разберемся, что стоит за этим умным словом. Как я уже не раз говорил на наших занятиях, булевы значения, строки, числа, списки, словари и т.п. все это объекты в языке Python. И эти объекты образованы от соответствующих классов (типов данных): bool, str, int, float, list, dict, функции и т.д. Но эти классы также являются и объектами, потому что все в Python – это объекты, даже классы. Да, классы – это объекты, которые позволяют создавать другие объекты с конкретным содержимым. А раз классы – это объекты, то должно быть нечто, что создает и их. И это нечто в Python называется метаклассом. Причем, метакласс – это тоже объект (в Python все объекты). Но это объект особого рода, который нельзя динамически порождать каким-нибудь другим мета-метаклассом. Он является вершиной, отправной точкой для создания обычных классов и, как следствие, их объектов.

Но что является метаклассом в языке Python? Наверное, вас немного удивит, но это давно знакомый вам объект type, который мы использовали для определения типов объектов. Но это, если он вызывается с одним аргументом. Если ему передать три аргумента:

type(<имя класса>, <кортеж родительских классов>, <словарь с атрибутами и их значениями>)

то данный объект начинает работать совершенно по-другому, а именно, создает (динамически) новый класс, новый тип данных в программе.

В действительности, все стандартные типы данных, функции и обычные классы – порождены метаклассом type. В этом легко убедиться, если вызвать функцию type (я ее так называю для удобства) от встроенных типов данных:

type(int)
type(bool)

или классов:

class A: pass
type(A)

Всюду увидим

<class ‘type’>

Это, как раз и говорит, что все эти объекты сформированы метаклассом type.

Наверное, на этом этапе у вас в голове крутится вопрос: зачем все это надо? Мы же и так можем объявлять классы. Для чего их создавать динамически в процессе работы программы? На этот вопрос хорошо ответил гуру Питона Тим Питерс. Он сказал:

Метаклассы – это глубокая магия, о которой 99% пользователей даже не нужно задумываться. Если вы думаете, нужно ли вам их использовать — вам не нужно (люди, которым они реально нужны, точно знают, зачем они им, и не нуждаются в объяснениях, почему).

Но, на мой взгляд, чтобы лучше понимать, как функционирует язык Python, все же лучше ознакомиться с этой темой. И, кроме того, кто знает, возможно в будущем именно вам это и пригодится.

Итак, давайте теперь попробуем создать свой класс с помощью метакласса type. Для простоты сделаем определение класса точки на плоскости:

class Point:
    MAX_COORD = 100
    MIN_COORD = 0

Через объект type это будет выглядеть так:

A = type('Point', (), {'MAX_COORD': 100, 'MIN_COORD': 0})

Здесь переменная A – ссылка на новый созданный класс с именем Point. Да, так как классы – это тоже объекты, то мы можем на них ссылаться через разные переменные. И, далее, можно создать экземпляр этого класса, используя переменную A:

pt = A()

Вот мы с вами только что динамически в программе сформировали новый класс через метакласс type и увидели, что новый класс корректно работает – создает свои экземпляры.

При необходимости, можно дополнительно прописывать базовые классы, передавая их список вторым аргументом метаклассу type. Например, пусть имеются два класса:

class B1: pass
class B2: pass

И, далее, мы можем их указать в качестве базовых при создании нового класса:

A = type('Point', (B1, B2), {'MAX_COORD': 100, 'MIN_COORD': 0})

Если теперь вывести коллекцию mro класса A:

A.__mro__

то увидим всю цепочку наследования:

(<class ‘main.Point’>, <class ‘main.B1’>, <class ‘main.B2’>, <class ‘object’>)

Также, при динамическом создании новых классов, в них можно определять и методы. Сделать это можно, по крайней мере, двумя способами. В первом использовать уже существующую функцию, например:

def method1(self):
    print(self.__dict__)

и указать ссылку на нее при создании атрибутов класса:

A = type('Point', (), {'method1': method1})

Создадим экземпляр класса Point и вызовем этот метод:

pt = A()
pt.method1()

Как видите, все работает. Во втором способе мы можем определить метод непосредственно в словаре через лямбда-функцию:

A = type('Point', (), {'MAX_COORD': 100, 'method1': lambda self: self.MAX_COORD})
pt = A()
pt.method1()

Но так можно определять только простейшие методы. Функции со сложным поведением придется задавать отдельно, а затем, добавлять в качестве методов в создаваемый класс.

Я, думаю, вы теперь представляете, что такое метакласс и как можно динамически создавать новые классы в программе с помощью объекта type. Однако, описывать сложный алгоритм формирования новых классов непосредственно через объект type не очень удобно. Мы видели, что даже добавление новых методов происходит несколько непривычно и как-то «коряво». Благо, выход есть. В Python мы можем конструировать свои собственные метаклассы, которые, конечно, явно или неявно образуются от объекта type. Но об этом мы поговорим уже на следующем занятии.

Урок 36 · Часть II. ООП на Python

Пользовательские метаклассы. Параметр metaclass

Источник: python-polzovatelskie-metaklassy-parametr-metaclass

В Python можно описывать свои собственные метаклассы, которые, конечно же, явно или неявно наследуются от основного метакласса type.

Давайте предположим, что мы бы хотели создавать классы для точек, в которых бы автоматически появлялись атрибуты MAX_COORD и MIN_COORD. Для этого мы создадим метакласс в виде функции (да, обычные функции тоже можно использовать как метаклассы):

def create_class_point(name, base, attrs):
    attrs.update({'MAX_COORD': 100, 'MIN_COORD': 0})
    return type(name, base, attrs)

Обратите внимание, функция-метакласс должна иметь три параметра: name – имя создаваемого класса; base – кортеж из базовых классов; attrs – словарь с атрибутами класса.

Сейчас в этой функции мы в словарь attrs просто добавляем два атрибута MAX_COORD и MIN_COORD, а затем, явным вызовом метакласса type формируем новый класс и возвращаем его.

Теперь, чтобы эта функция использовалась в качестве метакласса, при объявлении класса нужно прописать специальный параметр metaclass и передать ссылку на эту функцию:

class Point(metaclass=create_class_point):
    def get_coords(self):
        return (0, 0)

Создадим объект этого класса, обратимся к атрибуту MAX_COORD и вызовем метод get_coords:

pt = Point()
print(pt.MAX_COORD)
print(pt.get_coords())

Как видите, все сработало, как мы и ожидали. В нашем классе автоматически появились атрибуты MAX_COORD и MIN_COORD, а также явно, привычным образом, прописали метод get_coords, что намного удобнее.

Фактически, здесь класс был создан в функции create_class_point, в которую сам язык Python передал нужный набор аргументов с соответствующими значениями, а далее, с помощью вызова объекта type был создан этот класс. Такой подход намного удобнее, чем прописывать все атрибуты непосредственно в словаре attrs.

Однако, использование функции в качестве метакласса – это, скорее, учебный пример для лучшего понимания сущности метаклассов. Все же, на практике чаще используют отдельные классы, которые играют роль метаклассов.

Давайте повторим нашу реализацию но не через функцию, а через класс. Вначале объявим класс с именем Meta (имя выбираем сами, это просто пример), который должен наследоваться от метакласса type:

class Meta(type):
    def __init__(cls, name, base, attrs):
        super().__init__(name, base, attrs)
        cls.MAX_COORD = 100
        cls.MIN_COORD = 0

Внутри этого класса мы прописали инициализатор с четырьмя параметрами. Первый cls – это ссылка на новый уже созданный класс, а три остальных вам уже знакомы. Внутри инициализатора мы вызываем инициализатор базового класса, а затем, динамически добавляем два атрибута MAX_COORD и MIN_COORD.

А далее все то же самое. Через параметр metaclass указываем метакласс для создания класса Point и тестируем его работу:

class Point(metaclass=Meta):
    def get_coords(self):
        return (0, 0)
 
 
pt = Point()
print(pt.MAX_COORD)
print(pt.get_coords())

Однако, инициализатор init() в классе Meta вызывается когда класс Point полностью создан. Для более тонкой работы лучше переопределить магический метод new, который вызывается непосредственно перед созданием класса. В нашем случае это можно сделать так:

class Meta(type):
    def __new__(cls, name_class, base, attrs):
        attrs.update({'MAX_COORD': 100, 'MIN_COORD': 0})
        return type.__new__(cls, name_class, base, attrs)

Здесь записаны четыре параметра: cls – ссылка на текущий класс Meta; name_class – имя создаваемого класса; base – кортеж из базовых классов; attrs – словарь атрибутов создаваемого класса.

Так как метод new вызывается до создания нового класса, то мы добавляем новые атрибуты MAX_COORD и MIN_COORD непосредственно в словарь attrs. А, затем, вызываем аналогичный метод new у объекта-метакласса type. Обратите внимание, метод new должен вернуть ссылку на созданный класс, то есть, обязательно следует прописать оператор return.

После запуска программы видим, что класс Point создается в соответствии с алгоритмом метакласса Meta.

Возможно, здесь у вас возник вопрос, а в чем преимущество использования классов в качестве метаклассов перед функциями? Принципиальных отличий здесь нет. Любой алгоритм можно прописать и на уровне функции и на уровне класса. Однако, при использовании классов у нас в руках оказывается вся мощь ООП. В частности, можно создавать иерархии для формирования сложного поведения метаклассов и в крупных проектах это заметно облегчает код и делает его гораздо читабельнее. Поэтому на практике чаще все же используют классы из-за их удобства.

Надеюсь, теперь вы представляете как «работают» метаклассы и как можно динамически создавать с их помощью новые классы в программе на Python. Наверное, здесь остался у вас главный вопрос, где все это можно применить. Но об этом я расскажу уже на следующем занятии и покажу все на конкретном примере.

Урок 37 · Часть II. ООП на Python

Метаклассы в API ORM Django

Источник: python-metaklassy-api-orm-django

Мы продолжаем тему метаклассов. На этом занятии я хочу привести один более-менее практический пример их использования, чтобы вы лучше понимали их роль в программировании.

Фреймворк Django использует метаклассы для связи объектов с записями БД. То есть, метаклассы используются для реализации его API для ORM. В частности, он делает следующее. Можно определить класс модели с набором атрибутов, которые будут представлять соответствующие поля таблицы БД. Например, предположим, что имеется класс Women для работы с таблицей, содержащей поля title, content, photo и т.д.:

class Women(models.Model):
    title = models.CharField(max_length=255)
    content = models.TextField(blank=True)
    photo = models.ImageField(upload_to="photos/%Y/%m/%d/")
    time_create = models.DateTimeField(auto_now_add=True)
    time_update = models.DateTimeField(auto_now=True)
    is_published = models.BooleanField(default=True)

Затем, во фреймворке Django нам достаточно создать экземпляр этого класса:

w = Women(title='Энн Хэтэуэй')

чтобы прочитать все записи содержащие поле title равное ‘Энн Хэтэуэй’. Причем сами данные появляются автоматически в локальных свойствах объекта w. То есть, далее мы можем обратиться к данным из таблицы, например, так:

w.photo
w.content

И так далее. Вот эта магия по созданию объекта, в котором сразу оказываются нужные данные с соответствующими наборами локальных свойств и выполняется на уровне метаклассов. В действительности, базовый класс Model, как раз и реализует этот метакласс, добавляя необходимый функционал в класс модели Women.

Это конкретный пример, где используются метаклассы. Чтобы все было более понятно, давайте сделаем метакласс, который бы позволял при создании объектов класса автоматически добавлять в него локальные свойства с теми же именами, что и атрибуты класса. То есть, мы повторим некоторый функционал API ORM Django.

Вначале определим метакласс, в котором пропишем методы create_local_attrs и init:

class Meta(type):
    def create_local_attrs(self, *args, **kwargs):
        for key, value in self.class_attrs.items():
            self.__dict__[key] = value
 
    def __init__(cls, name_class, base, attrs):
        cls.class_attrs = attrs
        cls.__init__ = Meta.create_local_attrs

Первый метод create_local_attrs будет в дальнейшем являться инициализатором создаваемого класса. И в этом инициализаторе мы, как раз и создаем локальные свойства в экземплярах класса. Для этого в самом классе мы создаем специальный словарь class_attrs, который содержит все атрибуты класса с их значениями. Фактически, класс Women у нас теперь становится таким:

class Women:
    class_attrs = {'title': 'заголовок', 'content': 'контент', 'photo': 'путь к фото'}
    title = 'заголовок'
    content = 'контент'
    photo = 'путь к фото'
 
    def __init__(self, *args, **kwargs):
        for key, value in self.class_attrs.items():
            self.__dict__[key] = value

Конечно, метаклассы во фреймворке Django гораздо изощреннее нашего с вами примера. Я здесь лишь хотел показать саму идею их использования при создании различных API. А, вообще, конечно следует избегать их применения на практике, так как они несколько запутывают программный код и являются источником трудно отслеживаемых ошибок. Здесь всегда следует держать в голове высказывание гуру Питона Тима Питерса:

Метаклассы – это глубокая магия, о которой 99% пользователей даже не нужно задумываться. Если вы думаете, нужно ли вам их использовать — вам не нужно (люди, которым они реально нужны, точно знают, зачем они им, и не нуждаются в объяснениях, почему).

Надеюсь, они вам не понадобятся, а если понадобятся, то вы теперь имеете представление, что это такое.

Практика 9 · Часть II. ООП на Python

Метаклассы

Задания для закрепления темы · решений нет

Цели обучения

  • Создавать классы динамически через type
  • Настраивать создание классов через metaclass=
  • Собрать упрощённый API полей/реестра по мотивам ORM (без Django)

Задания

Задание 1. Создать класс через type

Сложность: лёгкое

Без оператора class создайте класс Greeter.

Требования:

  • Используйте type(name, bases, namespace)
  • В пространстве имён — __init__(self, name) и метод greet(self) -> str, возвращающий f"Hello, {self.name}"
  • Продемонстрируйте Greeter("Ada").greet()

Задание 2. Метакласс-реестр

Сложность: среднее

Реализуйте метакласс RegistryMeta, собирающий подклассы.

Требования:

  • Базовый класс Plugin(metaclass=RegistryMeta)
  • Атрибут класса registry: dict[str, type], отображающий __name__ класса → класс
  • Не регистрируйте сам Plugin; регистрируйте конкретные подклассы при определении
  • Метод Plugin.create(name: str, *args, **kwargs) создаёт экземпляр из реестра или возбуждает KeyError

Пример:

class Alpha(Plugin):
    pass

assert "Alpha" in Plugin.registry

Задание 3. Требовать имена абстрактных методов

Сложность: среднее

Метакласс RequireRunMeta гарантирует, что каждый неабстрактный конкретный класс определяет run.

Требования:

  • Если в словаре класса есть _abstract = True, проверку пропускайте
  • Иначе, если нет run, возбуждайте TypeError в момент создания класса
  • Работает для подклассов базы с этим метаклассом

Задание 4. Метакласс Auto-repr

Сложность: среднее

Метакласс AutoReprMeta добавляет __repr__, если его нет.

Требования:

  • __repr__ по умолчанию: ClassName(attr=value, ...) для элементов __dict__ экземпляра (или slots, если обнаружите)
  • Не перезаписывайте существующий __repr__

Задание 5. Мини-проект: крошечные ORM-подобные модели

Сложность: сложное

Соберите учебное подмножество ORM API полей (только в памяти).

Требования:

  • Класс Field, хранящий field_type: type (например, int, str)
  • Метакласс ModelMeta:

- Собирает экземпляры Field из пространства имён класса в cls._fields: dict[str, Field]

- Убирает сырые объекты Field из пространства имён экземпляра по необходимости, чтобы экземпляры хранили обычные значения

- Регистрирует каждый класс модели в ModelMeta.models по имени класса

  • Базовый Model(metaclass=ModelMeta):

- __init__(self, **kwargs) задаёт атрибуты объявленных полей; неизвестные ключи → TypeError

- Отсутствующие поля получают None или возбуждают TypeError (выберите одно; задокументируйте)

- to_dict(self) -> dict

- Метод класса from_dict(cls, data: dict) -> Model

  • Примеры моделей:

```python

class User(Model):

id = Field(int)

name = Field(str)

```

  • In-memory store: dict[type, list[Model]] и хелперы save(obj) и all(model_cls) — опционально, но рекомендуются

Пример:

u = User(id=1, name="Ada")
assert u.to_dict() == {"id": 1, "name": "Ada"}
assert "User" in ModelMeta.models

Подсказки:

  • В __new__/__init__ метакласса итерируйте attrs.items() и проверяйте isinstance(v, Field)
  • SQL и миграции оставляйте за рамками задания

Глава 10

Датаклассы

Урок 38 · Часть II. ООП на Python

Введение в Python Data Classes (часть 1)

Источник: python-oop-vvedenie-v-python-data-classes-chast-1

Я Сергей Балакирев и на этом занятии мы познакомимся с относительно новой идеей «быстрого» описания классов (классов данных – Data Classes). О чем здесь речь? Смотрите, довольно часто при объявлении классов в программах на Python приходится прописывать инициализатор, например, следующим образом:

class Thing:
    def __init__(self, name, weight, price):
        self.name = name
        self.weight = weight
        self.price = price

То есть, передается несколько полей: name, weight, price, которые предполагается сохранять в объектах класса Thing. И это довольно типовая ситуация. Мало того, если создать объект этого класса и вывести его в консоль:

t = Thing("Учебник по Python", 100, 1024)
print(t)

то увидим нечто неинформативное, вроде:

<main.Thing object at 0x0000014B7D29A7D0>

Поэтому, опять же нередко, в таких классах с данными приходится прописывать магический метод repr(), например, так:

    def __repr__(self):
        return f"Thing: {self.__dict__}"

Видите, сколько типовой писанины приходится делать для описания классов, подобных классу Thing?! И это лишь необходимый минимум. Представьте объем рутиной работы для описания всего лишь нескольких таких классов.

Так как программист, зачастую, существо глубоко ленивое, но творческое, уже давно предпринимались попытки автоматизировать этот процесс. И вот, начиная с версии Python 3.7, появилась возможность «из коробки» использовать инструмент для оптимизации объявления классов, содержащих произвольные данные, то есть, Data Classes. Для этого, в самом простом варианте, достаточно импортировать специальный декоратор, который так и называется dataclass:

from dataclasses import dataclass

И с его помощью объявим в программе еще один класс ThingData, который будет эквивалентен ранее объявленному классу Thing:

@dataclass
class ThingData:
    name: str
    weight: int
    price: float

Смотрите, какое у нас получилось компактное объявление класса ThingData! Поясню, что здесь к чему. Вначале должен идти декоратор dataclass, который будет формировать описание класса ThingData с инициализатором и магическим методом repr(). Внутри класса следует описание параметров для инициализатора. Да, все приведенные атрибуты внутри класса ThingData впоследствии, с помощью декоратора dataclass, преобразуются в набор параметров инициализатора. При этом атрибуты обязательно должны быть аннотированы соответствующими типами данных.

Давайте детальнее посмотрим, что в итоге будет содержать класс ThingData. Для этого мы импортируем функцию pprint() для лучшего отображения данных из коллекций:

from pprint import pprint

и вызовем ее для коллекции dict класса ThingData:

pprint(ThingData.__dict__)

Видим, что dict ссылается на объект типа mappingproxy, внутри которого имеется инициализатор init() и магический метод repr(). То есть, в класс ThingData автоматически были добавлены эти два метода. Кроме того, имеется магический метод eq() для выполнения операции сравнения на равенство объектов класса ThingData. Также имеется специальный словарь dataclass_fields, содержащий указанные нами атрибуты при описании класса ThingData. Таким образом, класс ThingData обладает необходимым базовым функционалом при работе с атрибутами: name, weight и price. Давайте в этом убедимся. Создадим объект этого класса:

td = ThingData("Учебник по Python", 100, 1024)

Обратите внимание, в качестве первого аргумента я указал строку, а вторые два – это вес и цена. То есть, параметры в инициализаторе следуют в том же порядке, что и атрибуты, указанные при описании класса ThingData. И это чаще всего так. Порядок, как правило, не изменяют и оставляют по умолчанию.

Далее, выведем на экран объект td с помощью функции print():

print(td)

Увидим в консоли информацию:

ThingData(name=’Учебник по Python’, weight=100, price=1024)

Видите, как информативно отображается объект td класса ThingData?! Это, как раз, благодаря переопределению магического метода repr() внутри класса ThingData. Для уверенности, мы можем даже явно его вызвать в функции print() следующим образом:

print(repr(td))

и увидим тот же самый результат. И это очень здорово! Нам теперь не нужно тратить время на написание типового, рутинного кода. Да и само объявление класса в программе, чисто визуально, выглядит куда лучше. Главное, правильно понимать это объявление.

Отлично, первый шаг в понимании и использования декоратора dataclass мы с вами сделали. Но это только начало. Давайте попробуем протестировать еще один магический метод eq(), который также был добавлен в класс ThingData. Для этого мы создадим в программе второй объект этого класса:

td_2 = ThingData("Python ООП", 80, 512)

и выполним сравнение двух объектов:

print(td == td_2)

Увидим ожидаемое значение False. Но, если создать еще один экземпляр с тем же набором данных:

td_3 = ThingData("Python ООП", 80, 512)

то операция сравнения:

print(td_2 == td_3)

вернет значение True.

Я, думаю, из этих примеров вы уже поняли, как работает переопределенный магический метод eq()? Он перебирает значение указанных нами атрибутов (name, weight, price) первого объекта и сравнивает с соответствующими значениями этих же атрибутов второго объекта. Это эквивалентно сравнению следующих кортежей на равенство:

(name, weight, price) == (name, weight, price)

Кстати, если нас это поведение не устраивает и нужно сравнивать, например, объекты только по весу (полю weight), то, как вариант, никто не запрещает внутри класса ThingData объявить свой вариант магического метода eq():

@dataclass
class ThingData:
    name: str
    weight: int
    price: float
 
    def __eq__(self, other):
        return self.weight == other.weight

В этом случае существующий метод (который был объявлен нами) не меняется декоратором dataclass. И теперь сравнение происходит именно по весу:

td_2 = ThingData("Python ООП", 80, 640)
td_3 = ThingData("Python ООП 2", 80, 512)
print(td_2 == td_3)

И так происходит работа с методами: init(), repr(), eq(). Если они существуют внутри класса, то остаются неизменными.

Следующий важный базовый момент, при определении Data Classes, состоит в порядке объявления атрибутов с начальными значениями. Давайте предположим, что цена по умолчанию принимает значение 0. В этом случае класс ThingData можно определить так:

@dataclass
class ThingData:
    name: str
    weight: int
    price: float = 0

И, затем, создать объект этого класса:

td = ThingData("Учебник по Python", 100)
print(td)

В консоли увидим значение 0 для локального атрибута price. Если же будет передано какое-либо другое значение, например:

td = ThingData("Учебник по Python", 100, 512)

то price будет ссылаться на это новое значение.

Но здесь есть один маленький нюанс: все атрибуты со значениями по умолчанию должны идти последними. Например, если поменять атрибуты weight и price местами:

@dataclass
class ThingData:
    name: str
    price: float = 0
    weight: int

то интегрированная среда нам сразу подчеркнет атрибут price, а при попытке выполнить программу появится ошибка. Почему так произошло? И почему атрибуты с начальными значениями обязательно должны быть последними? Ответ прост и я думаю, некоторые из вас уже догадались в чем дело. Так как эти атрибуты, по сути, являются параметрами метода init() и идут в том порядке, в котором записаны в классе, то при данной записи получаем следующее объявление инициализатора:

def __init__(self, name: str, price: float = 0, weight: int)

Видите в чем тут ошибка? Параметры со значениями по умолчанию должны идти последними, а здесь это не так. Отсюда и возникает ошибка определения. Поэтому, когда мы объявляем класс как Data Class с декоратором dataclass, то все атрибуты с начальными значениями должны быть записаны последними.

Второй тонкий момент со значениями по умолчанию связан с изменяемыми и неизменяемыми объектами. Я напомню вам одно важное поведение функций и методов в языке Python. Предположим, что мы в инициализатор класса Thing добавляем еще один параметр dims (размерность) следующим образом:

class Thing:
    def __init__(self, name, weight, price, dims=[]):
        self.name = name
        self.weight = weight
        self.price = price
        self.dims = dims

И, затем, создаем объект этого класса:

t = Thing("Учебник по Python", 100, 1024)
t.dims.append(10)

Если сейчас вывести список dims, то увидим вполне ожидаемый результат:

print(t.dims)

Но, если после этого создать еще один объект класса Thing, например, так:

t2 = Thing("Учебник по Python", 100, 1024)

и выведем у него список dims:

print(t2.dims)

то увидим не пустой список, а с одним уже существующим значением 10. Чаще всего такое поведение приводит к непредвиденным ошибкам в работе программы, т.к. начальный пустой список подразумевается независимым для каждого объекта класса Thing. Тогда как в показанном примере он оказывается общим.

По этой причине при объявлении Data Classes атрибутам нельзя присваивать изменяемые объекты в качестве значений по умолчанию. Например, следующее объявление приведет к ошибке:

@dataclass
class ThingData:
    name: str
    weight: int
    price: float = 0
    dims: list = []

Тогда спрашивается, как нам определить, например, список в качестве значения по умолчанию и так, чтобы он был независимым для каждого объекта класса ThingData? Для этого следует воспользоваться специальной функцией field() из модуля dataclasses:

from dataclasses import dataclass, field

и определить через нее значение по умолчанию следующим образом:

@dataclass
class ThingData:
    name: str
    weight: int
    price: float = 0
    dims: list = field(default_factory=list)

Здесь через параметр default_factory указывается, какой объект следует создавать в момент вызова инициализатора класса ThingData и присваивать атрибуту dims. В данном примере – это объект list (список). Теперь, при создании объекта этого класса:

td = ThingData("Учебник по Python", 100, 512)
print(td)

мы увидим, что dims ссылается на пустой список, как это и ожидалось.

Вообще с помощью функции field() можно довольно тонко настраивать поведение атрибутов в Data Classes, но об этом и других вещах мы продолжим говорить на следующем занятии.

Урок 39 · Часть II. ООП на Python

Введение в Python Data Classes (часть 2)

Источник: python-oop-vvedenie-v-python-data-classes-chast-2

Я Сергей Балакирев и мы продолжаем тему Data Classes – классы данных. На предыдущем занятии мы в целом научились объявлять такие классы с помощью декоратора dataclass и определять набор необходимых атрибутов:

@dataclass
class ThingData:
    name: str
    weight: int
    price: float = 0
    dims: list = field(default_factory=list)

Но давайте представим, что нам нужно в некотором классе, например, Vector3D при инициализации формировать вычисляемое свойство:

class Vector3D:
    def __init__(self, x: int, y: int, z: int):
        self.x = x
        self.y = y
        self.z = z
        self.length = (x * x + y * y + z * z) ** 0.5

Здесь локальный атрибут length вычисляется на основе параметров x, y, z. Как это можно сделать при объявлении Data Classes?

Метод post_init()

Вначале, очевидно, нужно прописать класс с тремя атрибутами следующим образом:

@dataclass
class V3D:
    x: int
    y: int
    z: int

Что делать дальше, как определить локальный атрибут length внутри объекта класса V3D? Для этого существует следующая хитрость. Инициализаторы классов, сформированные с помощью декоратора dataclass, в конце своего вызова вызывают специальный метод post_init(). Именно в этом методе можно формировать любые вычисляемые свойства, например, так:

@dataclass
class V3D:
    x: int
    y: int
    z: int
 
    def __post_init__(self):
        self.length = (self.x * self.x + self.y * self.y + self.z * self.z) ** 0.5

Если далее мы сформируем объект этого класса и выведем его в консоль:

v = V3D(1, 2, 3)
print(v)

то увидим:

V3D(x=1, y=2, z=3)

Спрашивается, почему здесь не видно свойства length? В действительности, оно присутствует в объекте v и мы в этом легко можем убедиться:

print(v.__dict__)

увидим:

{‘x’: 1, ‘y’: 2, ‘z’: 3, ‘length’: 3.7416573867739413}

Но тогда почему оно не выводится функцией repr()? Дело в том, что магический метод repr() выводит только те атрибуты, которые были указаны при объявлении класса. Все остальные, что создаются в процессе формирования объекта, не учитываются в методе repr(). Как тогда выйти из этой ситуации и указать, что локальный атрибут length также следует отображать? Очень просто! Давайте укажем этот атрибут при объявлении класса с небольшим уточнением:

@dataclass
class V3D:
    x: int
    y: int
    z: int
    length: float = field(init=False)
 
    def __post_init__(self):
        self.length = (self.x * self.x + self.y * self.y + self.z * self.z) ** 0.5

Мы здесь воспользовались уже знакомой нам функцией field() и отметили, что атрибут length не следует использовать в качестве параметра инициализатора. Изящно, правда?! Теперь, при отображении объекта v класса, мы увидим и параметр length.

Функция field()

Вообще функция field() предоставляет богатый функционал по управлению объявляемых атрибутов в Data Classes. Мы увидели, как работают два ее параметра: init и default_factory. Довольно часто можно встретить использование еще трех:

  • repr – булевое значение True/False указывает использовать ли атрибут в магическом методе repr() (по умолчанию True);
  • compare – булевое значение True/False указывает использовать ли атрибут при сравнении объектов (по умолчанию True);
  • default – значение по умолчанию (начальное значение).

Смысл их вполне понятен. Давайте исключим атрибут x из метода repr() и из операций сравнения атрибуты z и length. Получим следующее объявление класса:

@dataclass
class V3D:
    x: int = field(repr=False)
    y: int
    z: int = field(compare=False)
    length: float = field(init=False, compare=False)
 
    def __post_init__(self):
        self.length = (self.x * self.x + self.y * self.y + self.z * self.z) ** 0.5

Тогда при отображении и сравнении двух объектов:

v = V3D(1, 2, 3)
v2 = V3D(1, 2, 5)
print(v)
print(v == v2)

мы увидим только три атрибута: y, z, length и результат True, т.к. координаты x, y объектов v и v2 совпадают.

С остальными параметрами функции field() можно познакомиться на странице официальной документации:

https://docs.python.org/3/library/dataclasses.html

Объявление параметров типа InitVar

Давайте теперь предположим, что мы бы хотели вычислять длину вектора в зависимости от значения некоторого параметра, например, calc_len. При описании обычного инициализатора это можно было бы сделать следующим образом:

class Vector3D:
    def __init__(self, x: int, y: int, z: int, calc_len: bool = True):
        self.x = x
        self.y = y
        self.z = z
        self.length = (x * x + y * y + z * z) ** 0.5 if calc_len else 0

А как это сделать при объявлении Data Classes? Для определения параметров, участвующих в инициализации (таких, как calc_len) в модуле dataclasses есть специальный класс типа InitVar:

from dataclasses import dataclass, field, InitVar

Если при объявлении атрибут аннотируется этим классом, то он автоматически передается как параметр в метод post_init(), чтобы им можно было воспользоваться при формировании вычисляемых свойств:

@dataclass
class V3D:
    x: int = field(repr=False)
    y: int
    z: int = field(compare=False)
    calc_len: InitVar[bool] = True
    length: float = field(init=False, compare=False, default=0)
 
    def __post_init__(self, calc_len: bool):
        if calc_len:
            self.length = (self.x * self.x + self.y * self.y + self.z * self.z) ** 0.5

Обратите внимание, я здесь для атрибута length добавил параметр default=0 в функции field(). То есть, начальное значение атрибута length равно нулю. Если параметр calc_len равен True, то в методе post_init() будет пересчитано и сформировано новое значение локального атрибута length.

Параметры декоратора dataclass

До сих пор мы с вами использовали декоратор dataclass с параметрами по умолчанию. Однако ему можно передавать различные аргументы и управлять процессом формирования итогового класса. Вот основные параметры, которые принимает декоратор dataclass.

Параметр Описание
init = [True False]
repr = [True False]
eq = [True False]
order = [True False]
unsafe_hash = [True False]
frozen = [True False]
slots = [True False]

Существуют и другие параметры декоратора dataclass. Подробно о них можно почитать на странице официальной документации:

https://docs.python.org/3/library/dataclasses.html

Давайте последовательно рассмотрим основные из них. Первые параметры init, repr, eq я, думаю, понятны. Если в декоратор передать аргумент init=False:

@dataclass(init=False)

то класс будет сформирован без собственного инициализатора (будет использован инициализатор базового класса). В результате у нас не получится создать объект с передачей значений аргументов:

v = V3D(1, 2, 3, False)

Это бывает полезно, когда все описанные атрибуты принимают значения по умолчанию и не предполагается их сразу переопределять в инициализаторе. Например, если класс в дальнейшем будет использован как базовый для построения других дочерних классов.

Следующий параметр:

@dataclass(repr=False)

запрещает формирование магического метода repr() внутри текущего класса. В результате, будет использован аналогичный метод базового класса. В этом легко убедиться, если создать объект и вывести его в консоль:

v = V3D(1, 2, 3, False)
print(v)

Увидим что то похожее на:

<main.V3D object at 0x00000236FAD67D50>

По аналогии работает параметр eq:

@dataclass(repr=False, eq=False)

Он запрещает формирование собственного магического метода eq() для сравнения объектов между собой на равенство. Теперь объекты сравниваются по их идентификаторам, и так как они разные, то при сравнении:

v = V3D(1, 2, 3, False)
v2 = V3D(1, 2, 3)
print(v == v2)

получаем значение False.

Следующий параметр order может быть установлен в True только совместно с eq=True. Например, следующая строчка приведет к ошибке:

@dataclass(eq=False, order=True)

Поэтому нам нужно или убрать параметр eq (по умолчанию он True), либо явно прописать у него значение True:

@dataclass(eq=True, order=True)

Я, думаю, вы догадались почему? Операции сравнения на больше или равно, меньше или равно используют магический метод eq(). Поэтому он должен присутствовать.

Итак, после включения параметра order, у нас появляется возможность сравнивать объекты класса на больше, меньше и больше или равно и меньше или равно:

@dataclass(eq=True, order=True)
class V3D:
    x: int
    y: int
    z: int
 
 
v = V3D(1, 2, 5)
v2 = V3D(1, 2, 3)
 
print(v < v2)  # False
print(v > v2)  # True

Сравнение выполняется на уровне кортежей, содержащих значения атрибутов (x, y, z) в порядке их объявления в классе. В данном случае происходит последовательное сравнение сначала значений x между собой, затем, y и потом – z. Как только встречается пара, для которой можно вычислить значение True или False, проверка завершается. Фактически, в приведенном примере, сравниваются между собой только последние числа 5 и 3, остальные равны, поэтому операции < и > их пропускают.

Если нам нужно исключить какие-либо атрибуты из операций сравнений, то, как я уже отмечал, для этого следует использовать функцию field() и в ней через параметр compare исключить соответствующее поле:

@dataclass(eq=True, order=True)
class V3D:
    x: int = field(compare=False)
    y: int
    z: int

Теперь сравниваться будут объекты только по двум локальным атрибутам y и z.

Здесь следует обратить внимание на то, что если в классе объявить какой-либо метод сравнения на больше, меньше или больше либо равно или меньше либо равно, то возникнет исключение TypeError:

@dataclass(order=True)
class V3D:
    x: int = field(compare=False)
    y: int
    z: int
 
    def __lt__(self, other):
        return self.x < other.x and self.y < other.y

Последний параметр, который мы рассмотрим – frozen, позволяет «замораживать» значения атрибутов класса. Например:

@dataclass(frozen=True)
class V3D:
    x: int
    y: int
    z: int
 
 
v = V3D(1, 2, 3)
print(v)
v.x = 5

Приведет к ошибке в последней строчке, т.к. менять локальные атрибуты при frozen=True в объектах класса нельзя.

На этом мы завершим это занятие, на следующем продолжим эту тему и в частности увидим, как объявление Data Classes работает при наследовании.

Урок 40 · Часть II. ООП на Python

Python Data Classes при наследовании

Источник: python-oop-data-classes-pri-nasledovanii

Я Сергей Балакирев и мы продолжаем тему Data Classes – классы данных. На этом занятии затронем тему наследования классов, объявленных с помощью декоратора dataclass. В качестве примера мы сформируем базовый класс с именем Goods для представления различных товаров:

from dataclasses import dataclass, field, InitVar
from typing import Any
 
 
@dataclass
class Goods:
    uid: Any
    price: Any = None
    weight: Any = None

А ниже, на его основе объявим дочерний класс Book для описания книг:

@dataclass
class Book(Goods):
    title: str = ""
    author: str = ""
    price: float = 0
    weight: int | float = 0

Смотрите, здесь в дочернем классе повторяются атрибуты price и weight. Спрашивается, какие инициализаторы в итоге будут формироваться в первом и во втором классах? Для первого базового класса Goods все очевидно. Будет объявлен инициализатор со следующей сигнатурой:

def __init__(self, uid: Any, price: Any = None, weight: Any = None):

А в дочернем классе будем иметь такой инициализатор:

def __init__(self, uid: Any, price: float = 0, weight: int | float = 0, title: str = "", author: str = ""):

То есть, уникальные атрибуты добавляются в конец, а переопределенные (по типу данных в аннотации и начальному значению) остаются в своих позициях, но с указанными типами и начальными значениями. Поэтому, если далее мы создадим объект класса Book и выведем его на экран:

b = Book(1)
print(b)

то увидим строчку:

Book(uid=1, price=0, weight=0, title=’‘, author=’‘)

Или же, можно создать объект, указав весь набор аргументов:

b = Book(1, 1000, 100, "Python ООП", "Балакирев С.М.")
print(b)

Тогда в консоль будет выведена информация:

Book(uid=1, price=1000, weight=100, title=’Python ООП’, author=’Балакирев С.М.’)

Учитывая порядок атрибутов и параметров в инициализаторах, мы в дочернем классе у всех атрибутов должны указывать начальные значения. Иначе, получим ошибку, что параметры со значениями по умолчанию price и weight идут до обычных позиционных параметров.

Вызов метода post_init() при наследовании

Давайте несколько усложним нашу программу и будем формировать значение uid автоматически при создании каждого нового объекта. Я сделаю это следующим образом:

@dataclass
class Goods:
    current_uid = 0
 
    uid: int = field(init=False)
    price: Any = None
    weight: Any = None
 
    def __post_init__(self):
        print("Goods: post_init")
        Goods.current_uid += 1
        self.uid = Goods.current_uid

Здесь в класс Goods добавлен обычный атрибут current_uid = 0 с начальным значением 0 и без аннотации. В результате, это будет просто атрибут уровня класса. Атрибут uid исключен из параметров инициализатора и формируется теперь в методе post_init(). В этом методе выводится строка “Goods: post_init”, чтобы было видно, что этот метод был вызван. И, затем, вычисляется текущее значение локального атрибута uid (у каждого объекта он будет уникальным).

Дочерний класс Book мы пока оставим без изменений. Если теперь создать объект и вывести его в консоль:

b = Book(1000, 100, "Python ООП", "Балакирев С.М.")
print(b)

то увидим следующие строчки:

Goods: post_init
Book(uid=1, price=1000, weight=100, title=’Python ООП’, author=’Балакирев С.М.’)

То есть, метод post_init() базового класса был успешно вызван и свойство uid корректно сформировано.

Давайте теперь добавим такой же метод post_init() в дочерний класс Book, например, так:

@dataclass
class Book(Goods):
    title: str = ""
    author: str = ""
    price: float = 0
    weight: int | float = 0
 
    def __post_init__(self):
        print("Book: post_init")

И при запуске программы получаем ошибку, что свойство uid отсутствует в объекте b. Почему так произошло? Я, думаю, вы уже догадались. Как только мы прописали метод post_init() в дочернем классе, то инициализатор дочернего класса именно его и вызовет. При этом вызов такого же метода базового класса выполняться уже не будет.

Как исправить эту ситуацию? В самом простом варианте можно явно вызвать метод post_init() базового класса. Благо, он там всегда присутствует:

    def __post_init__(self):
        super().__post_init__()
        print("Book: post_init")

Теперь никаких проблем с начальной инициализацией вычисляемых свойств базового класса у нас не возникает.

Обратите внимание, что для формирования локальных атрибутов нам не нужно самим вызывать инициализатор базового класса. Это уже автоматически закладывается при наследовании, когда классы формируются через декоратор dataclass. Если бы мы сами формировали цепочку наследования без использования декоратора dataclass (классическим способом), то вызов инициализаторов базовых классов нужно было бы явно указывать.

Пользовательские методы в параметре default_factory функции field

Давайте еще несколько усложним нашу программу и добавим в дочерний класс Book еще один атрибут measure следующим образом:

@dataclass
class Book(Goods):
    title: str = ""
    author: str = ""
    price: float = 0
    weight: int | float = 0
    measure: list = field(default_factory=GoodsMethodsFactory.get_init_measure)
 
    def __post_init__(self):
        super().__post_init__()
        print("Book: post_init")

По смыслу это свойство содержит габариты предмета, в данном случае книги. Так как всего габаритных размера три: высота, длина и ширина, то нам бы хотелось сразу сформировать список из трех числовых значений. И пусть эти значения по умолчанию равны нулю. Для этого достаточно передать ссылку на функцию, которая будет возвращать список из трех значений. Эта функция будет вызываться в момент создания объекта класса Book.

Глядя сейчас на эту строчку, у вас может возникнуть вопрос: почему бы эту функцию (метод) не объявить внутри класса Book, а потом указать в параметре default_factory? Но если мы сейчас попробуем это сделать:

measure: list = field(default_factory=Book.get_init_measure)

и определим метод get_init_measure() как статический внутри класса Book:

    @staticmethod
    def get_init_measure():
        return [0, 0, 0]

то получим ошибку, что имя Book не определено. На мой взгляд, красивый выход из этой ситуации – это объявить еще один самостоятельный класс, в котором определять методы, используемые в функции field, например, так:

class GoodsMethodsFactory:
    @staticmethod
    def get_init_measure():
        return [0, 0, 0]

Тогда никаких ошибок не будет и локальный атрибут measure сформируется с нужными нам начальными значениями:

Book(uid=1, price=1000, weight=100, title=’Python ООП’, author=’Балакирев С.М.’, measure=[0, 0, 0])

Функция make_dataclass

В заключение этого занятия кратко отмечу, что есть еще один способ объявления Data Classes с помощью функции make_dataclass(), которая имеет следующие наборы параметров:

dataclasses.make_dataclass(cls_name, fields, *, bases=(), namespace=None, init=True, repr=True, eq=True, order=False, unsafe_hash=False, frozen=False, match_args=True, kw_only=False, slots=False, weakref_slot=False)

Основные из них следующие:

  • cls_name – название нового класса (в виде строки);
  • fields – поля (локальные атрибуты) объектов класса;
      • произвольный набор позиционных аргументов;
  • bases – список базовых классов;
  • namespace – словарь для определения атрибутов самого класса (например, так можно объявлять методы класса).

Некоторые остальные параметры вам уже известны, они совпадают с параметрами декоратора dataclass.

Давайте для примера объявим класс аналогичный следующему:

class Car:
    def __init__(self, model, max_speed, price):
        self.model = model
        self.max_speed = max_speed
        self.price = price
 
    def get_max_speed(self):
        return self.max_speed

С помощью функции make_dataclass() это можно сделать так:

CarData = make_dataclass("CarData", [("model", str),
                                     "max_speed",
                                     ("price", float, field(default=0))],
                         namespace={'get_max_speed': lambda self: self.max_speed})

Создадим объект этого класса:

c = CarData("BMW", 256, 4096)

и выведем его на экран:

print(c)
print(c.get_max_speed())

Как видите, все отработало как надо.

Обычно, функцию make_dataclass() используют, если требуется сформировать класс данных в процессе работы программы. Если же нам нужно обычное объявление (а это наиболее частая ситуация), то гораздо удобнее использовать декоратор dataclass.

Вот основные возможности формирования классов данных на языке Python. Более подробную информацию, как всегда, можно посмотреть на странице официальной документации:

https://docs.python.org/3/library/dataclasses.html

Практика 10 · Часть II. ООП на Python

Датаклассы

Задания для закрепления темы · решений нет

Цели обучения

  • Заменять шаблонный код через @dataclass
  • Настраивать поля (default, default_factory, repr, compare, frozen)
  • Безопасно сочетать датаклассы с наследованием

Задания

Задание 1. Базовая запись о городе

Сложность: лёгкое

Реализуйте @dataclass City.

Требования:

  • Поля: name: str, population: int, country: str = "Unknown"
  • Сравнение и repr по умолчанию от dataclass
  • Создайте два экземпляра и покажите равенство при совпадении полей

Пример:

a = City("X", 1000)
b = City("X", 1000)
assert a == b

Задание 2. Параметры field

Сложность: лёгкое

Реализуйте @dataclass Session.

Требования:

  • id: str
  • tags: list[str] = field(default_factory=list)
  • password: str = field(repr=False, compare=False)
  • created: float = field(default_factory=time.time) (или подставляйте время для тестов)
  • Покажите, что password отсутствует в repr и игнорируется в ==

Задание 3. Замороженная координата

Сложность: среднее

Реализуйте @dataclass(frozen=True, slots=True) Coord с x: float, y: float.

Требования:

  • Экземпляры хешируемы и пригодны для set
  • Попытка присваивания после создания возбуждает (frozen)
  • Метод translate(self, dx, dy) -> Coord возвращает новый экземпляр

Задание 4. Порядок и post-init

Сложность: среднее

Реализуйте @dataclass(order=True) PriorityJob.

Требования:

  • Поля: priority: int, name: str
  • __post_init__ возбуждает ValueError, если priority < 0
  • Сортировка списка заданий упорядочивает по priority, затем по name (порядок полей dataclass)

Пример:

jobs = [PriorityJob(2, "b"), PriorityJob(1, "a")]
assert sorted(jobs)[0].name == "a"

Задание 5. Наследование с датаклассами

Сложность: среднее

Реализуйте:

Требования:

  • @dataclass class Person: name: str, age: int
  • @dataclass class Employee(Person): salary: float, department: str = "general"
  • Все поля конструируются корректно: Employee("Ada", 30, 1000.0)
  • Покажите asdict / astuple из dataclasses на Employee

Подсказки:

  • Поля без значения по умолчанию не должны некорректно следовать за полями с default по иерархии — держите department последним

Задание 6. Мини-проект: позиции инвентаря

Сложность: сложное

Смоделируйте инвентарь магазина только на датаклассах (плюс небольшие хелперы).

Требования:

  • @dataclass class Item: sku: str, title: str, price: float, qty: int = 0

- __post_init__ проверяет price >= 0, qty >= 0

  • @dataclass class FoodItem(Item): expires: date (из datetime.date)
  • @dataclass class ElectronicItem(Item): warranty_months: int = 12
  • @dataclass class Inventory:

- items: list[Item] = field(default_factory=list)

- Методы: add(self, item: Item), find(self, sku: str) -> Item | None, total_value(self) -> float

- Метод expired_food(self, on: date) -> list[FoodItem]

  • Замороженный @dataclass(frozen=True) Money(amount: float, currency: str = "USD"), используемый опциональным price_as_money(item) -> Money
  • Демо: создание смешанных позиций, добавление в инвентарь и подсчёт итогов

Пример:

inv = Inventory()
inv.add(FoodItem("f1", "Milk", 1.5, 2, date(2026, 1, 1)))
assert inv.total_value() == 3.0
↑